一起来看一下成品:
准备工具
工具官网链接:
seedance2.5 https://jimeng.jianying.com/ai-tool/home/
Flowpix https://www.flowpix.club/
Libtv https://www.liblib.tv/
倘若不知道模型怎么使用,可以参考这个教程(https://www.super-i.cn/info-2796.html),与本教程一起使用
如果不想各个网页跳转模型,可以使用flowpix平台,已接入所有热门模型
https://www.flowpix.club/bj/48962.html?token=d021677c711c0037ce87146ca4573278
一、先准备剧本和资产
开始搭建之前,先确定一段完整的剧本。剧本里需要写清楚人物、场景、动作和对白,尤其是谁与谁发生冲突。
剧本如下:
《最后一份遗嘱》
夜晚,英式庄园书房。
壁炉的暖光映着书桌,窗外冷蓝的月光落在地面。桌上的遗嘱已经翻到签字页。
阿什顿坐在书桌后的高背椅上。克拉拉站在他右后侧,手扶椅背。贝内特站在左后侧,端着银色托盘
布莱克坐在桌前左侧,将钢笔放到遗嘱旁。薇薇安站在桌前右侧,目光始终停在克拉拉身上。
阿什顿:“我名下的全部财产,都留给克拉拉。”
克拉拉看向他,没有说话。
布莱克将遗嘱转向阿什顿。老人拿起钢笔。
笔尖即将落下,薇薇安突然俯身,一手按住遗嘱。
薇薇安:“在签字之前,您不问问,她究竟是谁吗?”
阿什顿停笔。
克拉拉看向薇薇安。贝内特端着托盘的双手微微收紧。
布莱克:“肖小姐,你查到了什么?”
薇薇安:“我查过死亡登记。您的女儿,十年前就已经去世了。”
书房安静下来,只剩壁炉燃烧的声音。
阿什顿放下钢笔,转头望向布莱克。
阿什顿:“把照片给她。”
布莱克拿起自然放在腿上轻捏一角旧照片,递给克拉拉。
克拉拉接过照片,低头端详。照片里,一个与她面容相似的年轻女人,怀里抱着婴儿。
她怔了片刻,轻声说:“妈妈……”
阿什顿:“我的女儿确实去世了。”
薇薇安望着他,按在遗嘱上的手慢慢松开。
阿什顿:“但克拉拉,是她留给我的孩子。”
克拉拉缓缓抬头,与老人对视。
阿什顿重新拿起钢笔。
画面切黑。
传来笔尖落在纸上的声音。”
这次的故事发生在庄园书房:阿什顿准备签署遗嘱,将财产留给克拉拉,薇薇安却在签字前质疑她的身份。
根据剧本,准备三类资产:
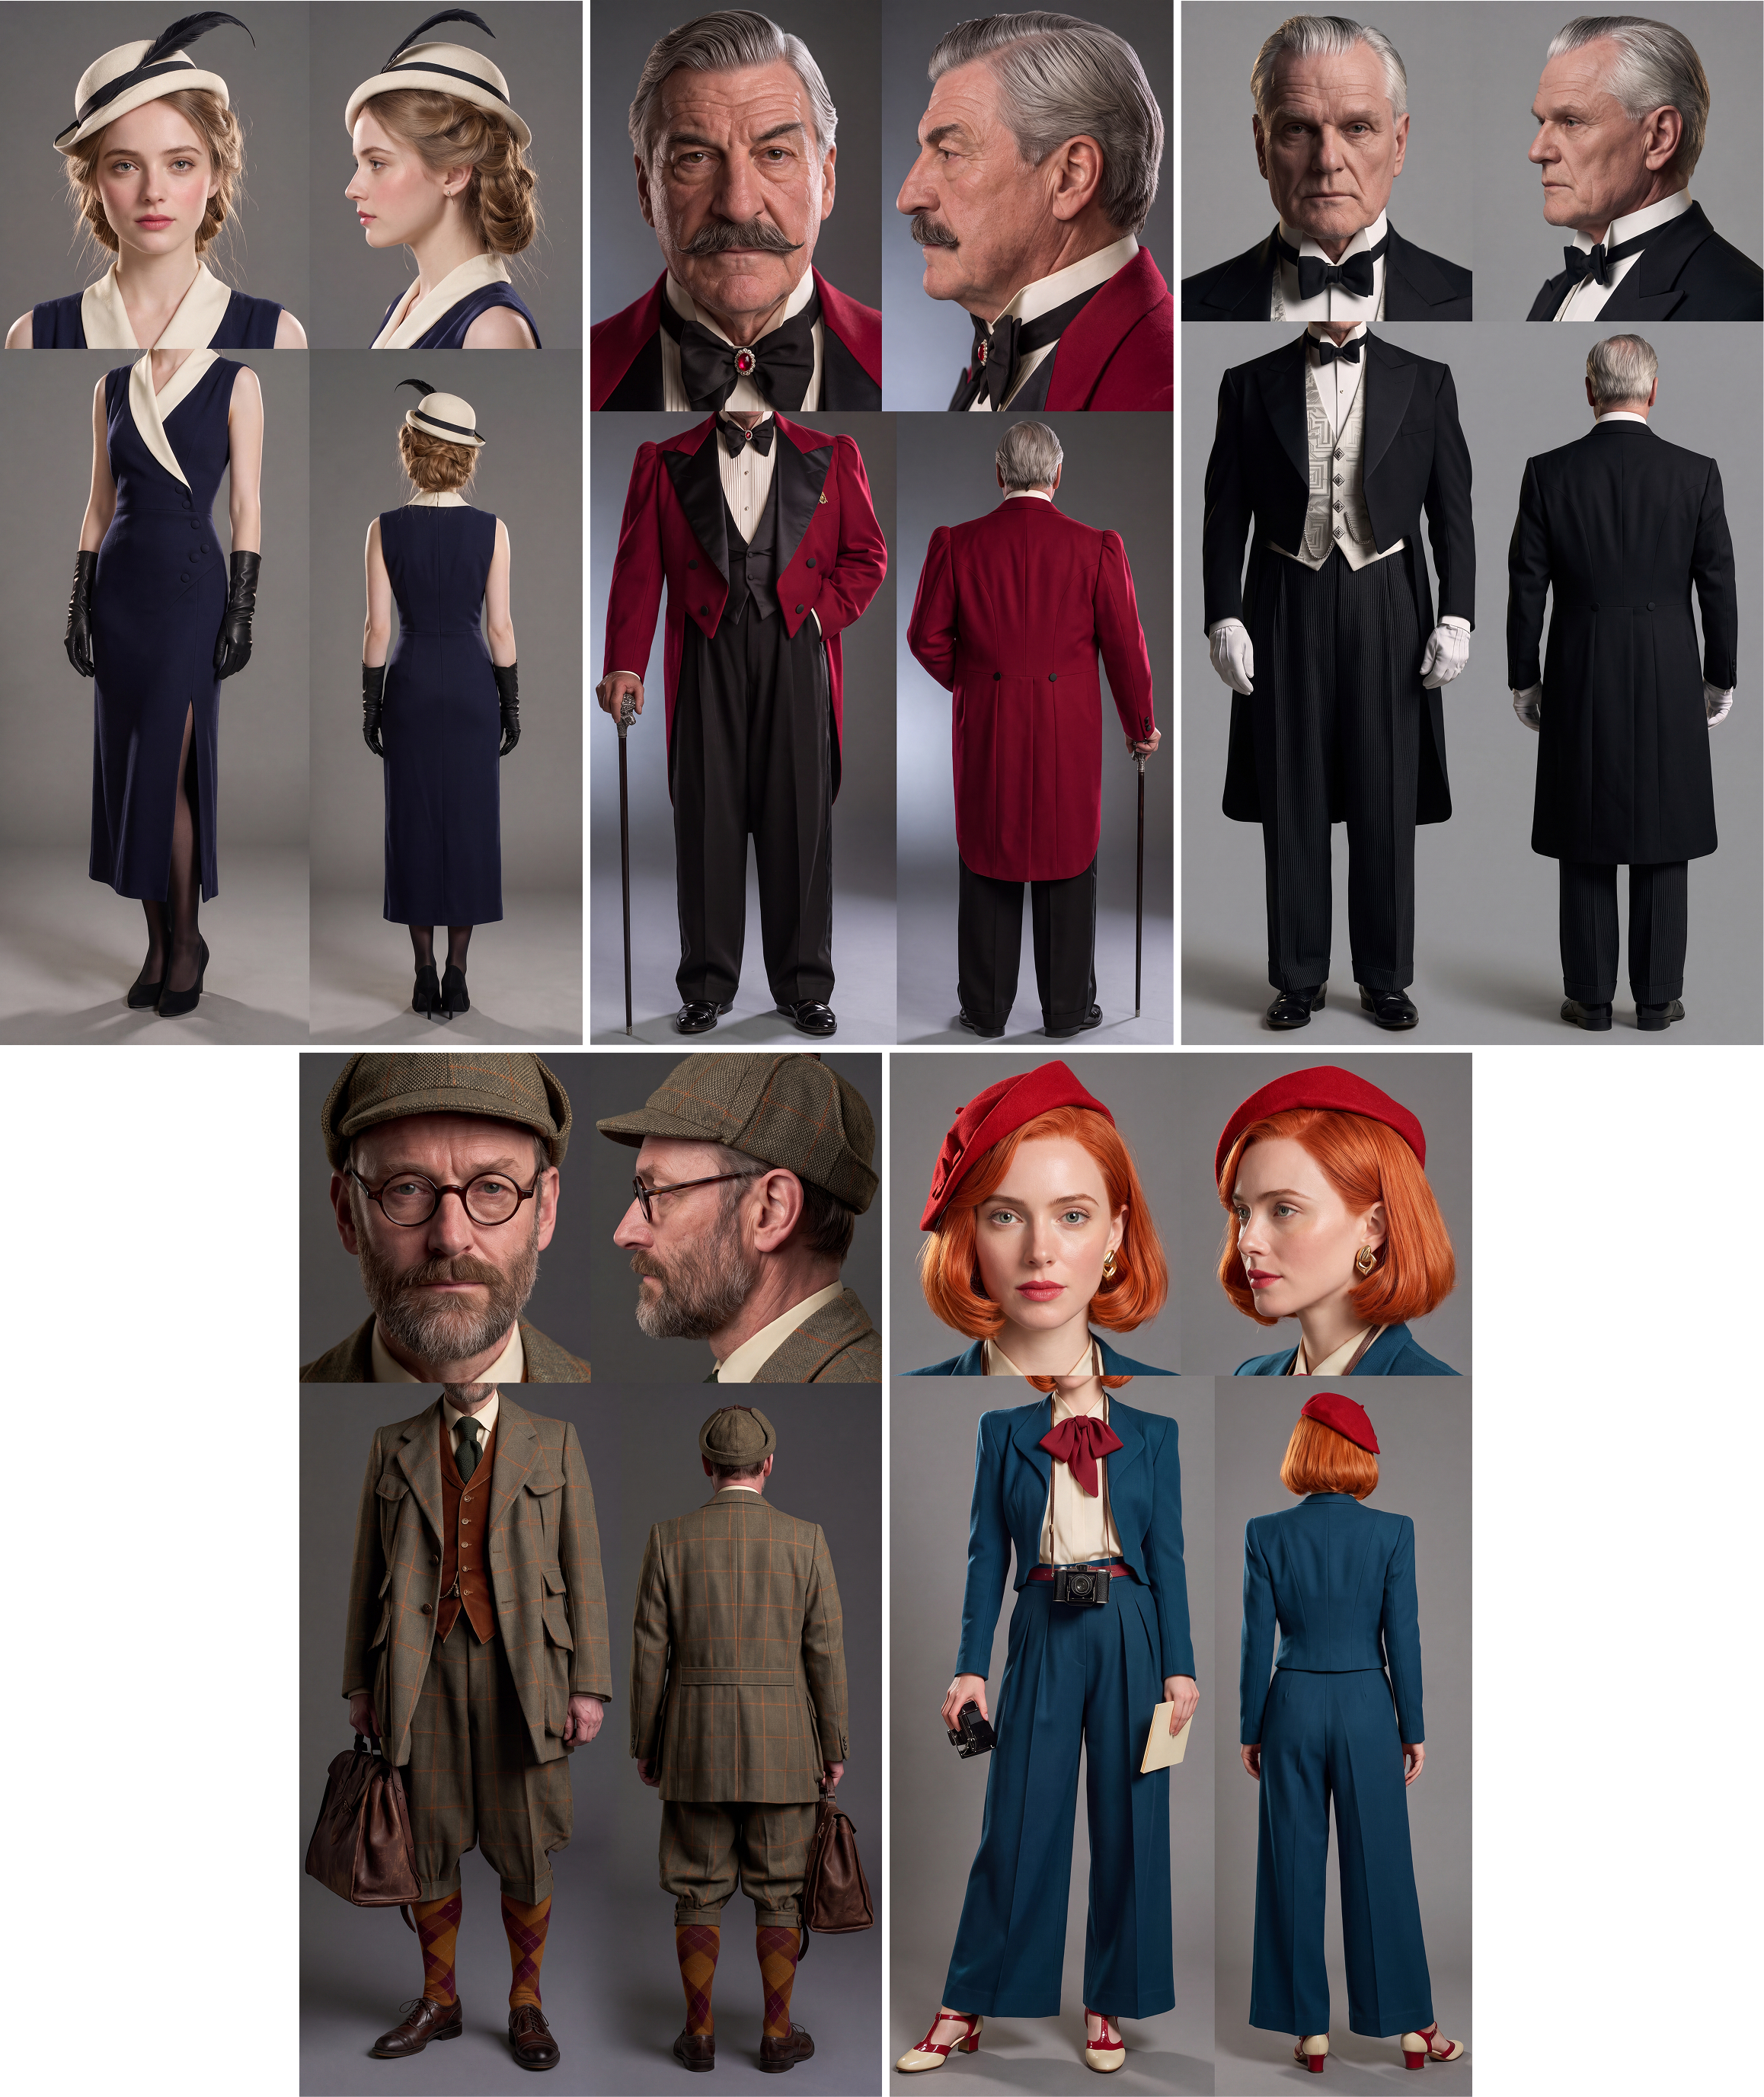
人物:克拉拉、阿什顿、贝内特、布莱克、薇薇安。
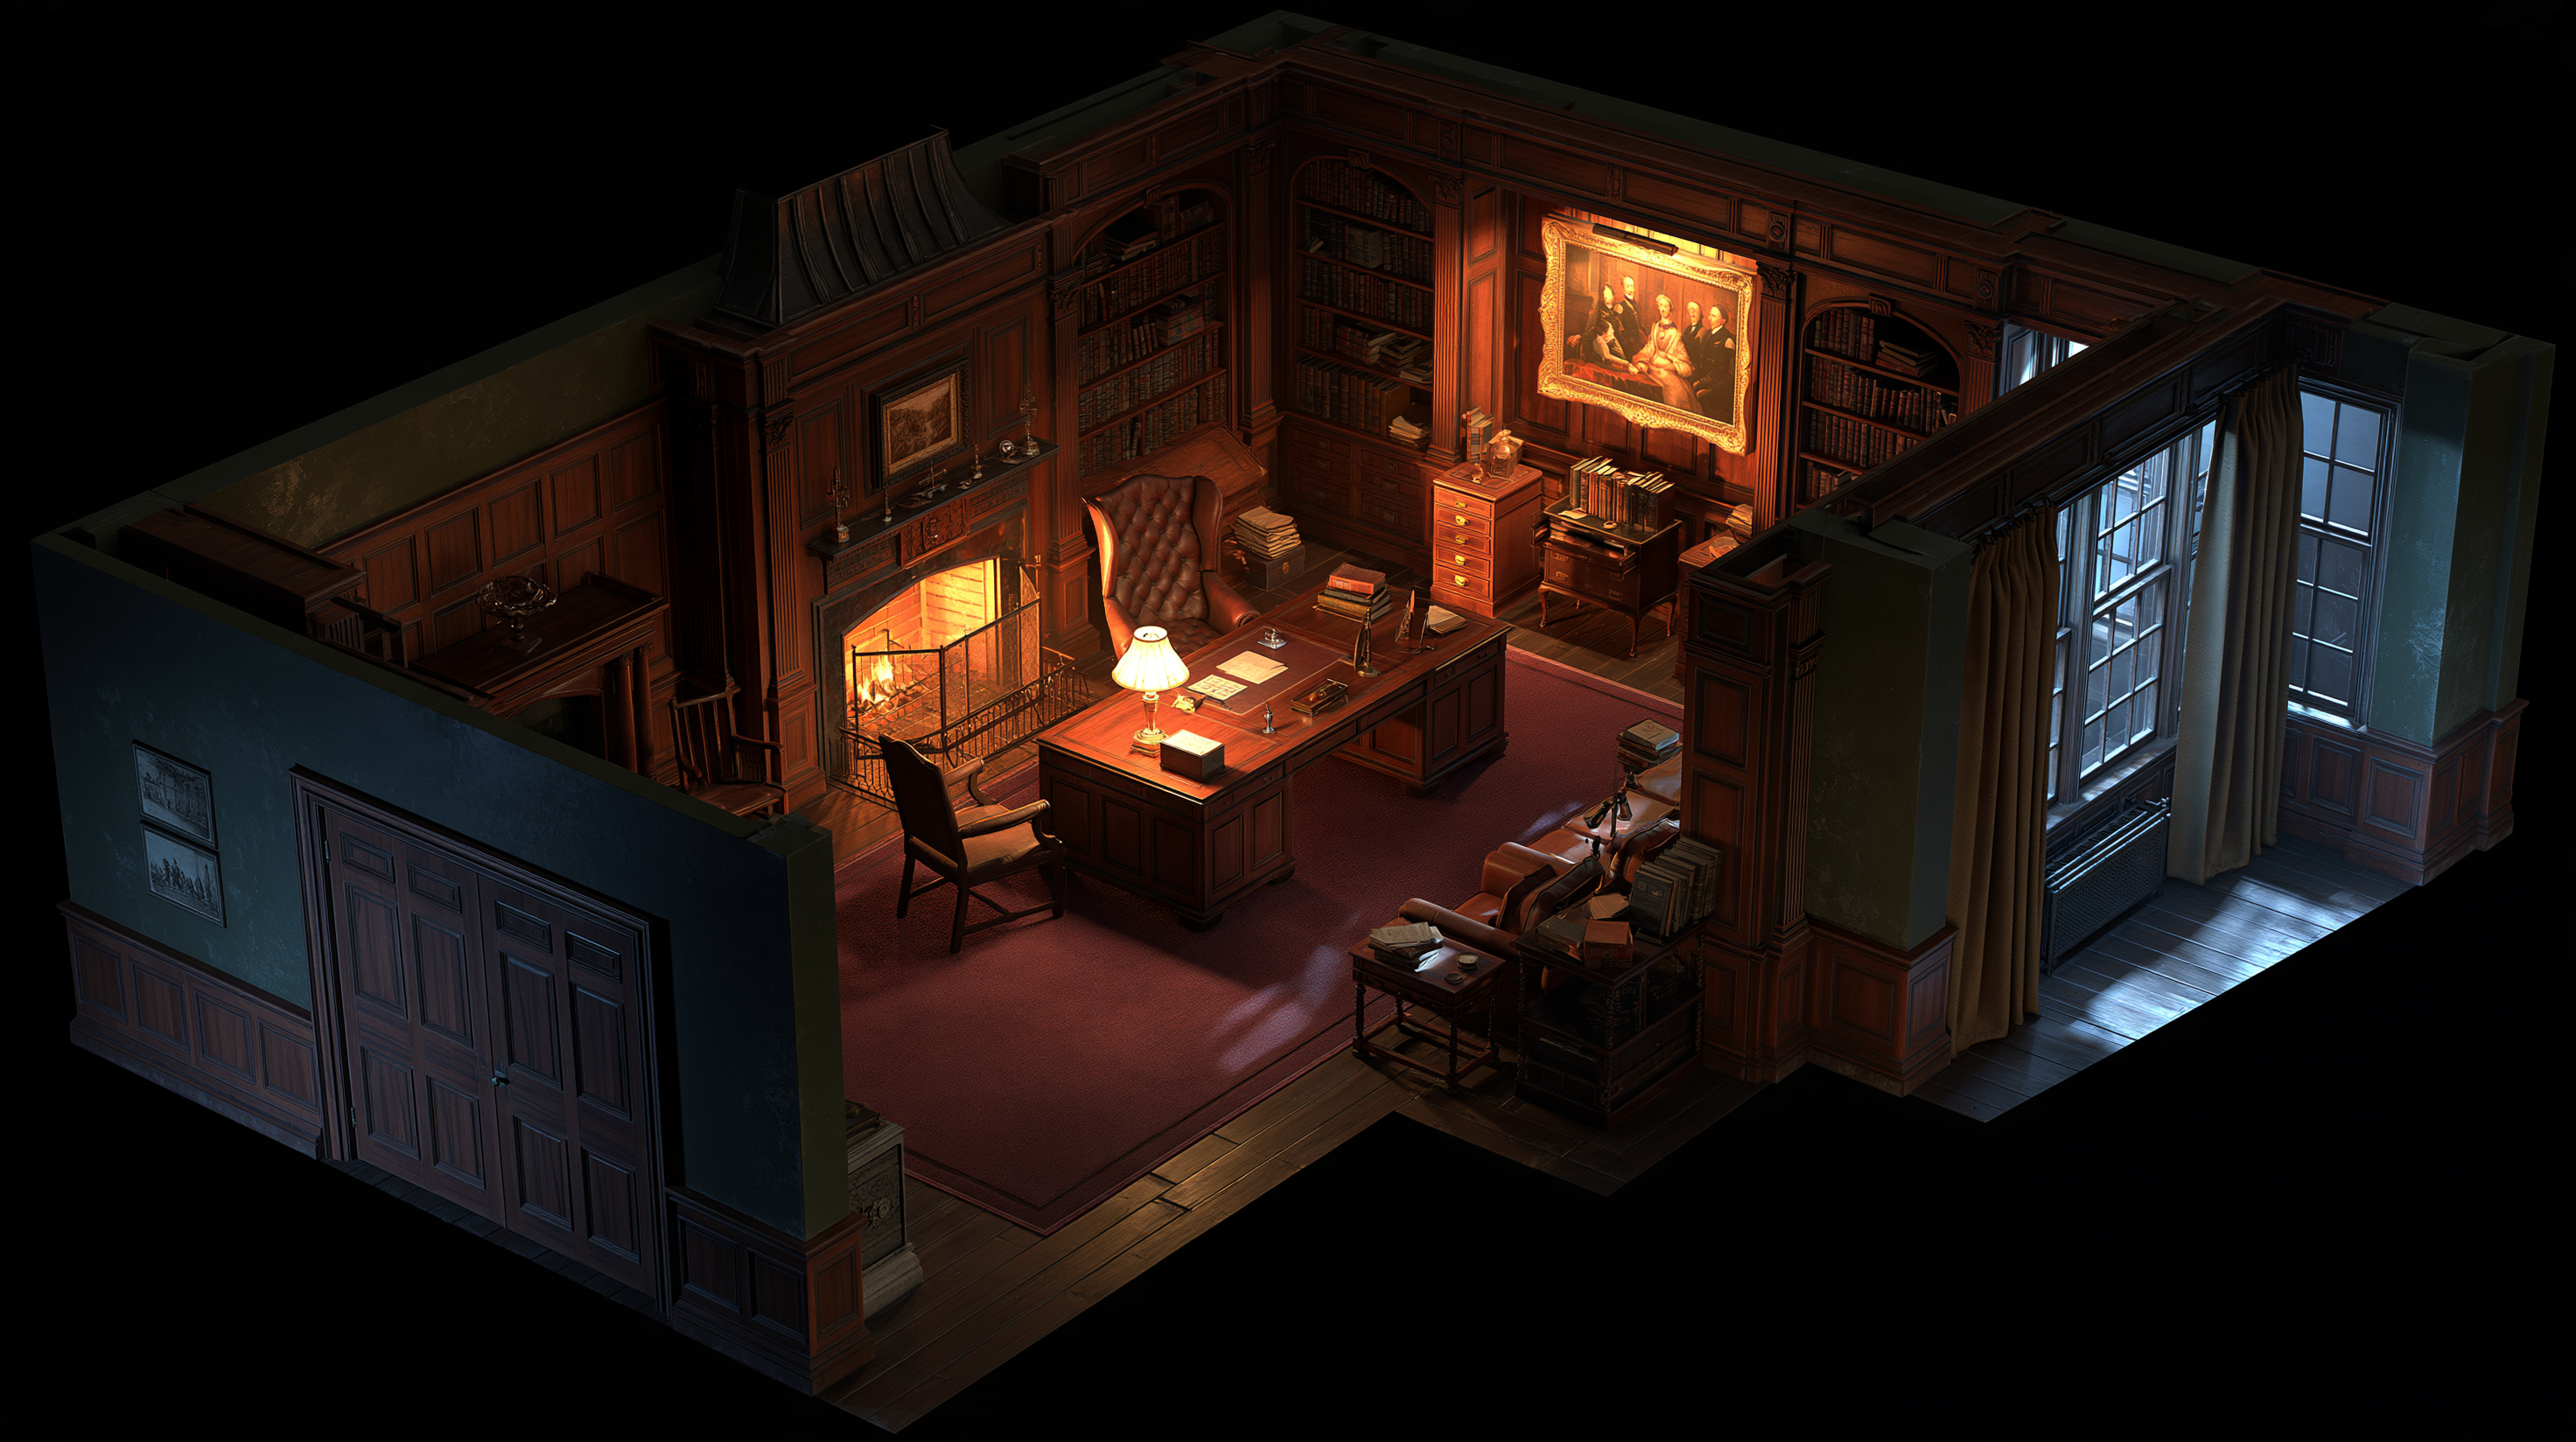
场景:庄园书房。
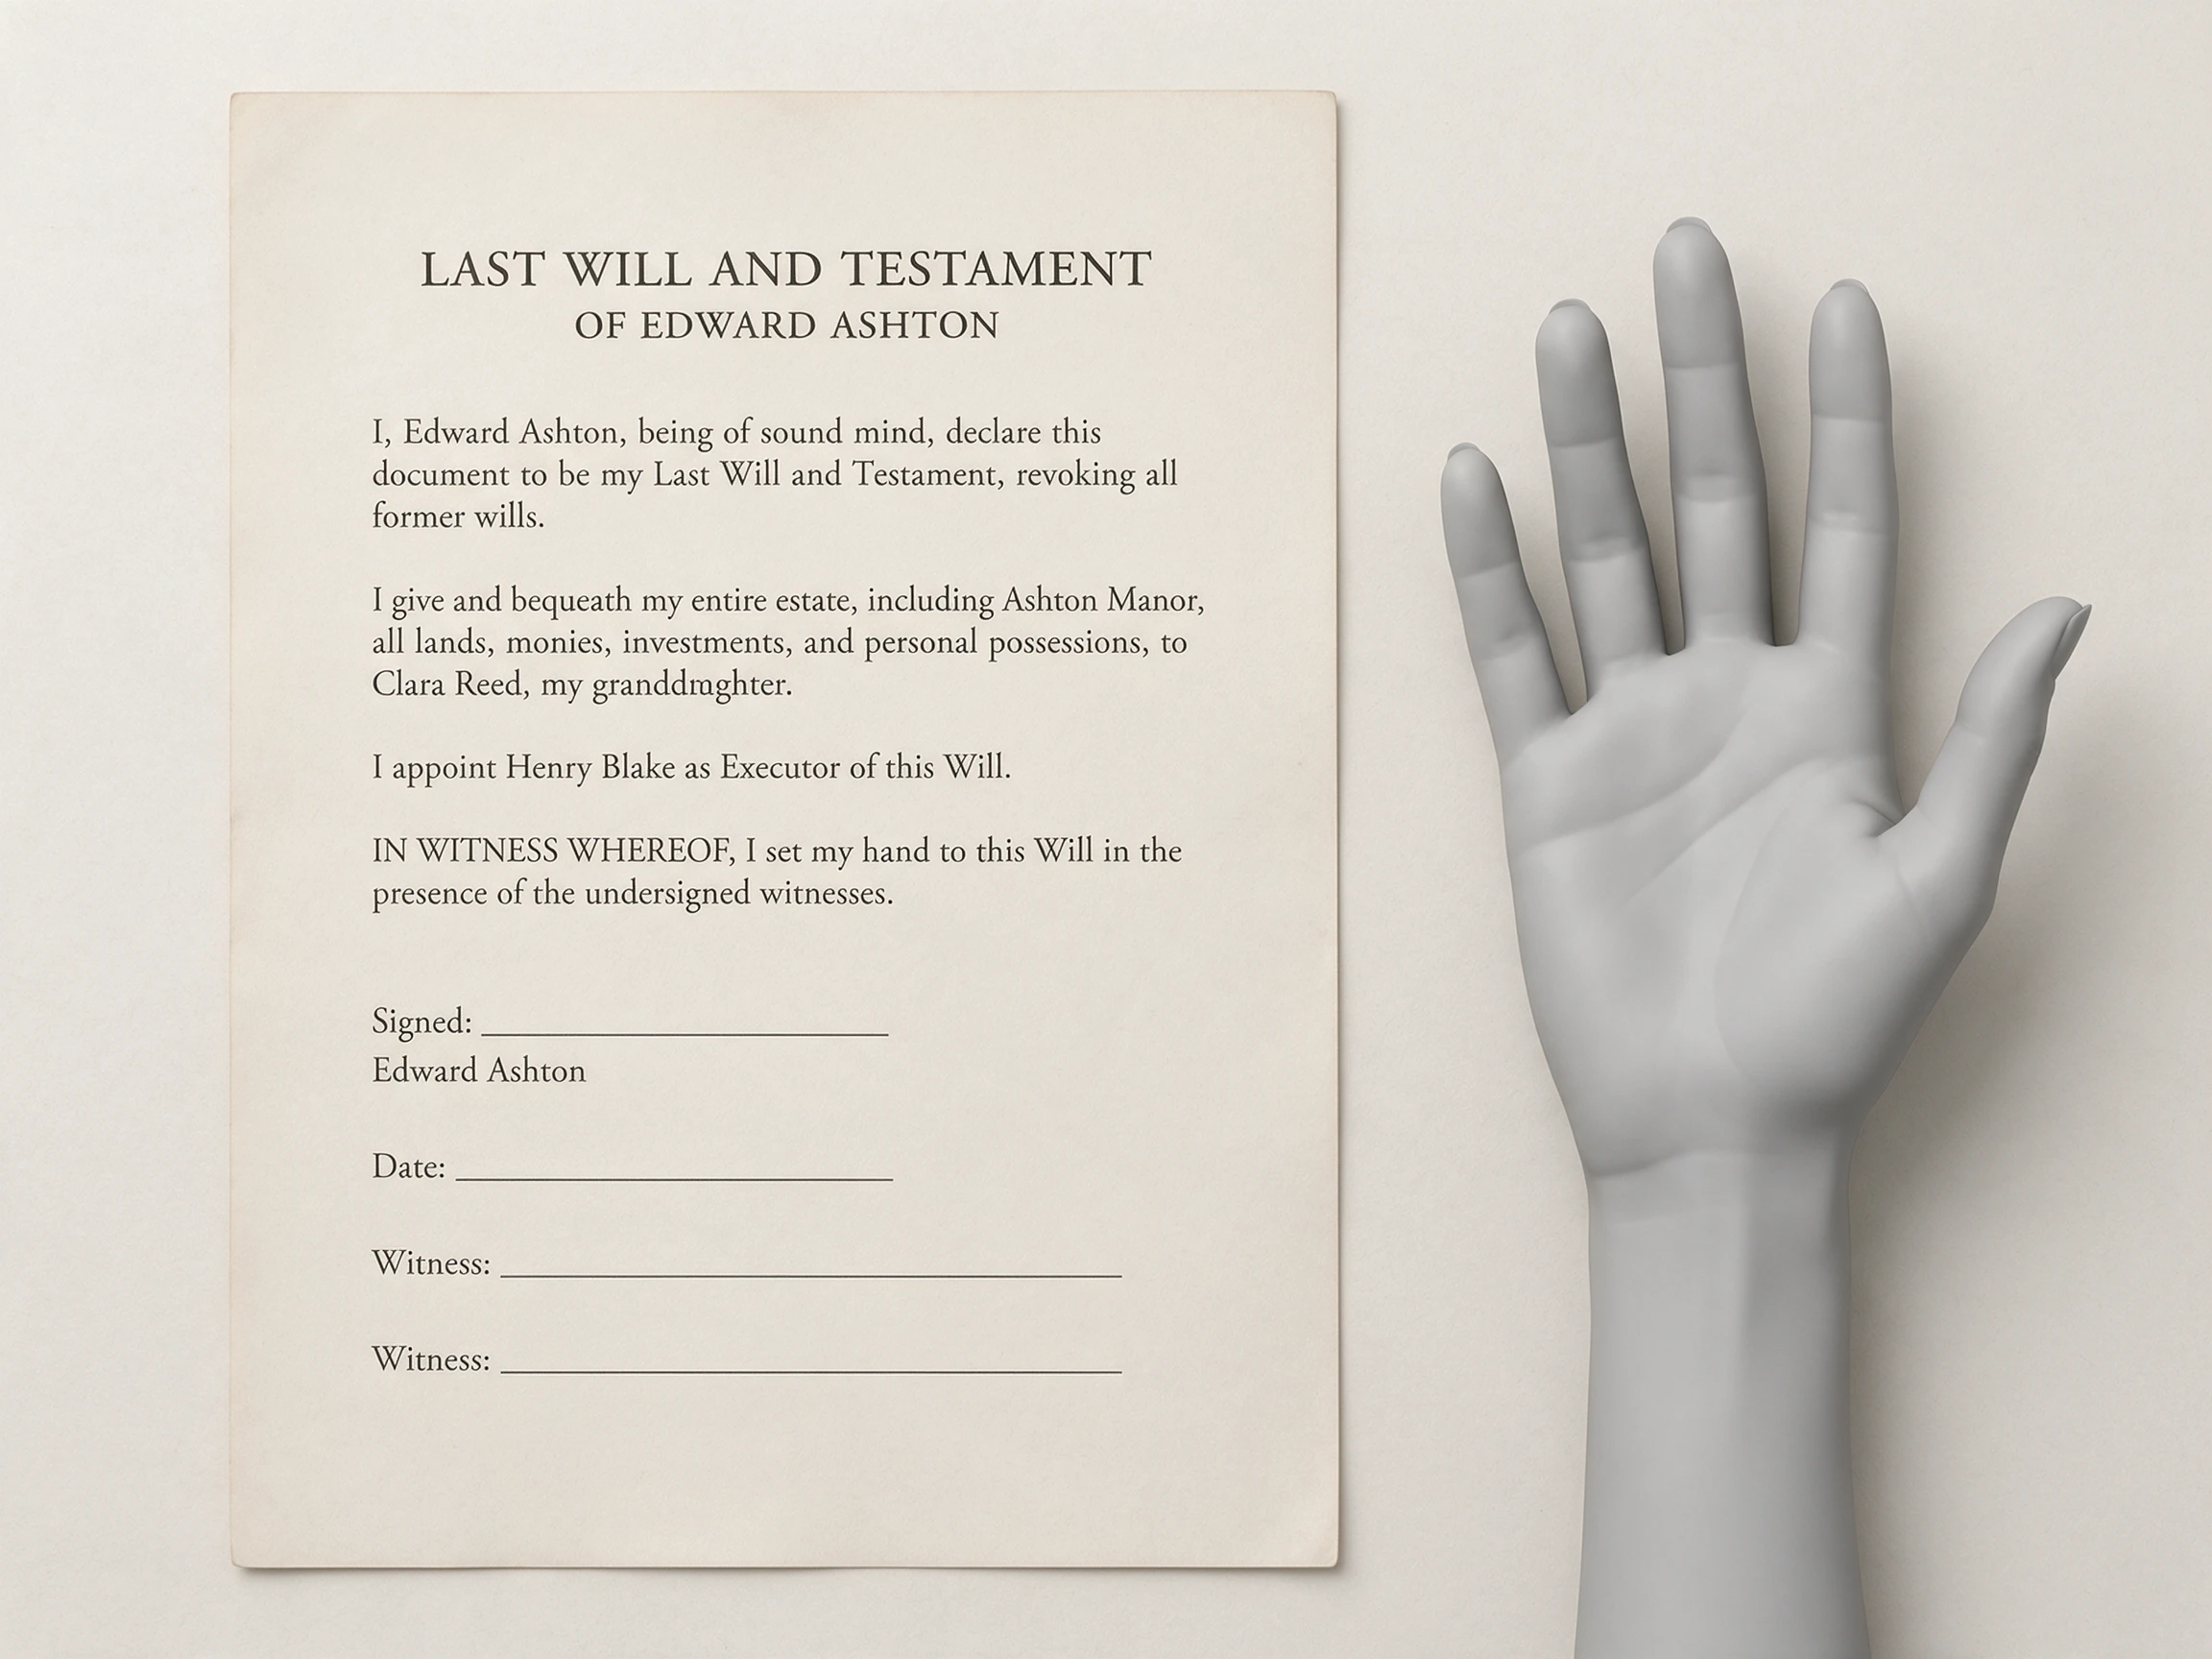
道具:遗嘱、
母婴旧照片
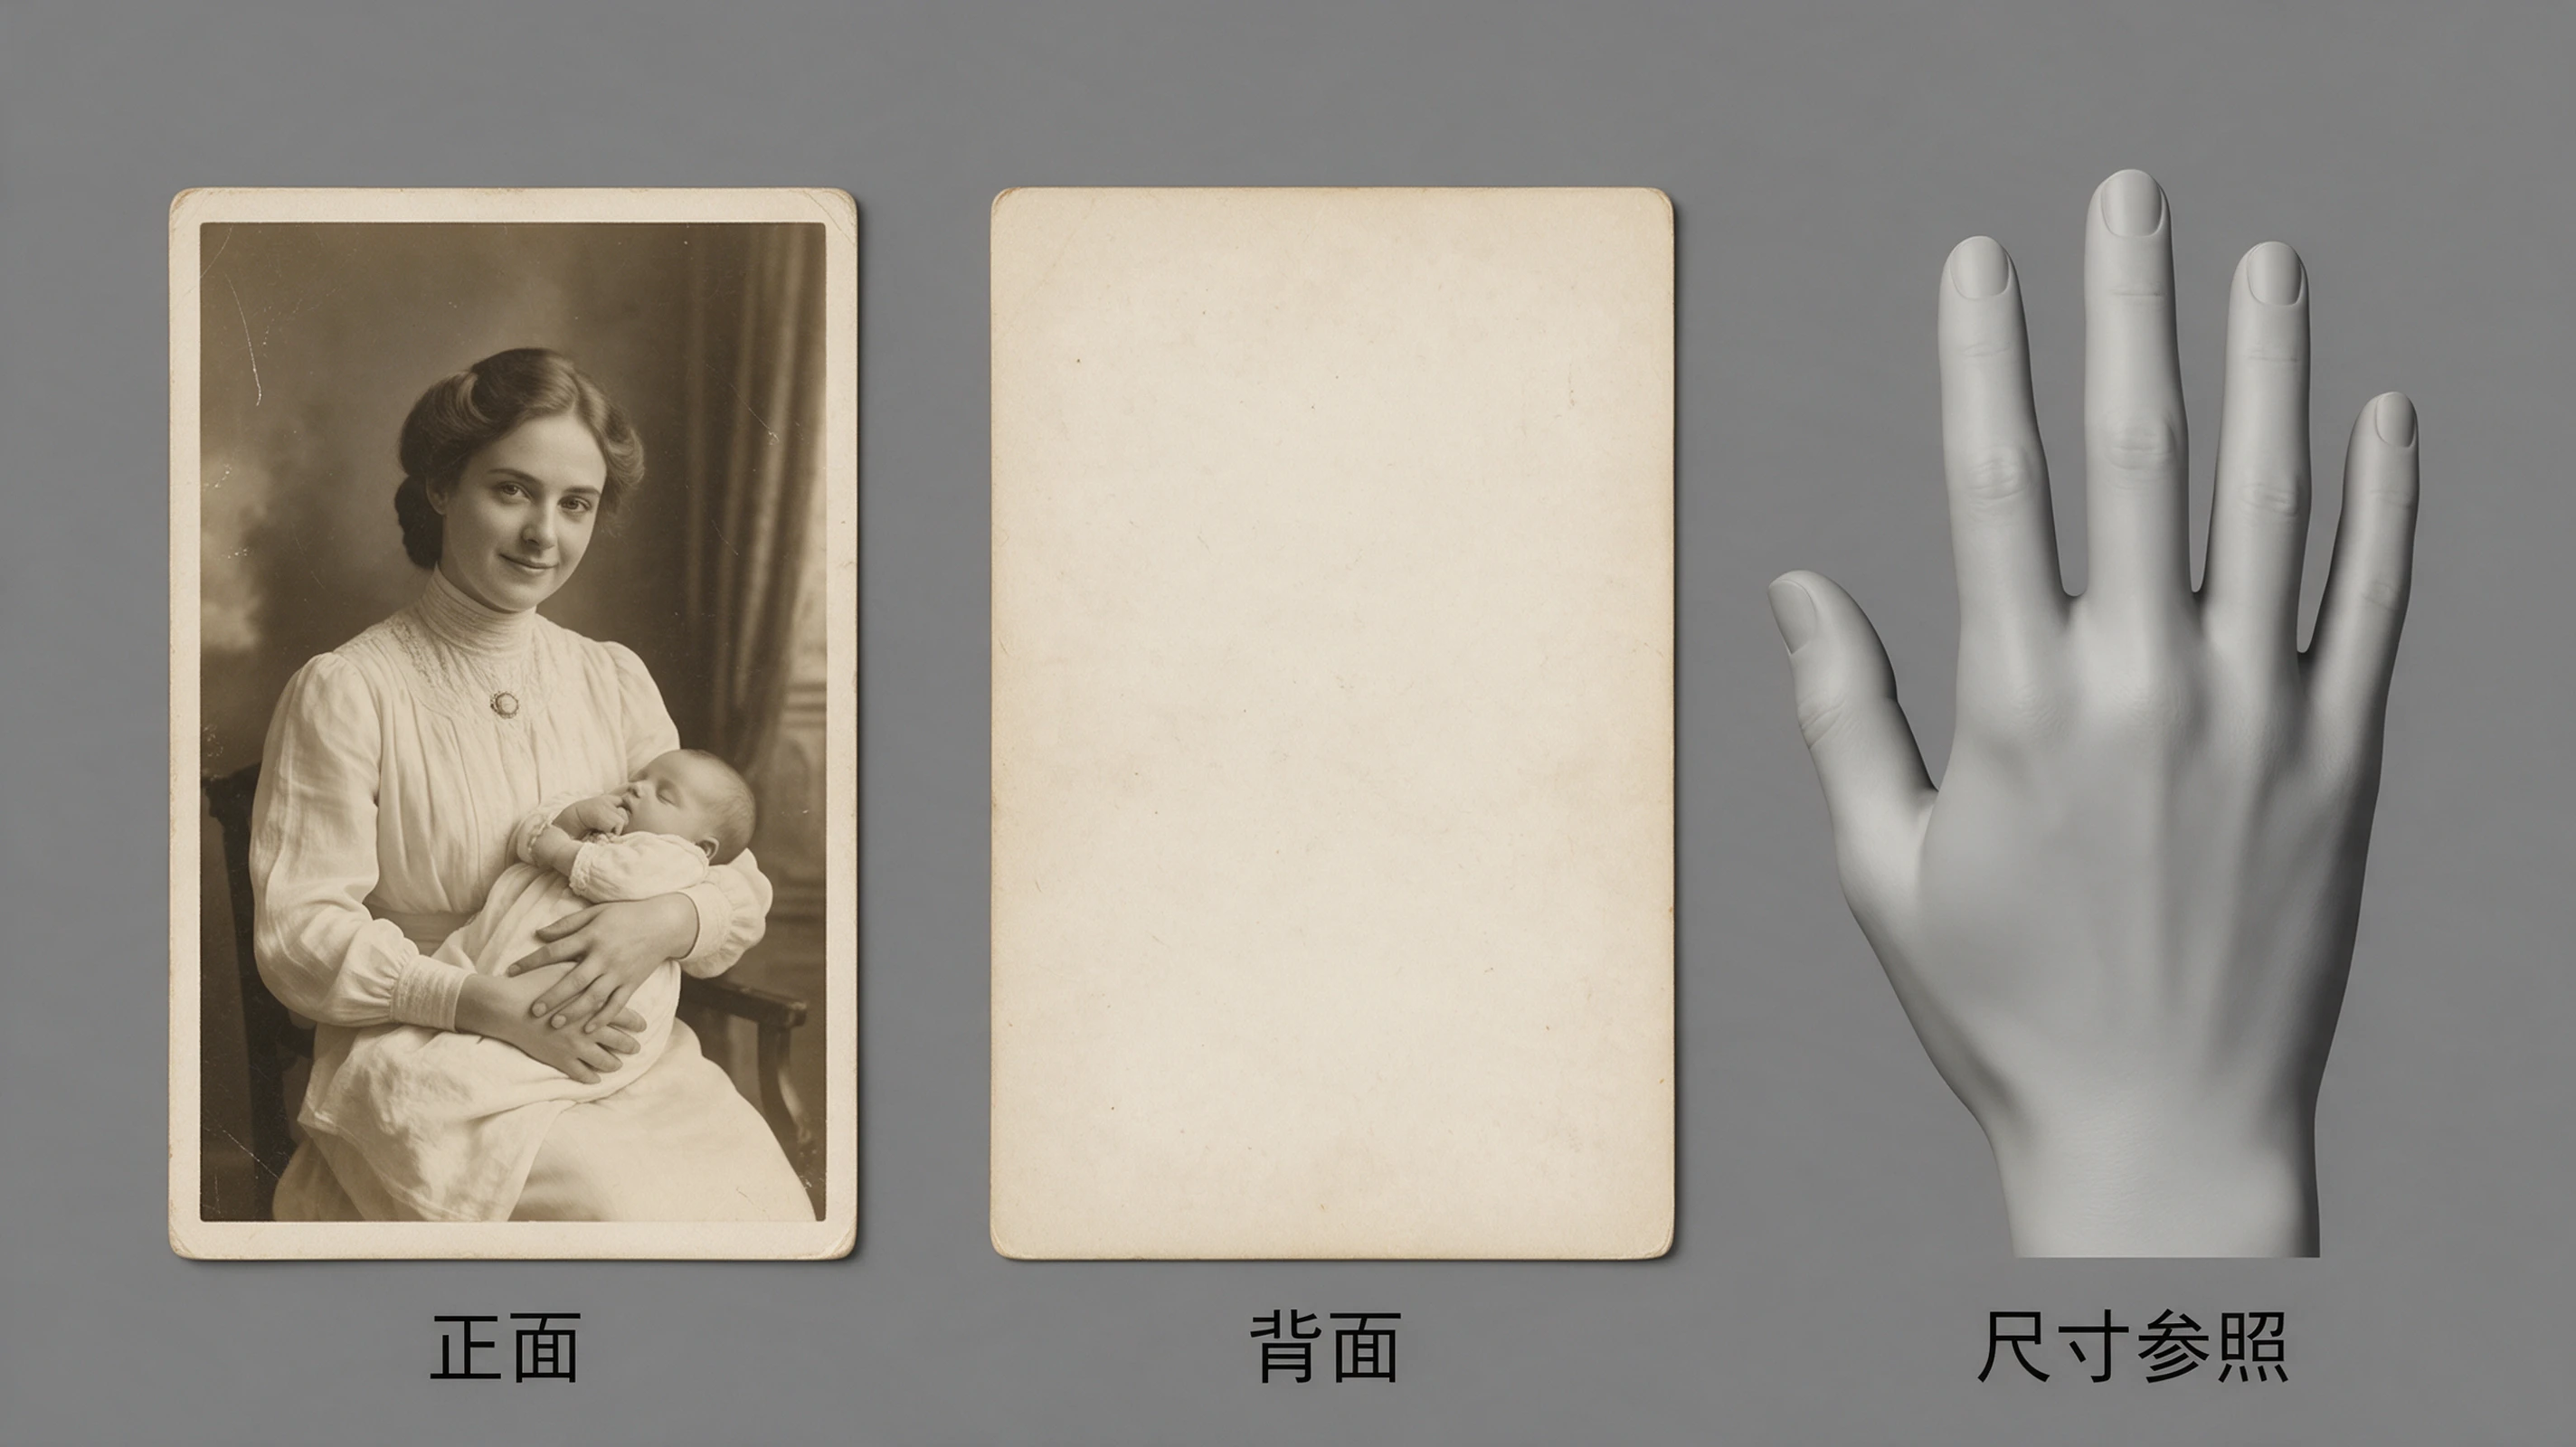
人物资产尽量清楚展示面容和服装。道具如果涉及正反面,也要提前准备,方便后续镜头使用。
二、先生成一张站位参考图
接下来,让 Agent 分析剧本,结合人物和场景资产,写出多人站位的图片提示词。
我是这样说的:
按照从图一到图五的人物,将其摆放在图六的场景中,要符合下面剧本描述的站位。你给我图片提示词。<剧本>
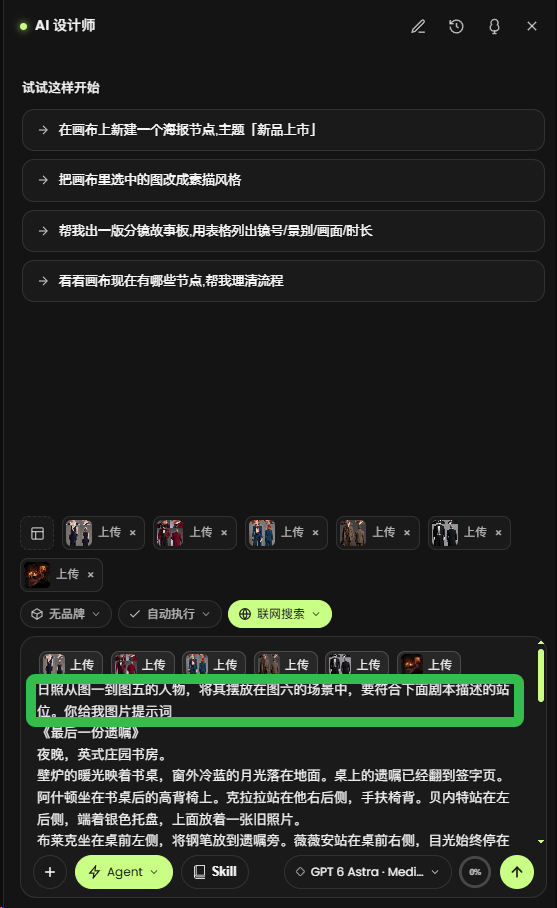
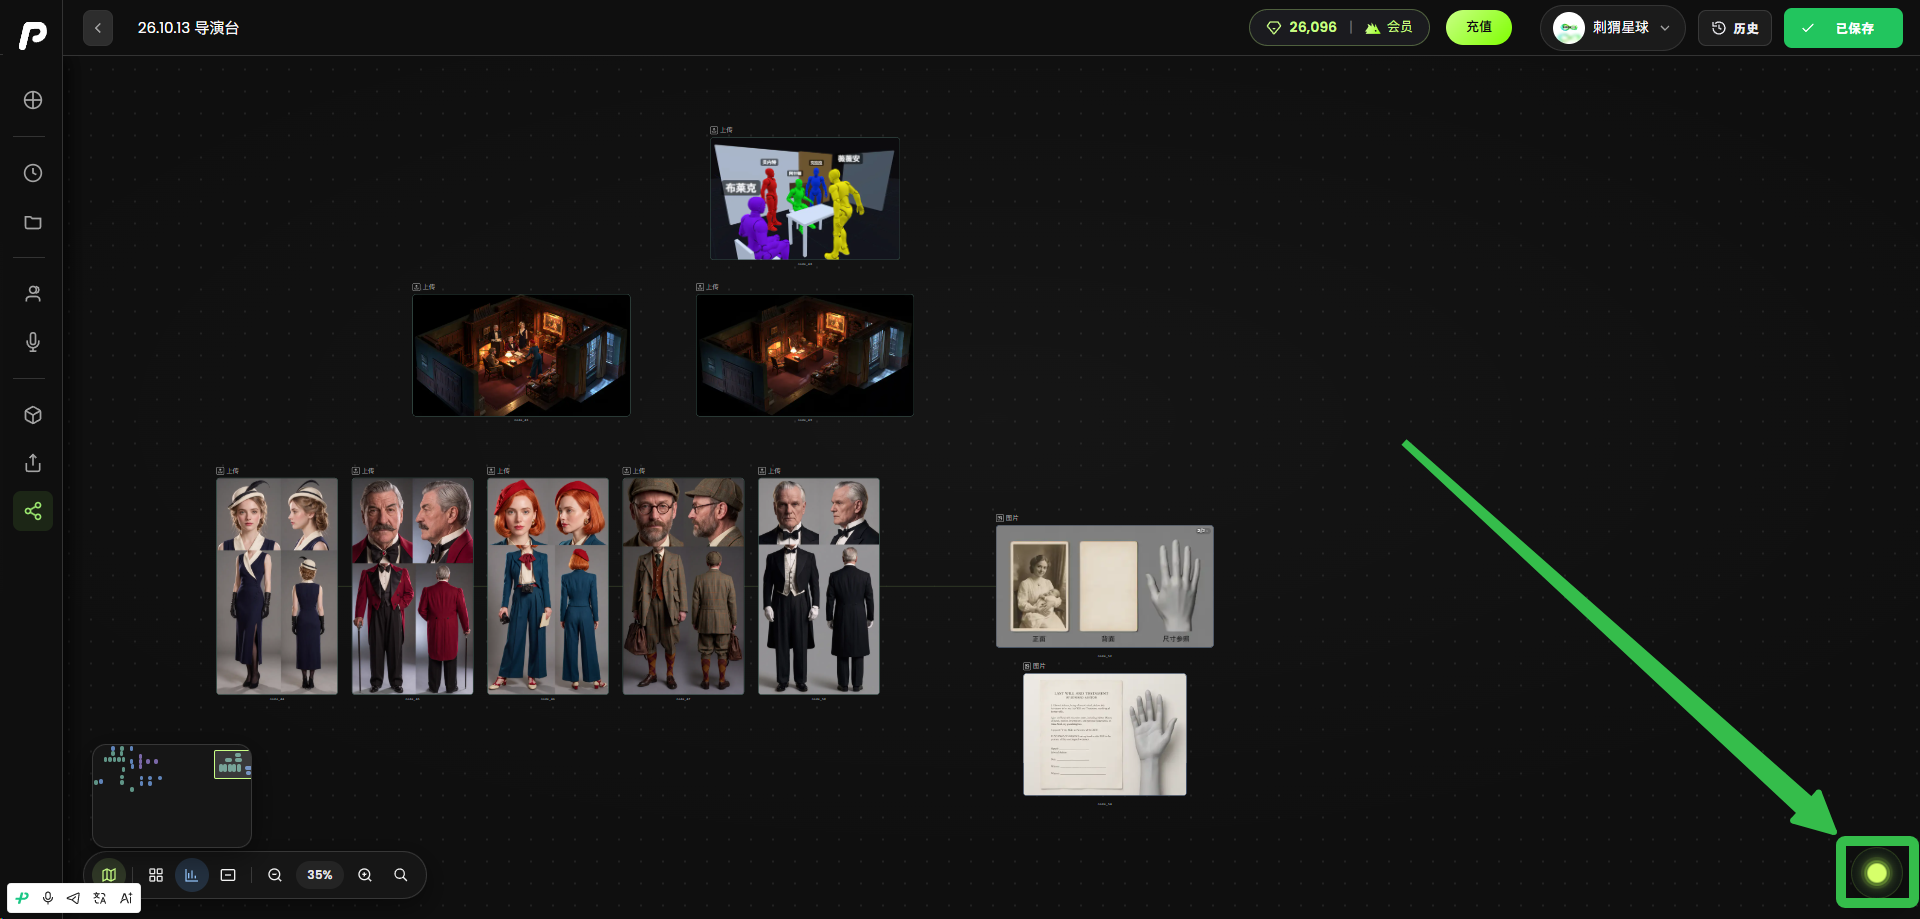
flowpix中的Agent功能,点击画布的右下角打开
Agent会帮你直接推导出图片站位的提示词,然后使用GPT的图片模型进行生成
站位提示词如下:
以图六为唯一场景参考,将图一至图五中的五名人物融入同一间英式庄园书房,制作《最后一份遗嘱》的开场群像场景图。
【参考图与角色对应】
图一:克拉拉,保留参考图中的面容、发型、米白色黑羽毛礼帽、藏青色无袖连衣裙、米白色不对称翻领和黑色长手套。
图二:阿什顿,保留参考图中的老年面容、灰白头发、翘八字胡、酒红色礼服外套、黑色马甲和领结。
图三:薇薇安,保留参考图中的面容、橘红色短发、红色贝雷帽、孔雀蓝套装、米白衬衫与酒红色蝴蝶结,复古相机自然垂挂胸前,双手不再拿相机或本子。
图四:布莱克,保留参考图中的中老年面容、圆框眼镜、灰棕络腮胡、格纹帽、橄榄棕粗花呢套装及怀表链,手提包放在座椅旁地面。
图五:贝内特,保留参考图中的老年面容、后梳银灰短发、黑色燕尾服、银白色提花马甲及白手套。
每张人物参考图中的多个视角都是同一个人,最终画面每名角色仅出现一次,总共恰好五人,不复制参考图中的多视图排版。
【场景与构图】 保留图六原有的英式古典书房空间、等距斜俯视剖面构图、黑色外部背景,以及深色木质书桌、高背皮椅、壁炉、满墙书架、古典油画、落地窗、厚重窗帘、沙发等主要陈设的相对位置。不要镜像房间,不重新设计室内布局。 以书桌为叙事中心,五人自然围绕书桌分布。书桌后侧是高背椅所在的一侧,书桌前侧是来客所在的一侧;以下左、右均以最终画面左右为准。让人物面部、手部、遗嘱和银托盘清晰可辨,人物之间适度错位,避免相互遮挡。
【人物站位与定格动作】 阿什顿坐在书桌后方中央的高背椅上,身体朝向桌前,姿态端正而略显衰老,神情威严、平静,嘴唇微启,仿佛刚宣布将全部财产留给克拉拉。双手自然靠近桌面,此刻尚未拿起钢笔。
克拉拉站在阿什顿右后侧,即画面中高背椅的右后方,靠近椅背但不遮挡老人。一只戴黑色长手套的手轻扶椅背,头微微转向阿什顿,安静地看着他,表情克制,带有轻微不安。
贝内特站在阿什顿左后侧,即画面中高背椅的左后方,与克拉拉分居高背椅两侧。身体挺直,双手戴白手套,在腰腹前平稳端着一只银色托盘。托盘略微朝镜头倾斜,上面放着一张边缘泛黄的旧照片,照片仍留在托盘中,尚未递出。
布莱克坐在书桌前方左侧的来客椅上,与阿什顿隔桌相对,身体朝向桌面,脸部呈可辨认的侧面或四分之三侧面。一只手正将钢笔轻放在遗嘱旁,手指动作自然明确,另一只手自然扶在桌沿附近,神情专业而严肃。
薇薇安站在书桌前方右侧,与布莱克分居桌前两侧。身体略朝书桌,头和眼睛明确转向后方的克拉拉,目光锐利、审视、带着怀疑。保持站立,尚未俯身,尚未伸手按住遗嘱,不看镜头。
【关键道具】 桌面中央偏向阿什顿的位置放置一份已经翻到签字页的遗嘱,纸张泛米黄色,可见正文排版和底部尚未签署的签名横线,不要求生成可读长文。钢笔位于遗嘱旁、布莱克正在放笔的位置。 旧照片只出现在贝内特的银色托盘里,照片内容隐约可见一位抱着婴儿的年轻女人;不要将照片另做成画面插图或放大特写。
【光线与质感】 夜晚。壁炉的暖橙色火光照亮书桌、人物面部和衣料,窗外冷蓝色月光穿过落地窗落在地板与人物轮廓上,保持图六的冷暖光源方向。 五个人物与环境使用统一的写实三维电影渲染质感,人物比例严格匹配家具尺度。坐姿有真实的椅面接触,站姿脚底贴合地面,脚下有接触阴影;手扶椅背、手握托盘、放置钢笔的接触关系准确。保留服装细节,但不要产生真人照片贴在模型场景里的拼贴感。 整体氛围庄重、压抑、安静,具有英式庄园悬疑故事的紧张感。
【避免】 不要多余人物、人物重复、角色换脸或服装互换;不要人物三视图、分屏、拼贴、漫画气泡、字幕、标题或水印;不要所有人直视镜头;不要人物悬浮、穿模、手指畸形、托盘倾覆;不要同时表现按住遗嘱、递出照片、接照片与签字等后续动作;不要改变图六的场景布局。
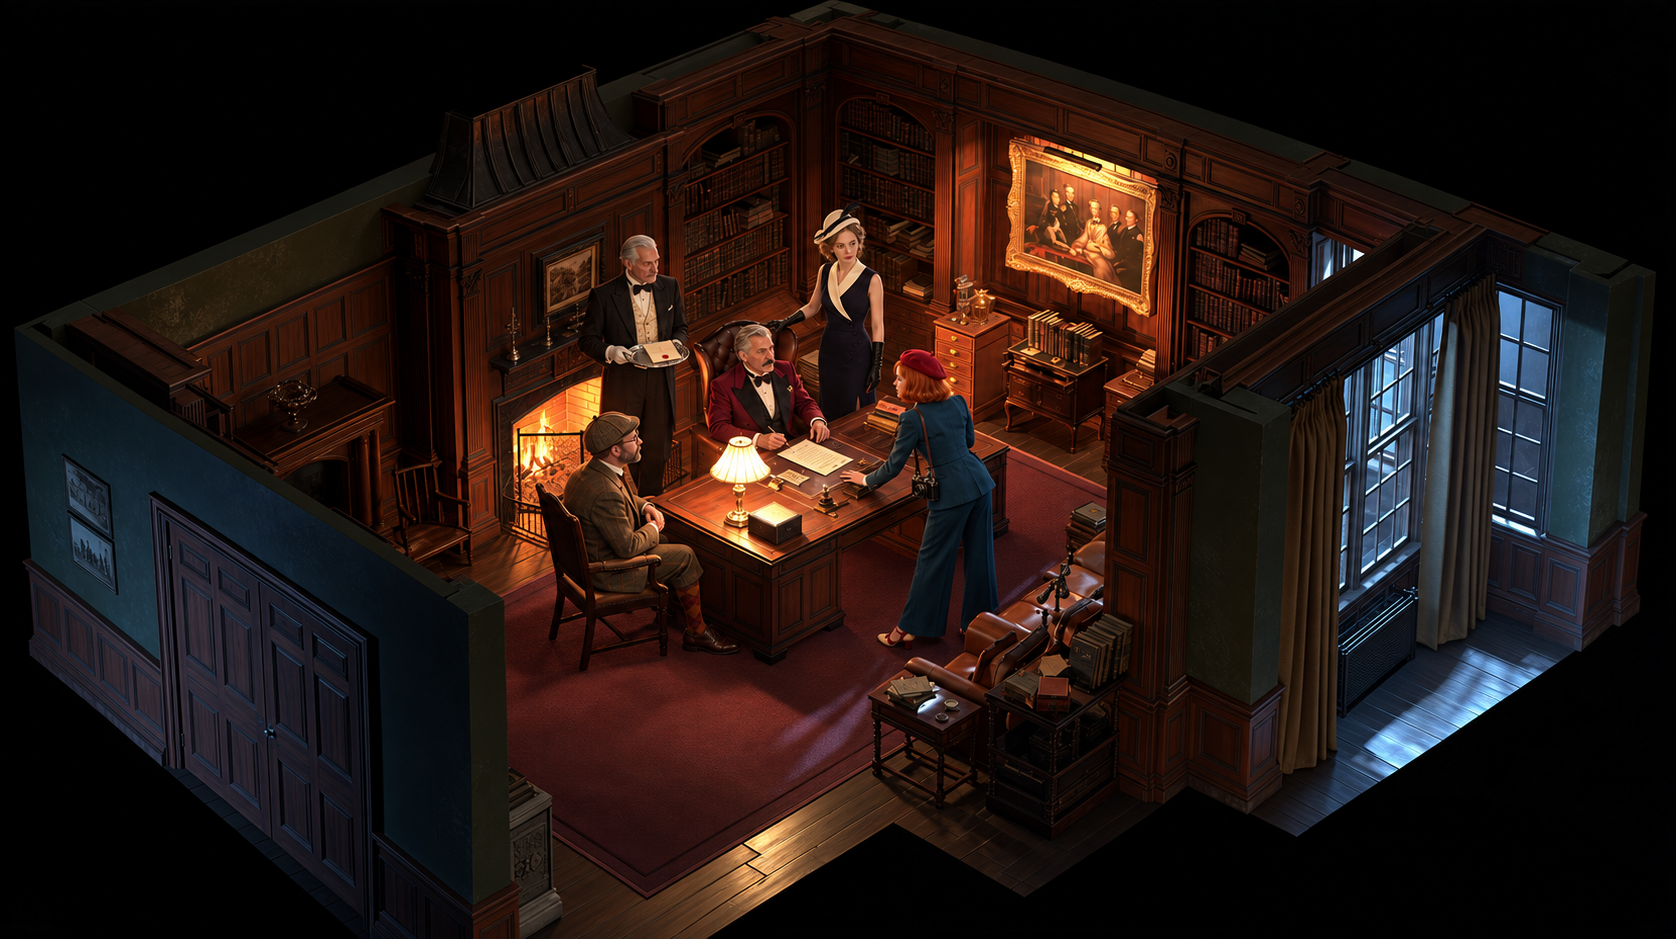
这张图的作用,是先把想要的空间关系表达出来,供导演台搭建时参考。
三、在 LibTV 导演台中还原站位
打开libTV,创建导演台节点,
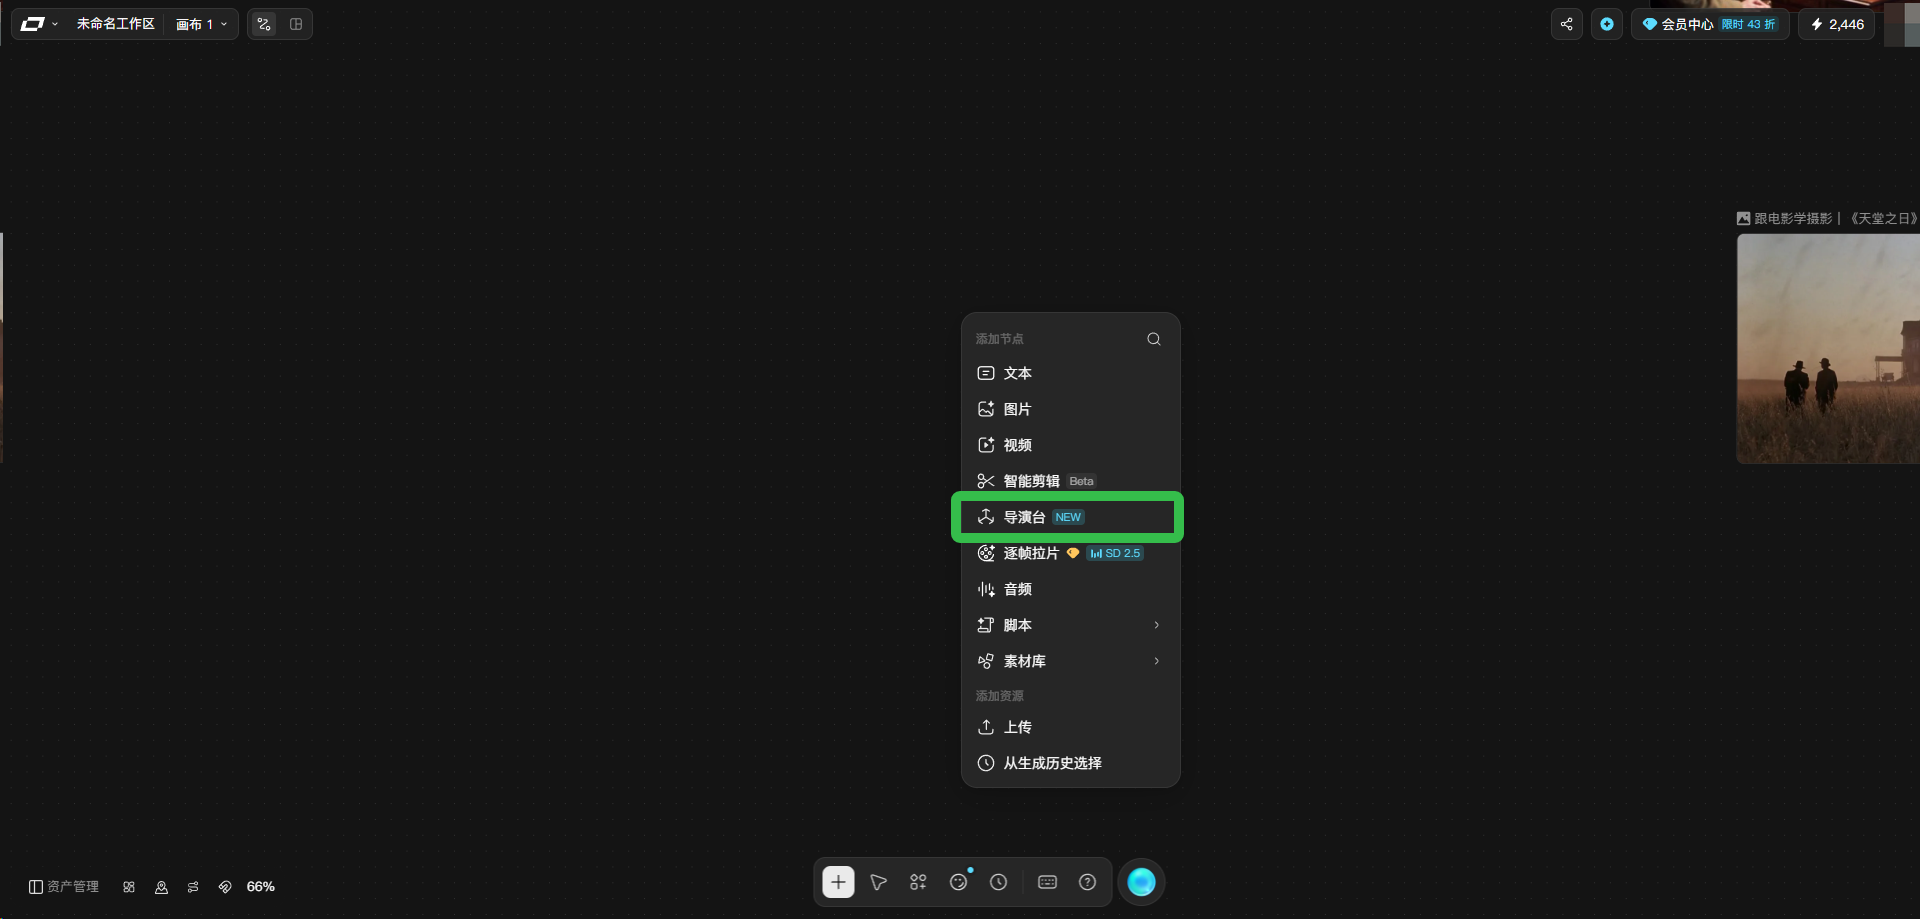
并附上文字说明,让它分析图片中的人物位置和场景结构,创建简单模型。
这里要同时提供图片和文案。图片展示整体关系,文字明确人物身份、位置和朝向,减少理解偏差。
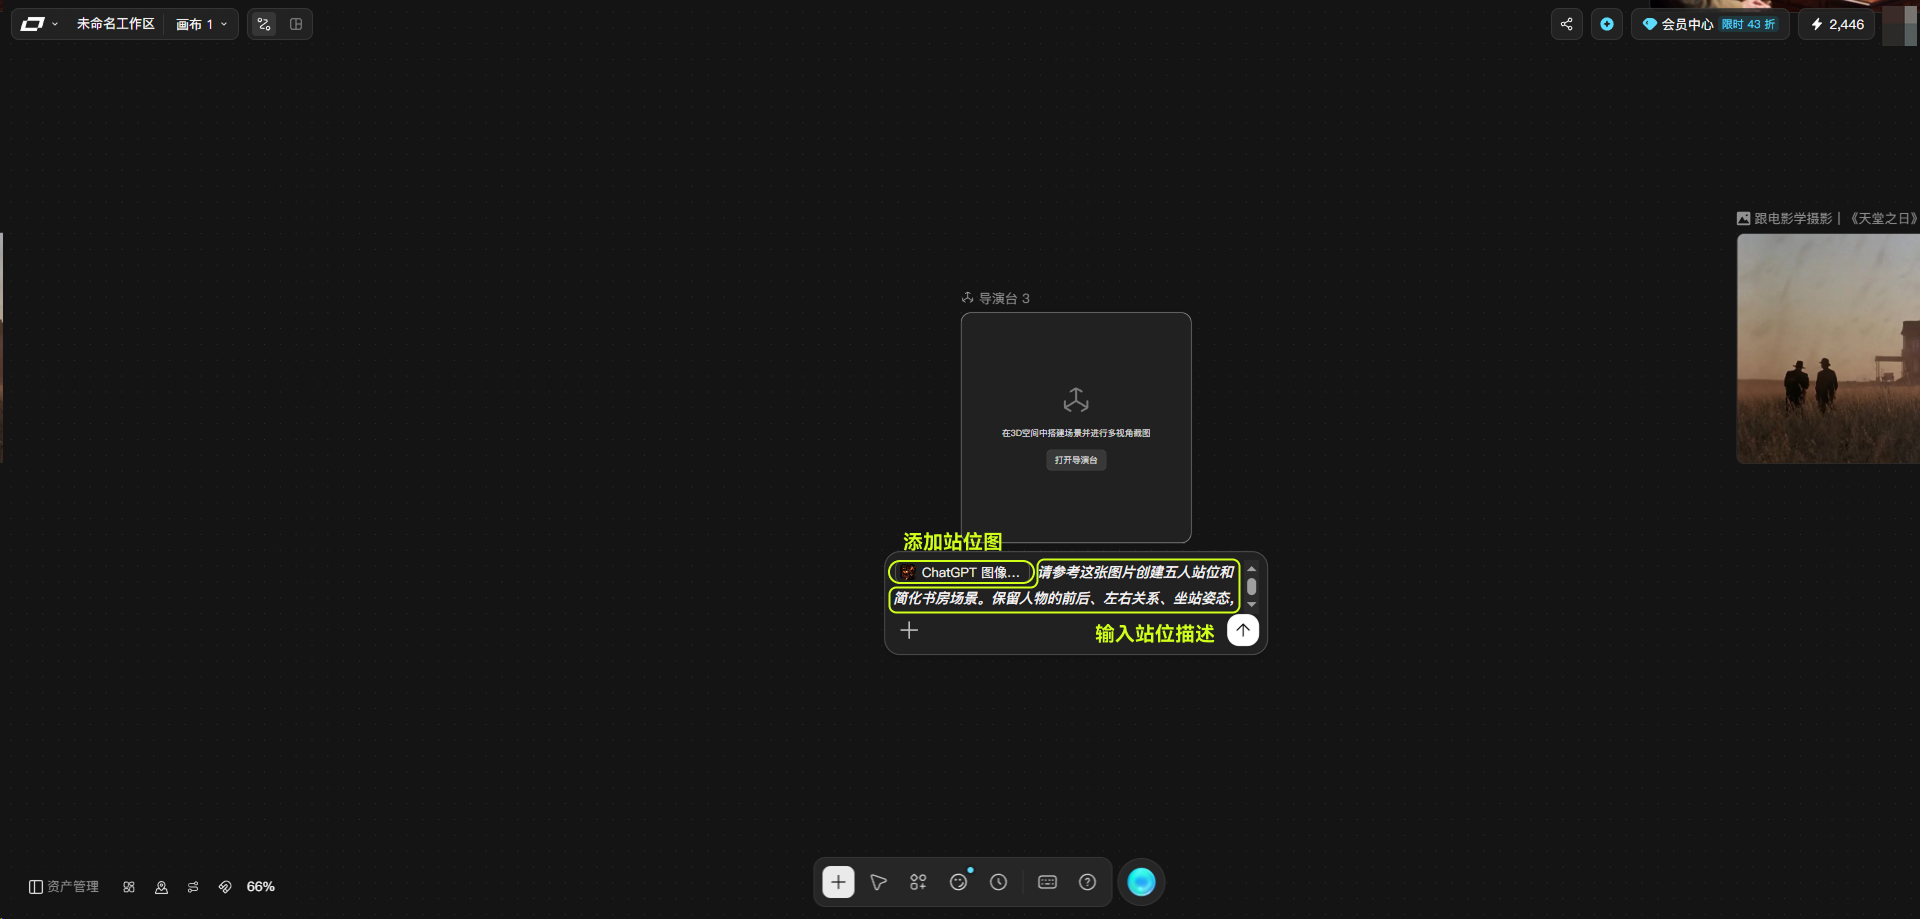
可以使用这样的说明:
请参考这张图片创建五人站位和简化书房场景。保留人物的前后、左右关系、坐站姿态,以及与书桌和椅子的位置关系。人物名称分别为阿什顿、克拉拉、贝内特、布莱克、薇薇安。
站位描述如下(上一步提示词中的站位描述直接复制过来):
阿什顿坐在书桌后方中央的高背椅上,身体朝向桌前,姿态端正而略显衰老,神情威严、平静,嘴唇微启,仿佛刚宣布将全部财产留给克拉拉。双手自然靠近桌面,此刻尚未拿起钢笔。
克拉拉站在阿什顿右后侧,即画面中高背椅的右后方,靠近椅背但不遮挡老人。一只戴黑色长手套的手轻扶椅背,头微微转向阿什顿,安静地看着他,表情克制,带有轻微不安。
贝内特站在阿什顿左后侧,即画面中高背椅的左后方,与克拉拉分居高背椅两侧。身体挺直,双手戴白手套,在腰腹前平稳端着一只银色托盘。托盘略微朝镜头倾斜,上面放着一张边缘泛黄的旧照片,照片仍留在托盘中,尚未递出。
布莱克坐在书桌前方左侧的来客椅上,与阿什顿隔桌相对,身体朝向桌面,脸部呈可辨认的侧面或四分之三侧面。一只手正将钢笔轻放在遗嘱旁,手指动作自然明确,另一只手自然扶在桌沿附近,神情专业而严肃。
薇薇安站在书桌前方右侧,与布莱克分居桌前两侧。身体略朝书桌,头和眼睛明确转向后方的克拉拉,目光锐利、审视、带着怀疑。保持站立,尚未俯身,尚未伸手按住遗嘱,不看镜头。
自动搭建完成后,需要再检查一次。重点看人物是否坐对椅子、身体朝向是否正确、人与桌子的距离是否合适,以及有没有模型重叠。
四、手动调整,再确定拍摄构图
自动搭建出的站位可能存在偏差,可以在导演台里手动调整。
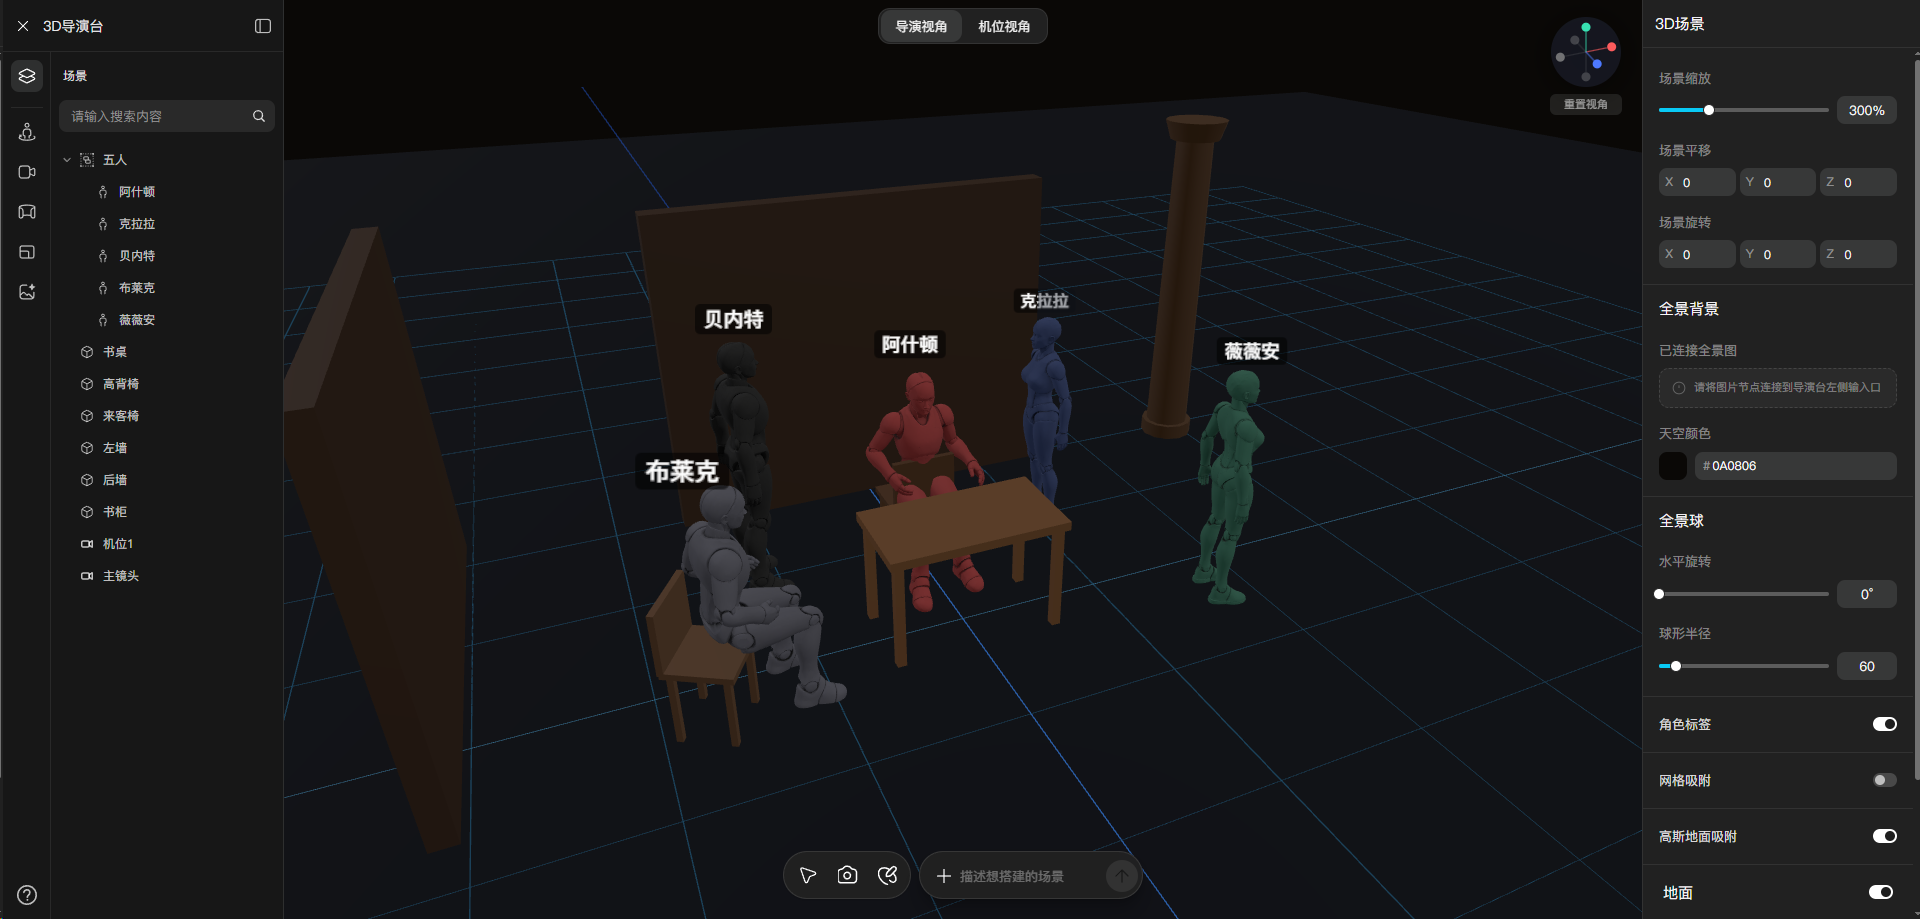
人物会有偏差
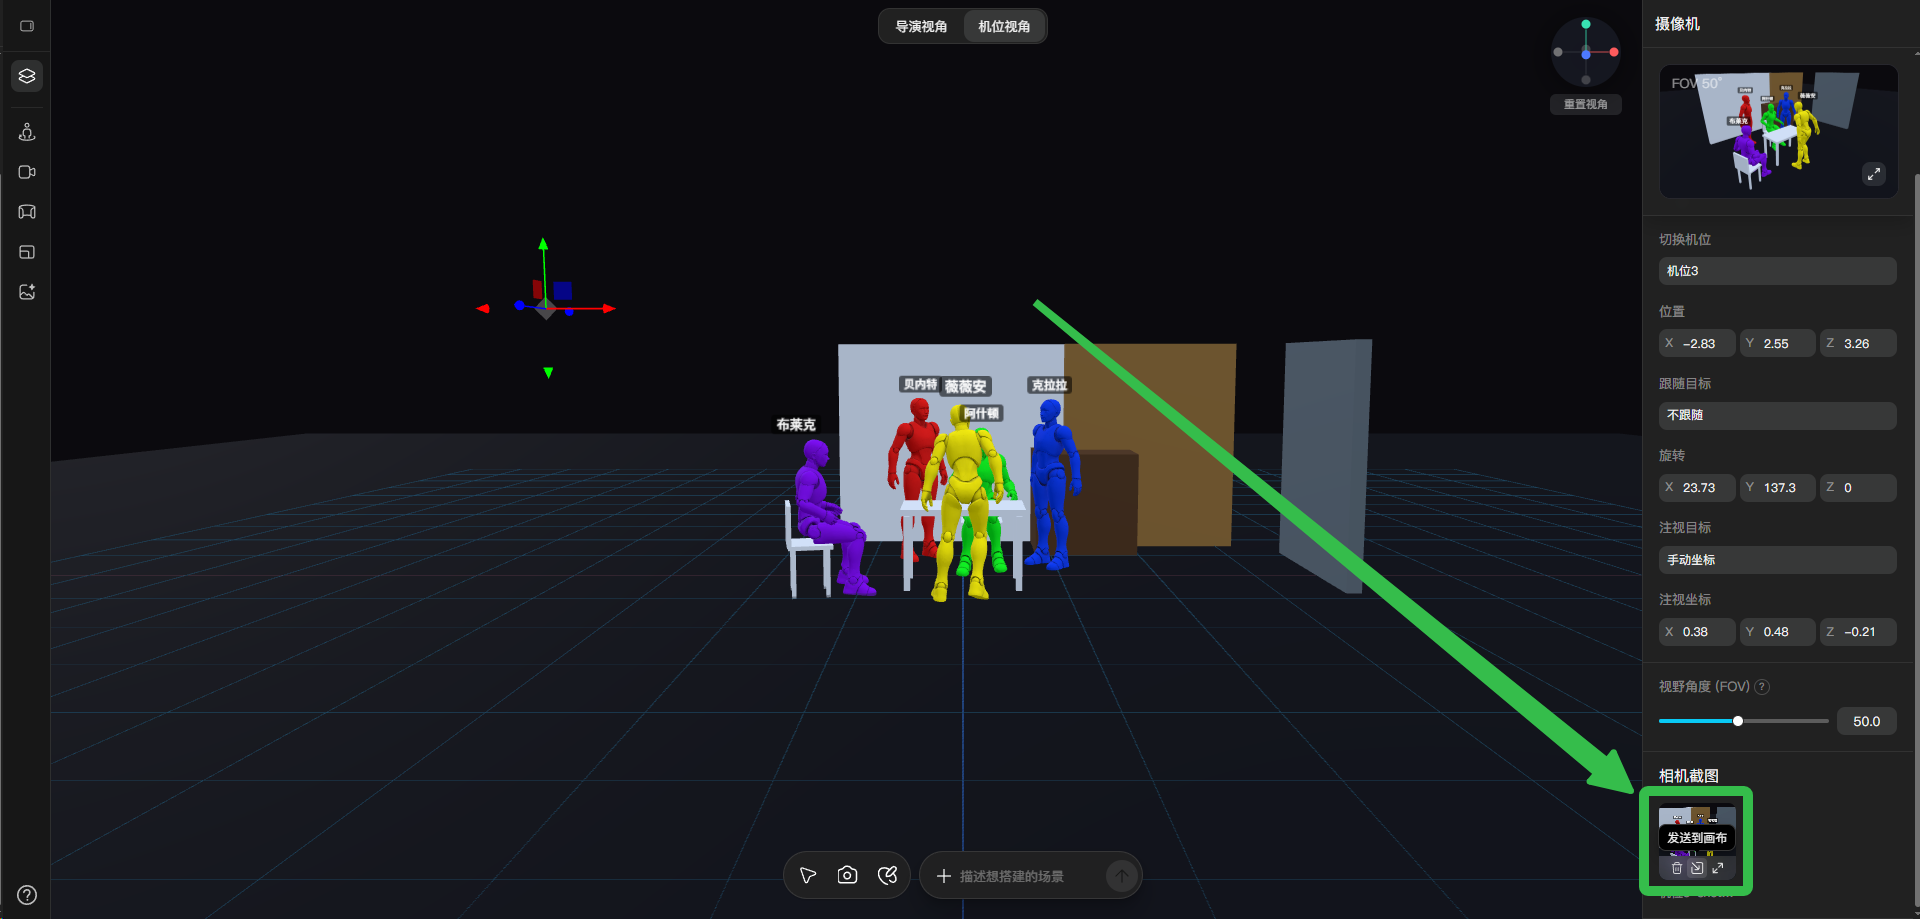
双击人物模型,出现方向轴后,用鼠标拖动调整位置。需要更精细时,可以使用界面右侧的大小和位置数值。
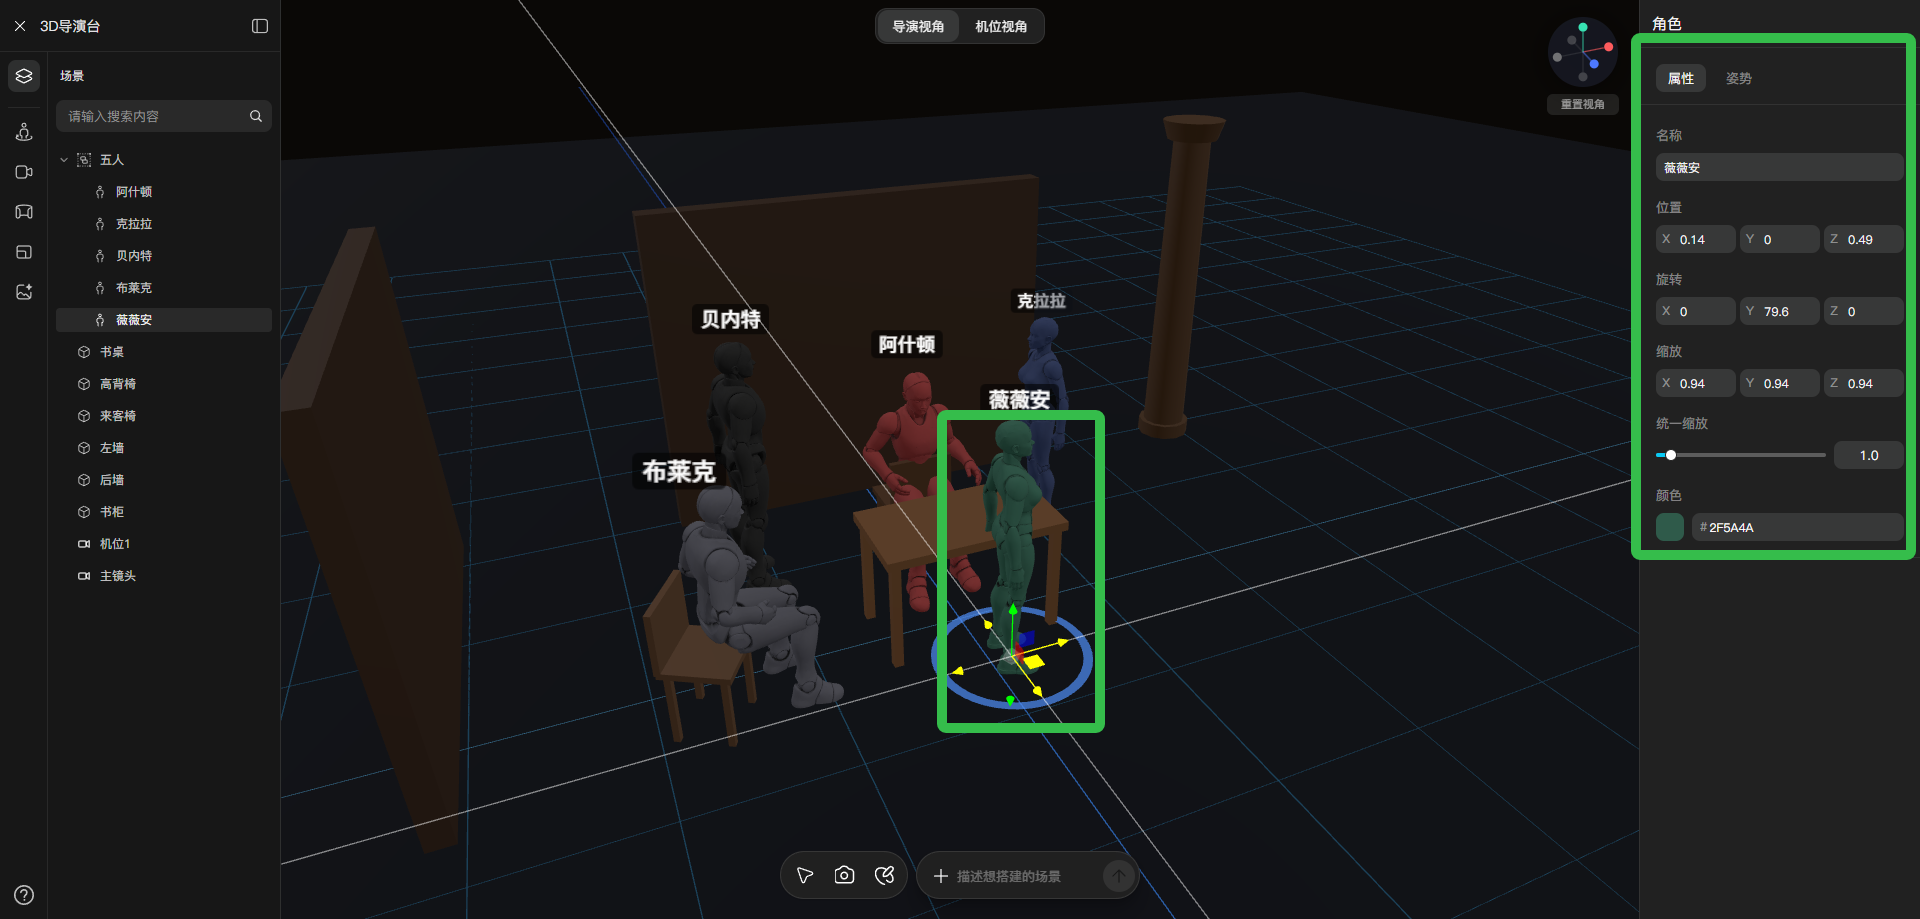
调整时,先确定桌椅的位置,再安排坐着的人,最后调整站着的人。
人物位置合适后,记得将人物的颜色改成鲜艳的不同的色彩。
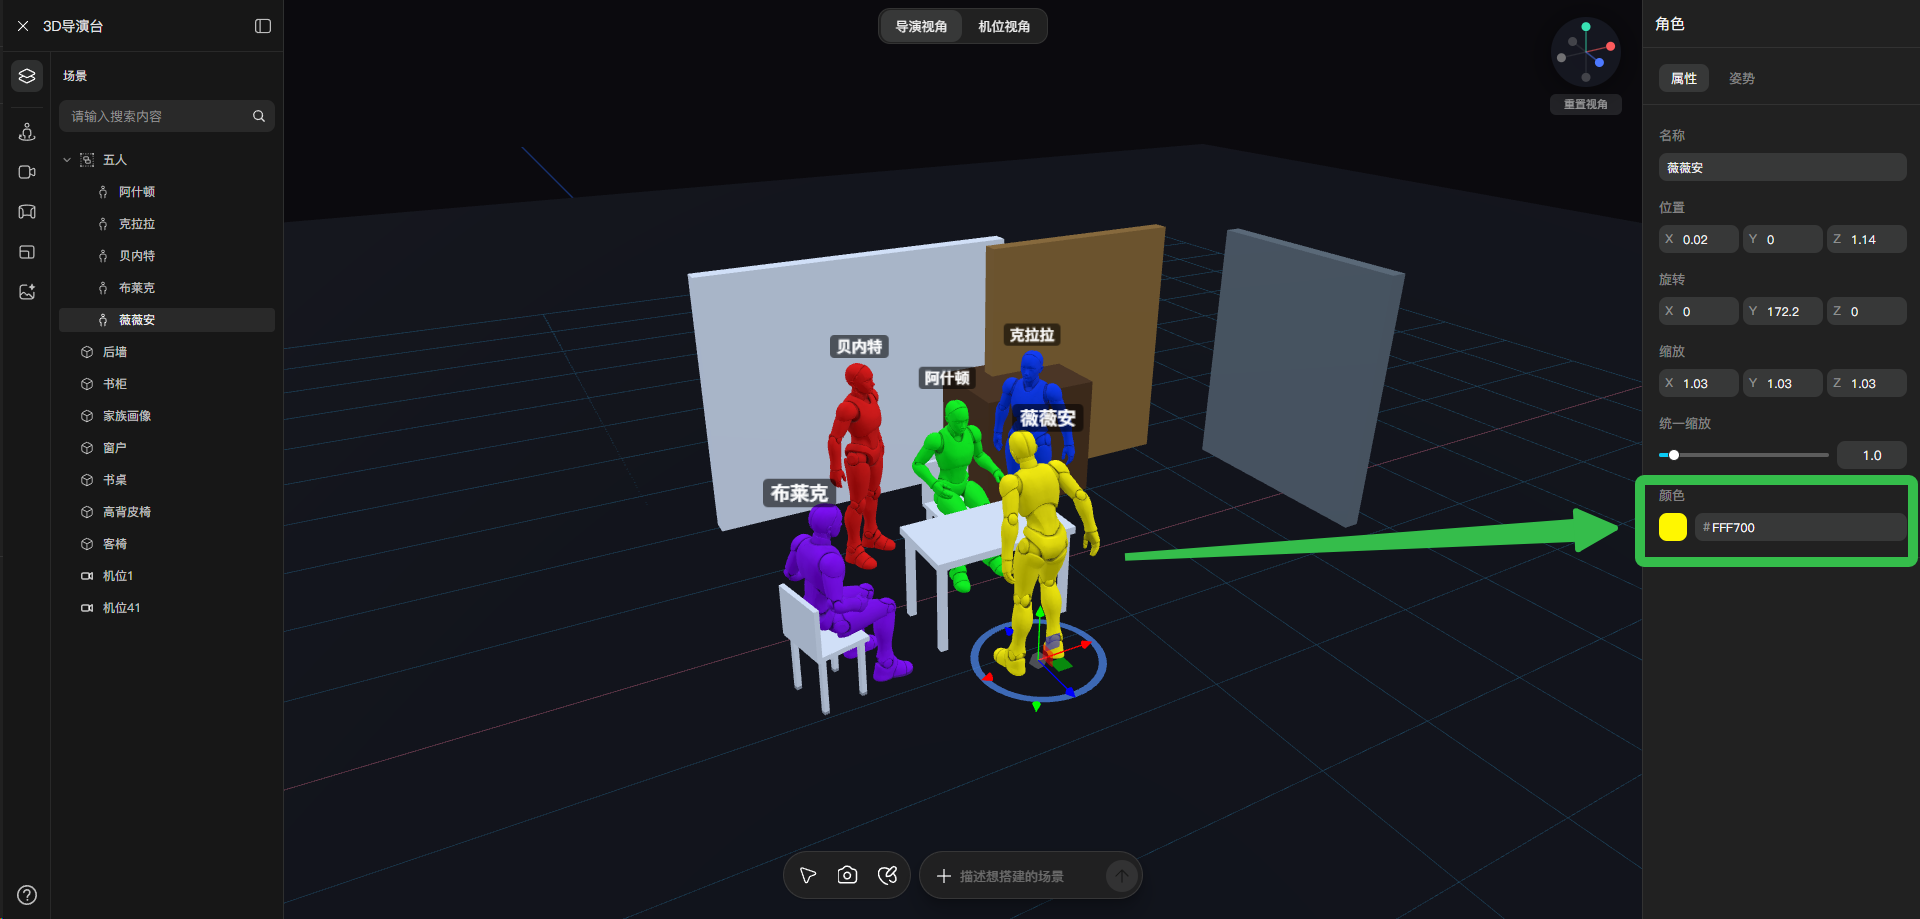
还要确定摄影机的角度、焦段和取景范围。导演台拍出的单帧,将成为视频生成时的构图参考,因此镜头里要出现哪些人、每个人占多大、是否被遮挡,都需要在这里检查好。
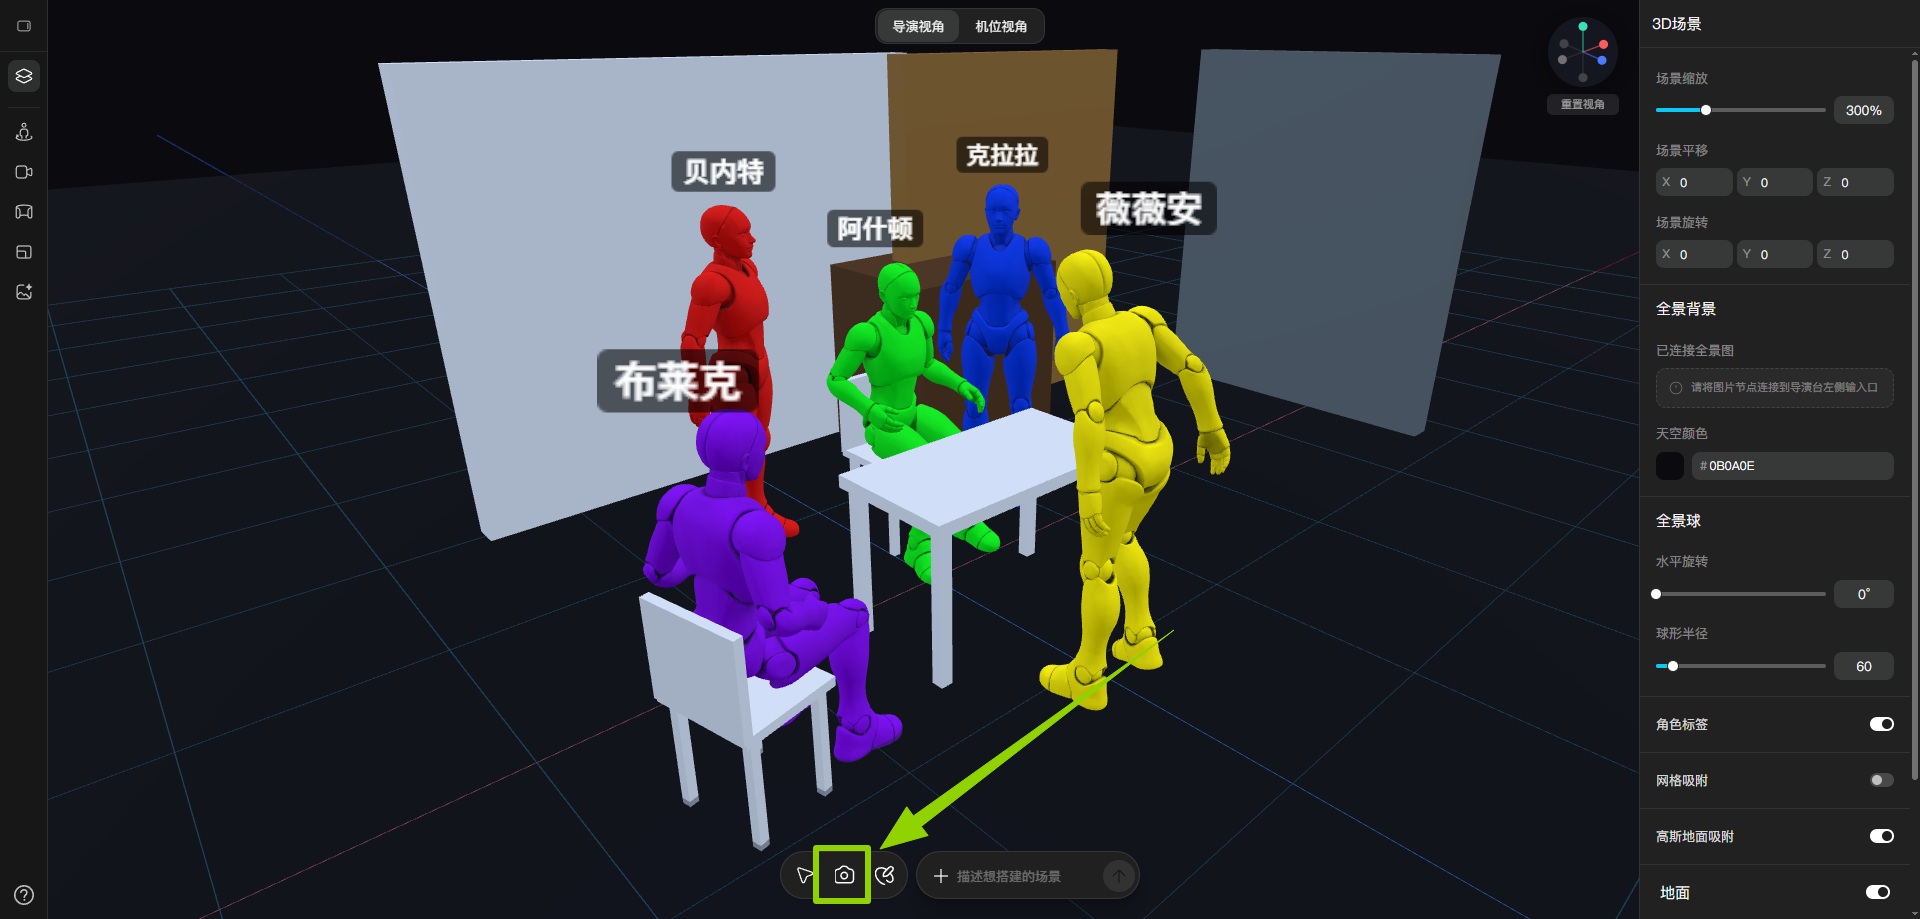
确认后拍照,发送到画布,再下载图片。这张导演台截图,就是后续使用的站位参考图。
五、在 Flowpix 中整理资产
打开 Flowpix 工作流,把人物、场景、道具和导演台站位图放到画布上。
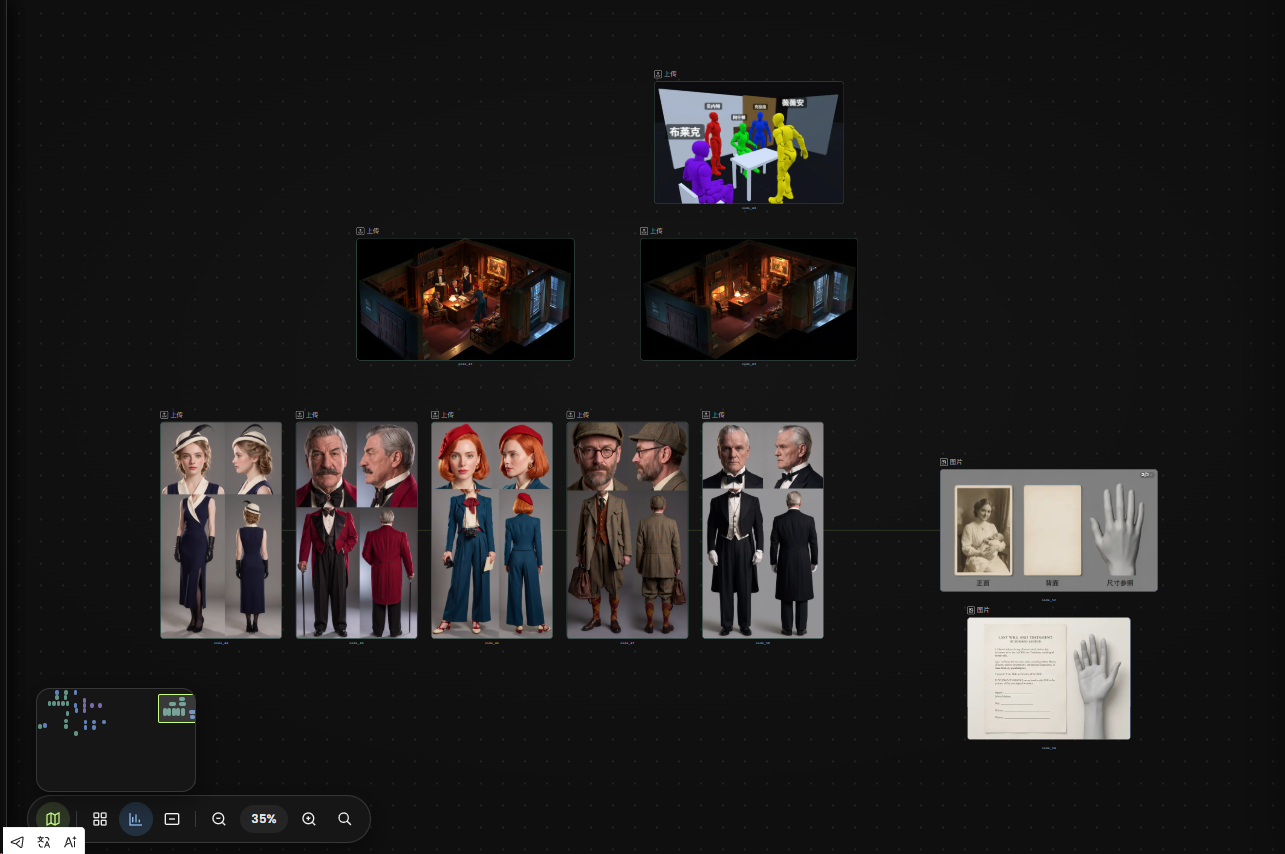
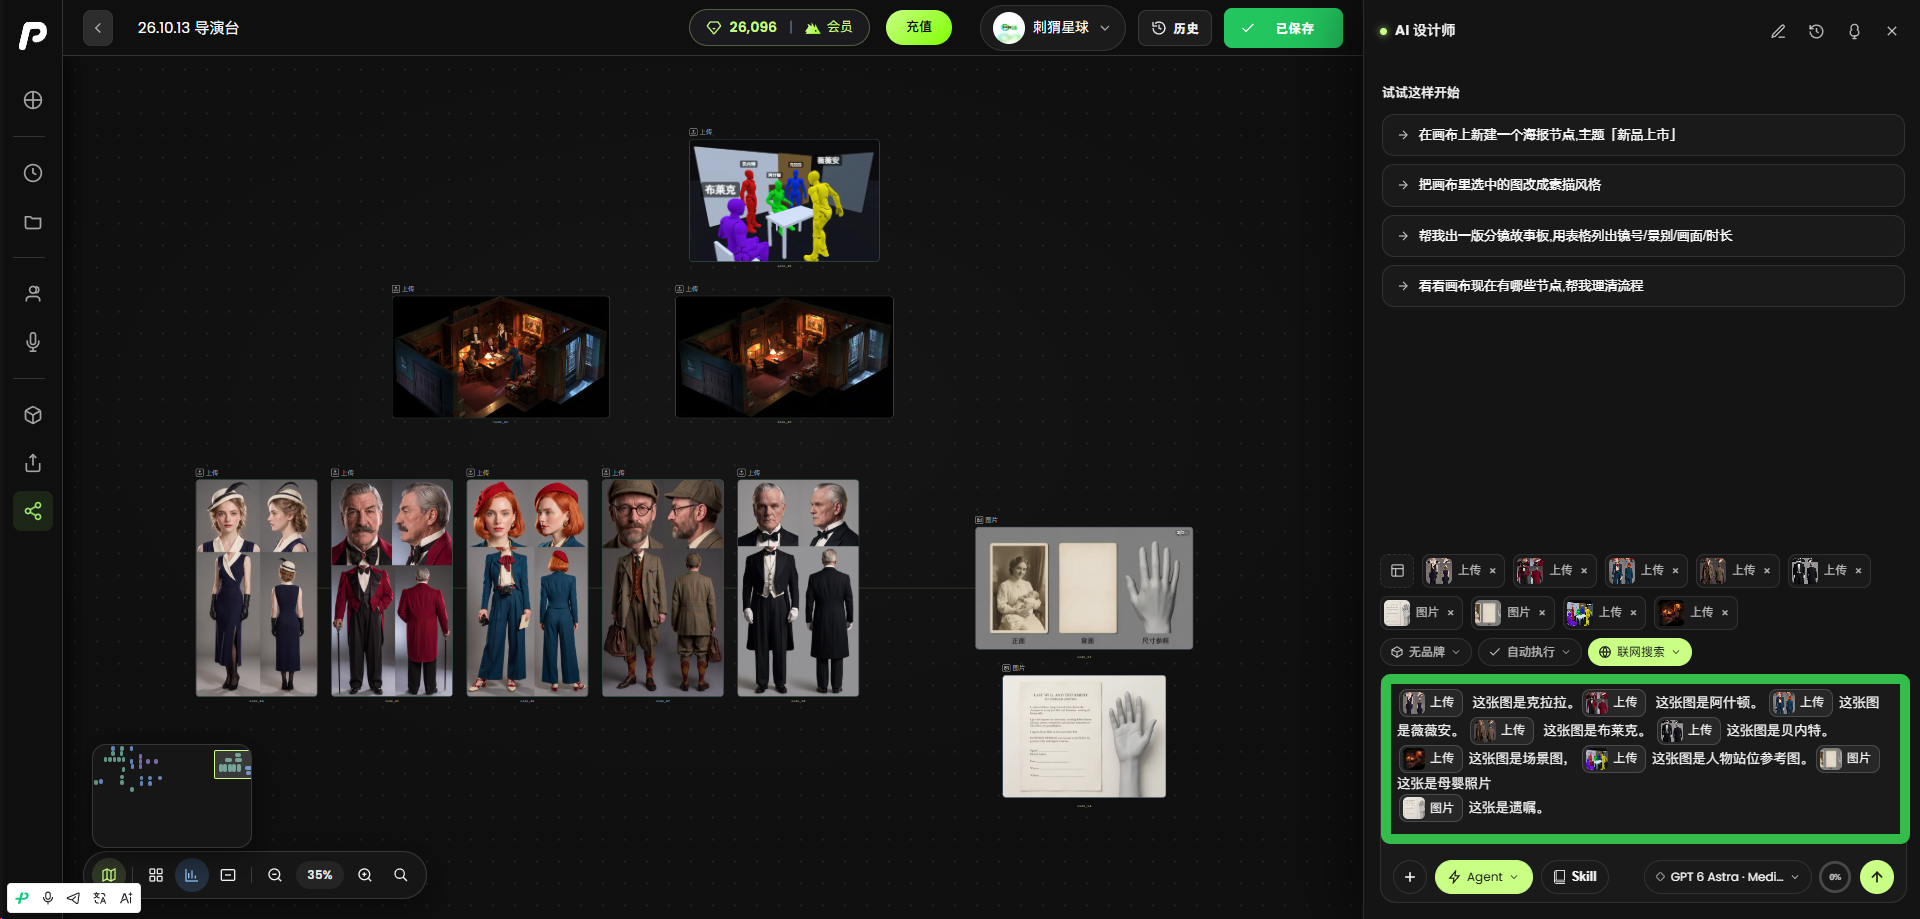
使用Flowpix中的Agent 功能,
从画布中添加图片
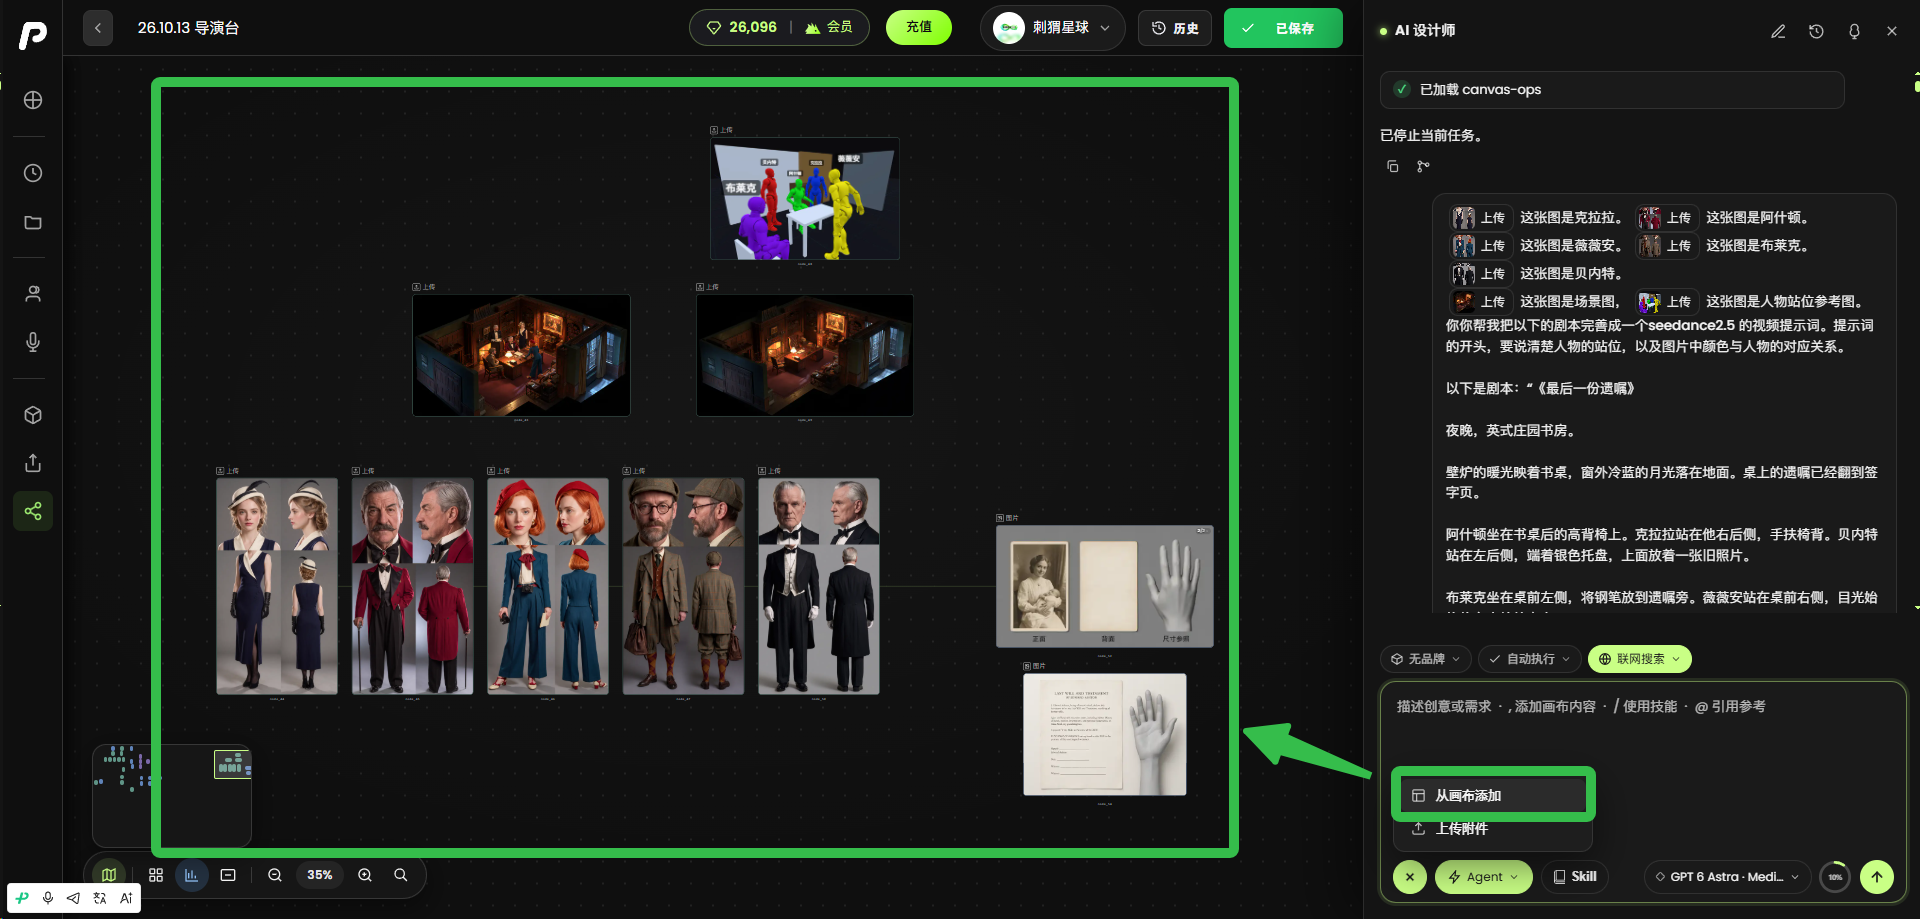
为每张图片注明名称和用途。例如:
“这张图是克拉拉。”
“这张图是母婴旧照片。”
“这张图是导演台站位图,用于参考人物位置、朝向和整体构图。”
六、让 Agent 整理视频提示词
资产标注完成后,将剧本交给 Agent,让它整理为 Seedance 2.5 视频提示词。
这一步要明确提出三个要求。
第一,视频前一秒采用全景,展示完整的人物站位。
第二,站位以整体画面的方向描述。先说明谁在画面左侧、右侧或中心,再补充人物之间、人物与家具之间的关系,避免只写“站在他旁边”。
第三,后续动作和镜头要承接开场站位,人物不能无缘无故换位置。
可以把下面这段要求和剧本一起交给 Agent:
请结合我给你的人物、场景、道具及导演台站位图,将剧本整理为 Seedance 2.5 视频提示词。写清模型颜色与人物身份的对应关系。每一段视频的前1秒为全景,按照站位图展示所有人物。描述站位时先以在画面中的左右、中心和前后描述位置,再补充人物之间及人物与桌椅的关系。正式人物外观参考人物资产,站位图只用于位置、姿态和构图参考。后续镜头与动作需要保持空间连续。画面内容部分就不用写特别多的站位信息了。要求为中文提示词,但是台词演绎为英语英伦发音,并且台词部分是英语。多段视频提示词(需要几段你自己判断),一段30s秒。
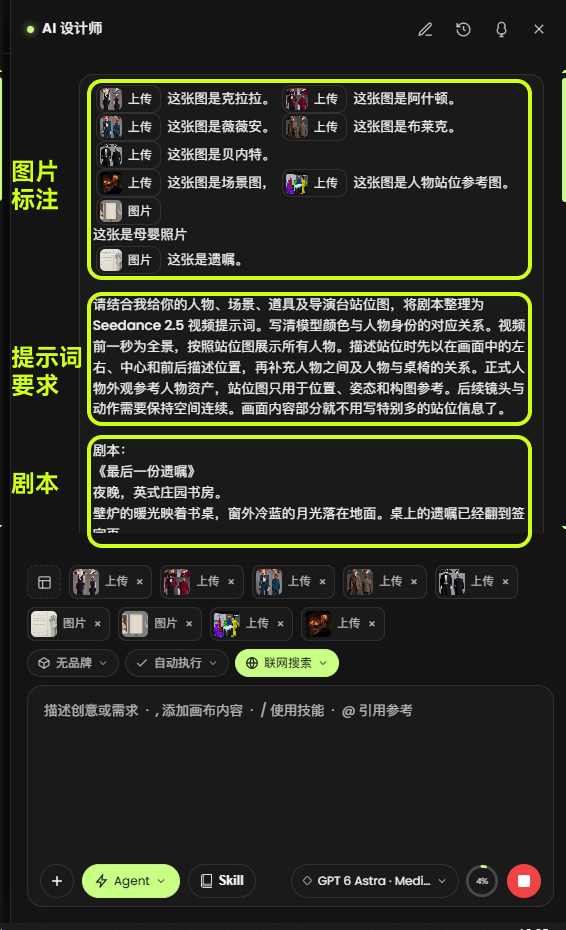
Agent 生成后,再检查人物身份、颜色映射、对白和动作是否对应,确认没有遗漏重要道具。
七、分段生成视频
整理好提示词后,创建视频节点,添加参考图片,再将 Agent 生成的对应提示词复制进去。
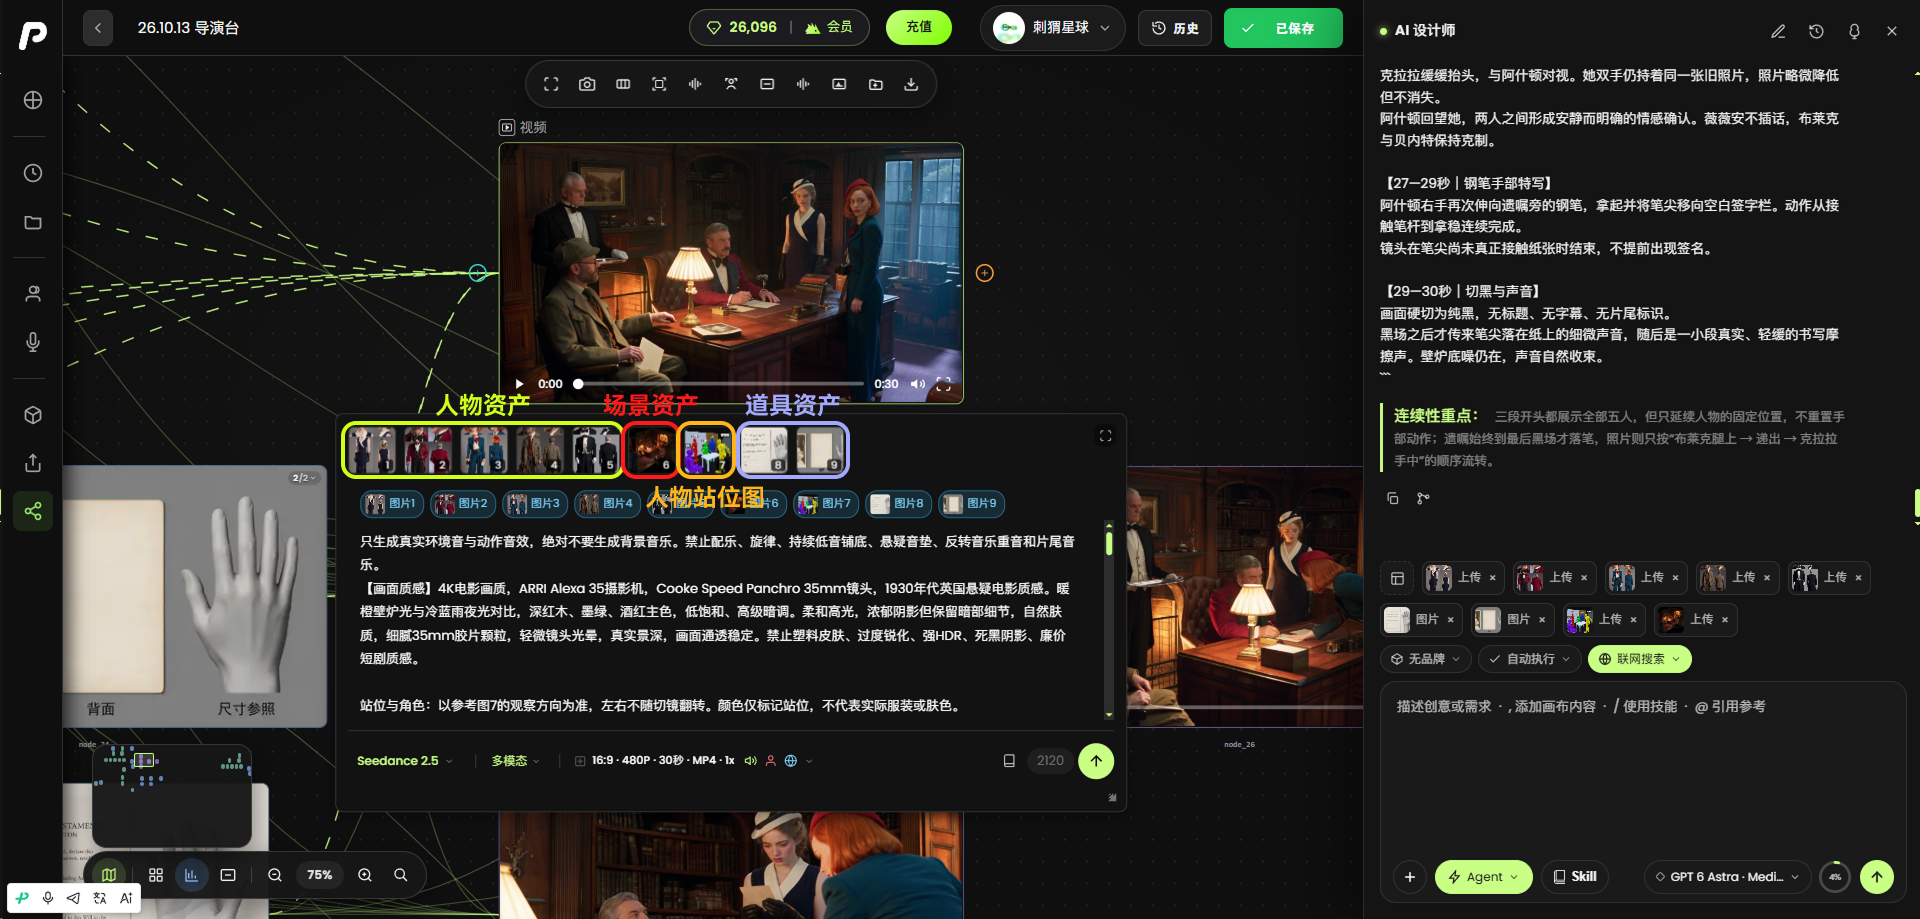
这里要特别注意:视频节点中的图片顺序,必须与提交给 Agent 分析、标注时的顺序保持一致。
例如:
-
Agent 中的图1是克拉拉,视频节点中的图1也必须是克拉拉。
-
Agent 中的图6是场景图,视频节点中的图6也必须是同一张场景图。
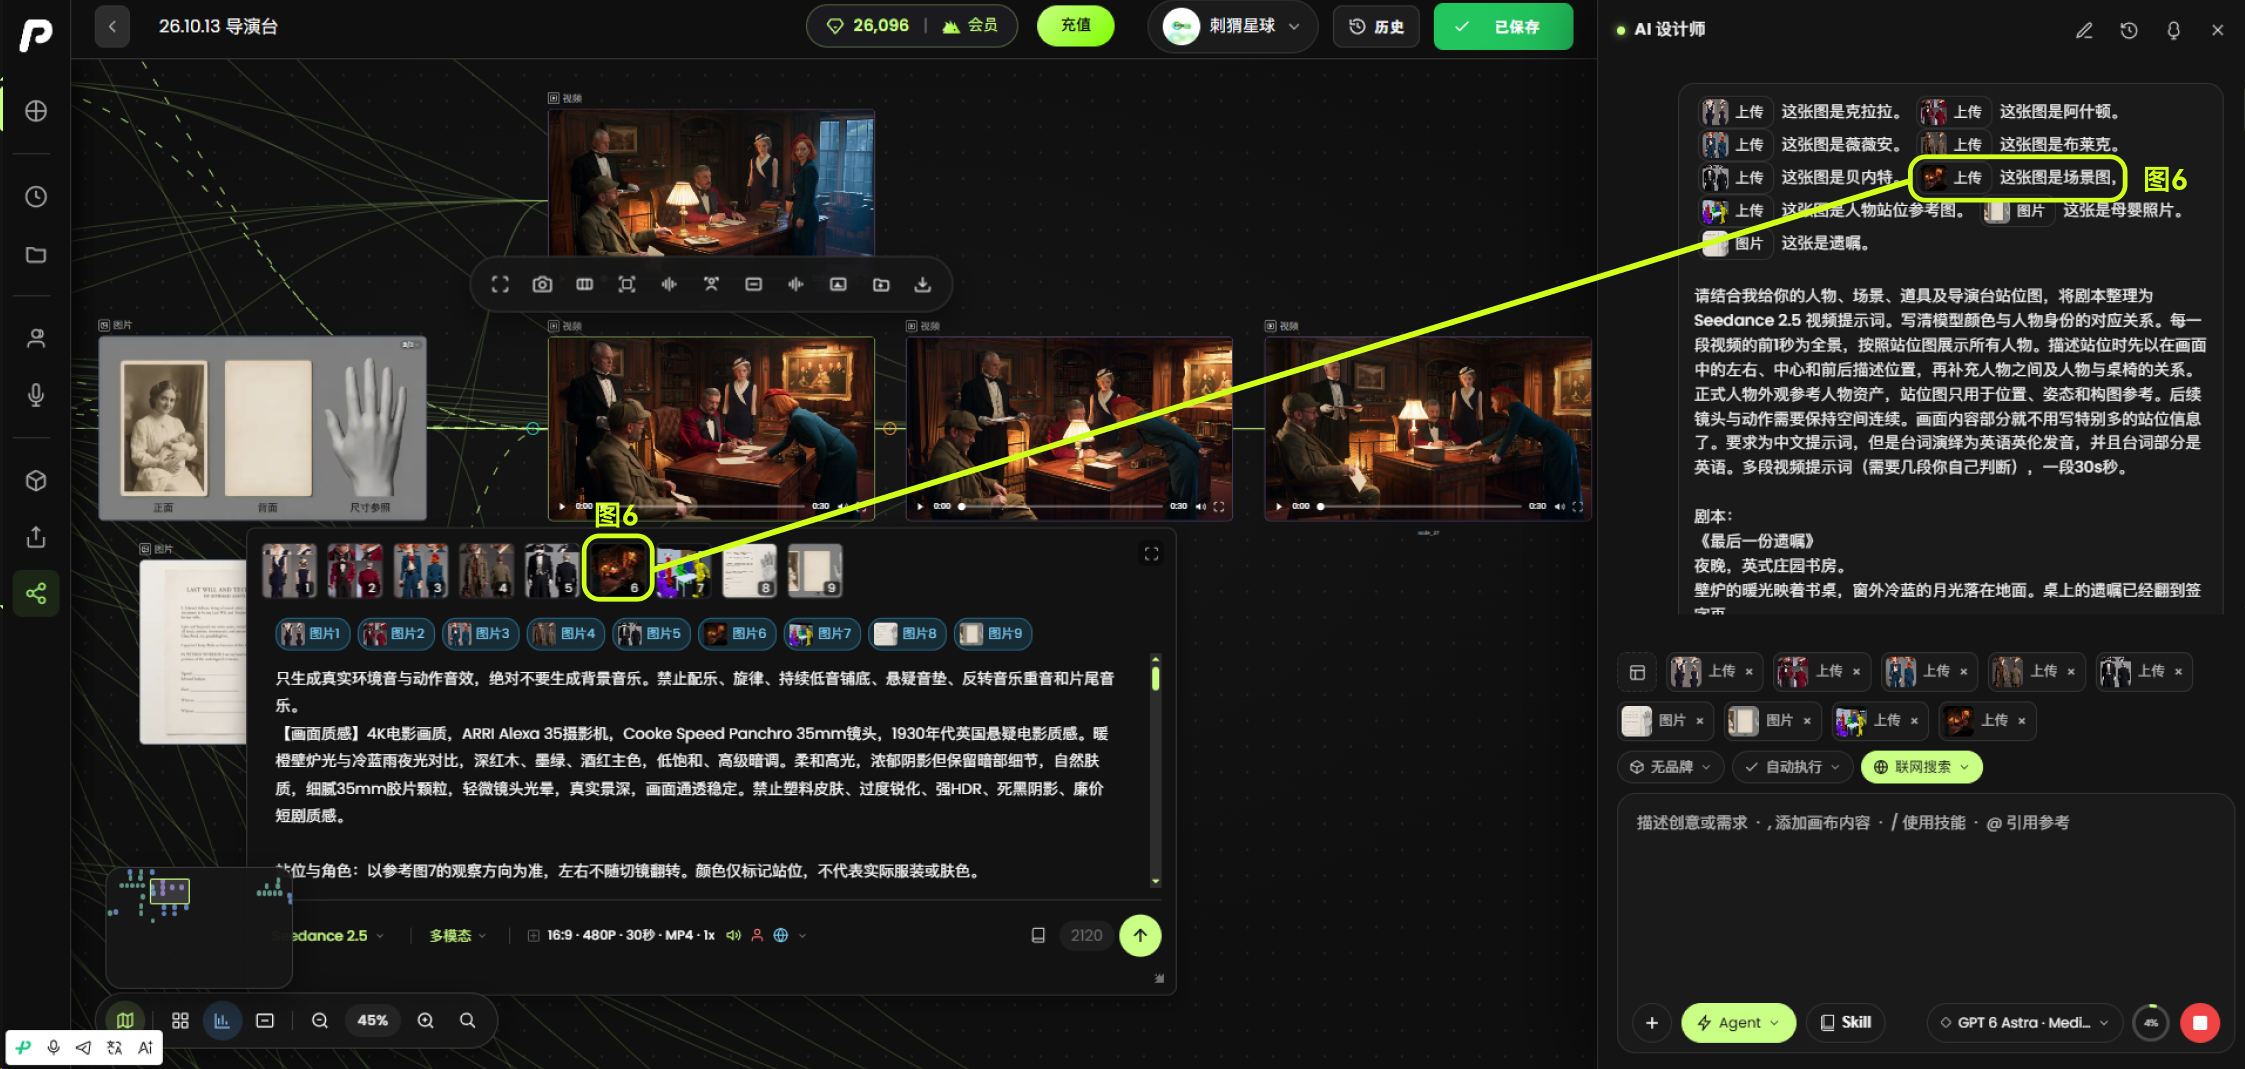
人物、场景、道具和站位图都要逐一对应。如果顺序发生变化,提示词中的图片编号就会指向错误的资产。生成前,先核对图片顺序和编号,再点击生成。
然后设置生成参数:
-
模型:Seedance 2.5。
-
参考模式:多模态全能参考。
-
时长:30秒。
-
分辨率:480P。
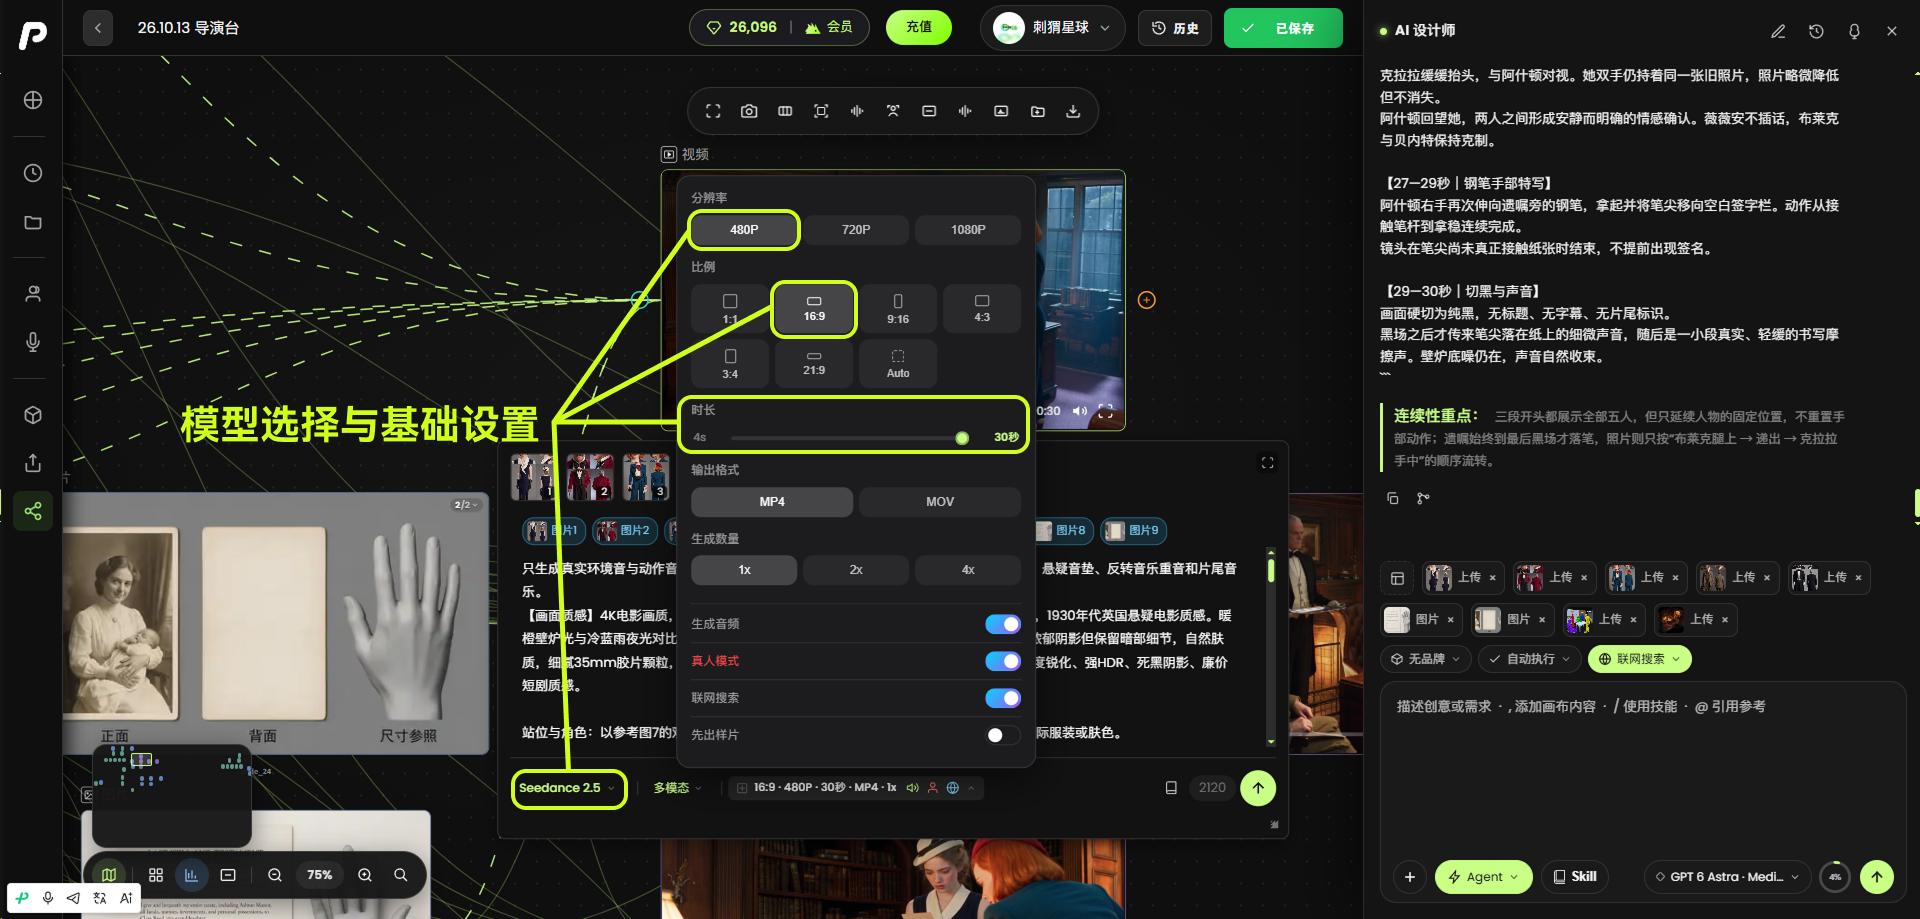
这次90秒的内容分三段生成,因此需要准备三个视频节点。三个节点都按相同顺序输入参考图片,并使用上述设置。
Agent 输出的提示词包含两部分:一段共用提示词,以及三段分别对应画面内容的提示词。
共用提示词会说明参考资产的用途、场景、光线,以及固定的声音效果等统一要求。
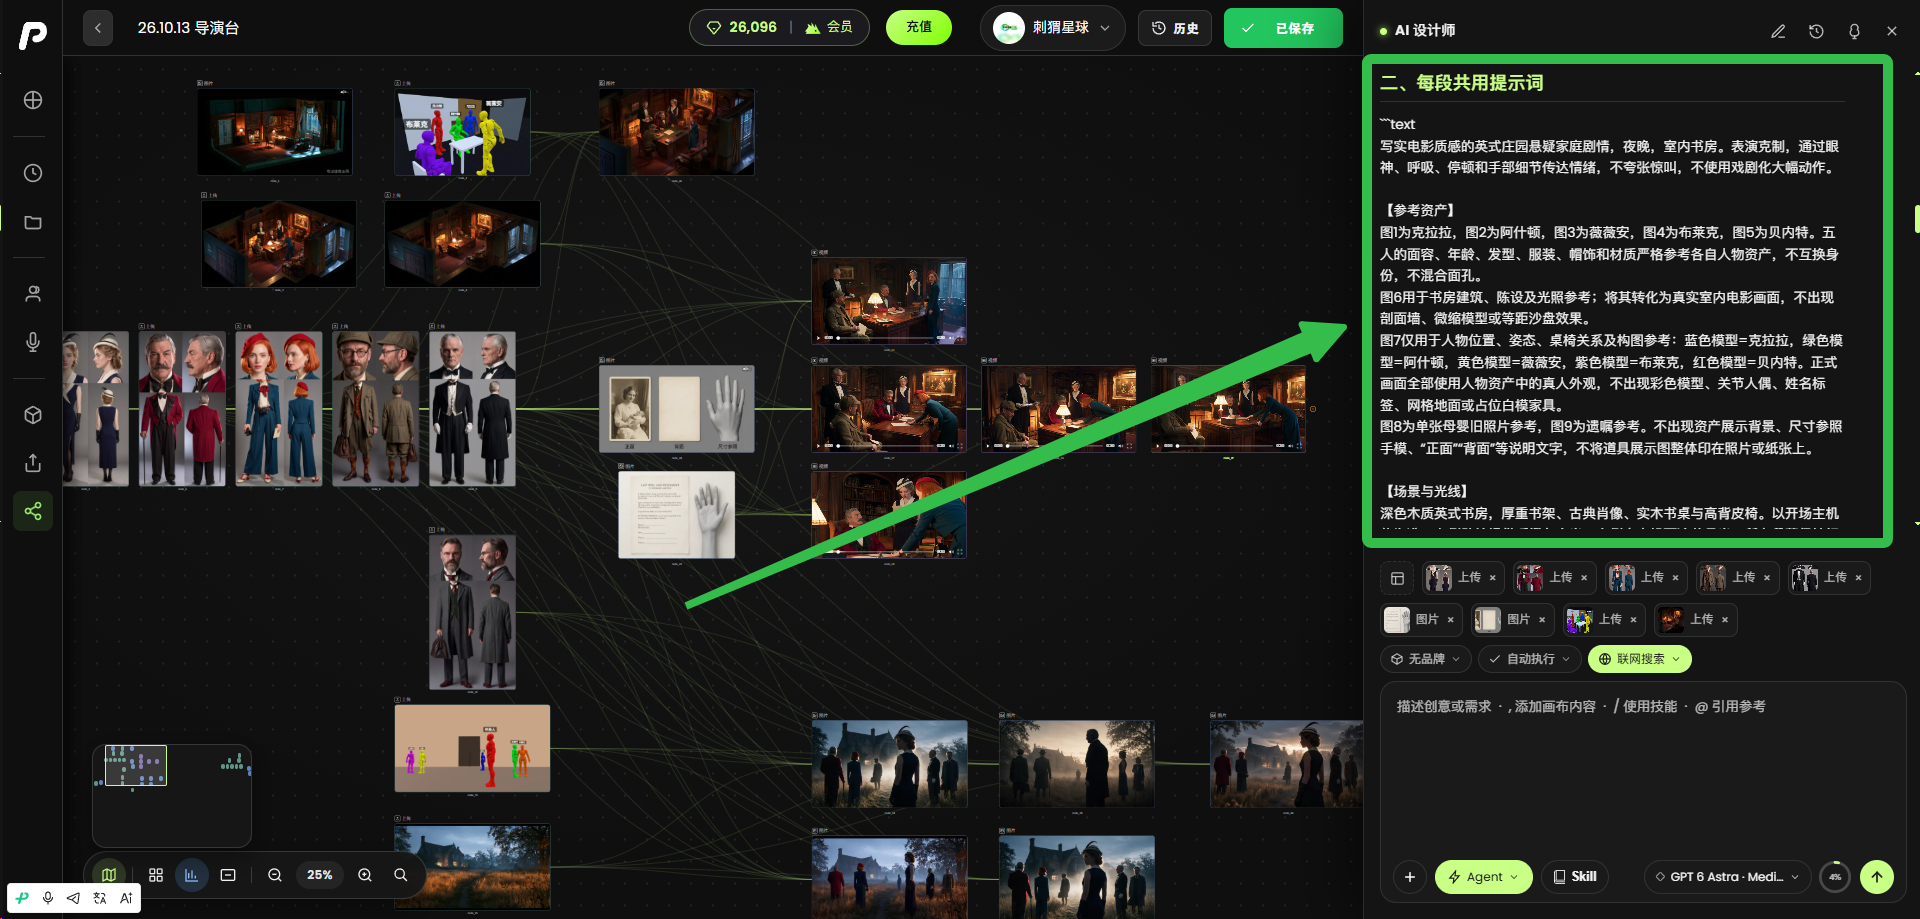
共用提示词
再接上对应段落的画面内容
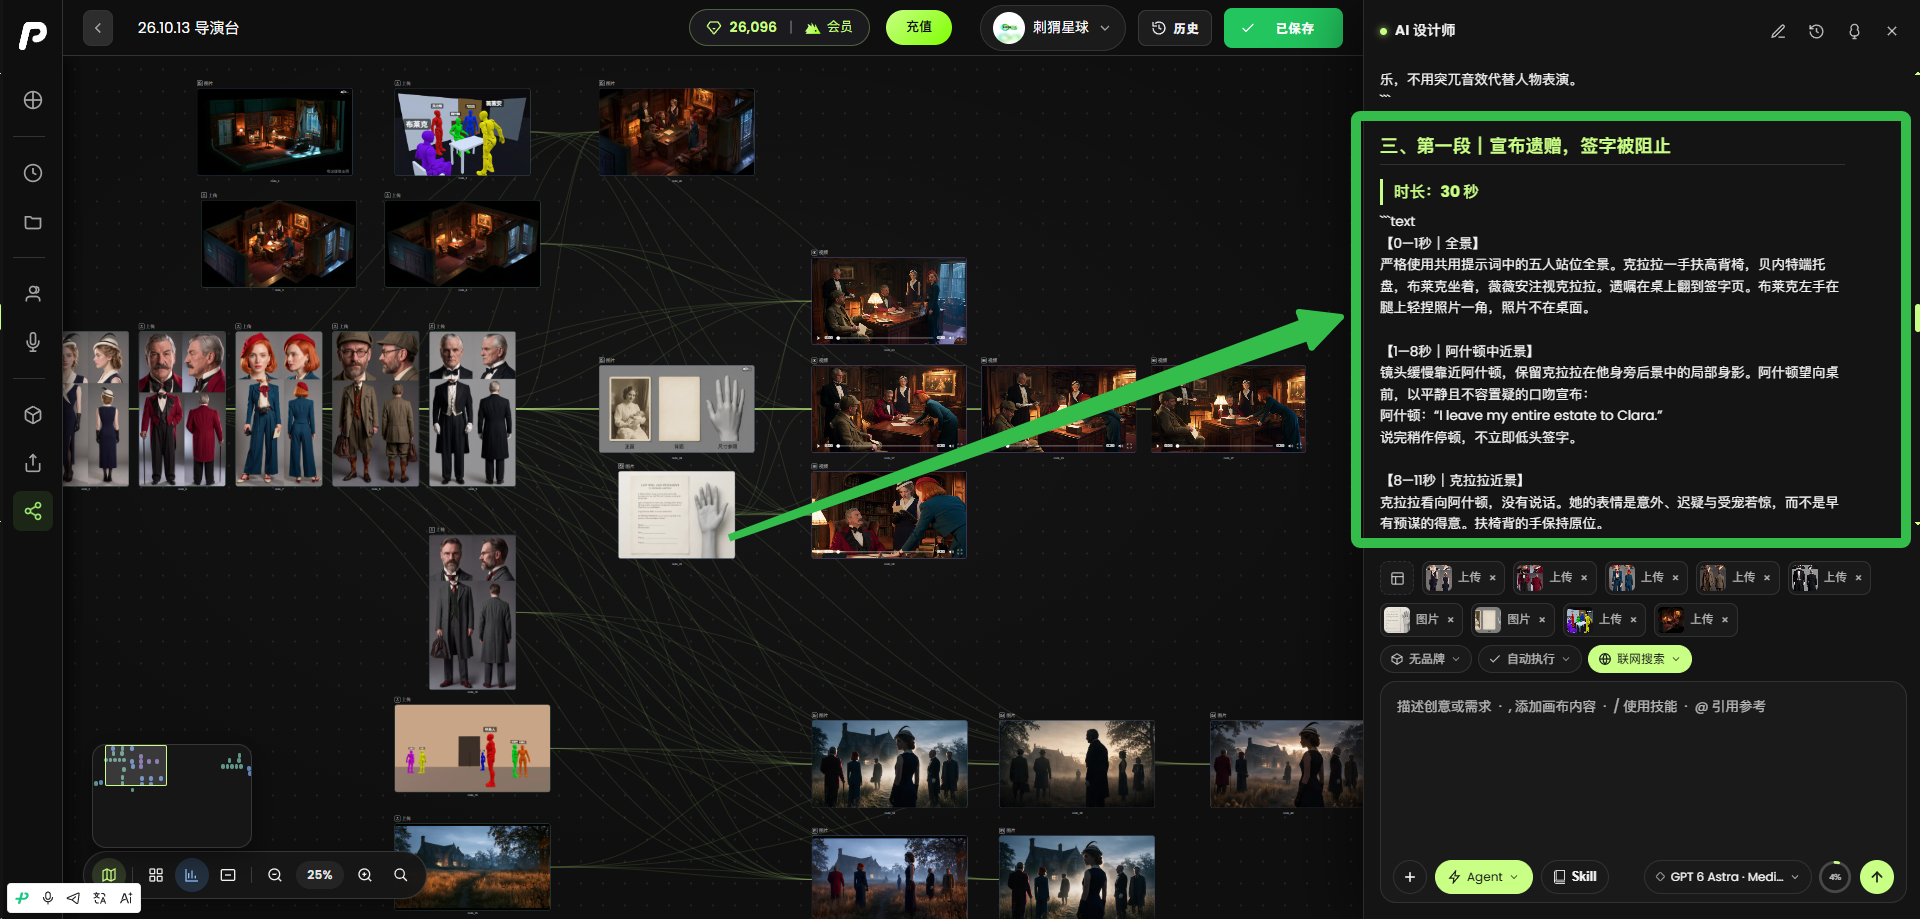
画面提示词
三个节点分别填写:
-
第一个节点:共用提示词+第一段画面提示词。
-
第二个节点:共用提示词+第二段画面提示词。
-
第三个节点:共用提示词+第三段画面提示词。
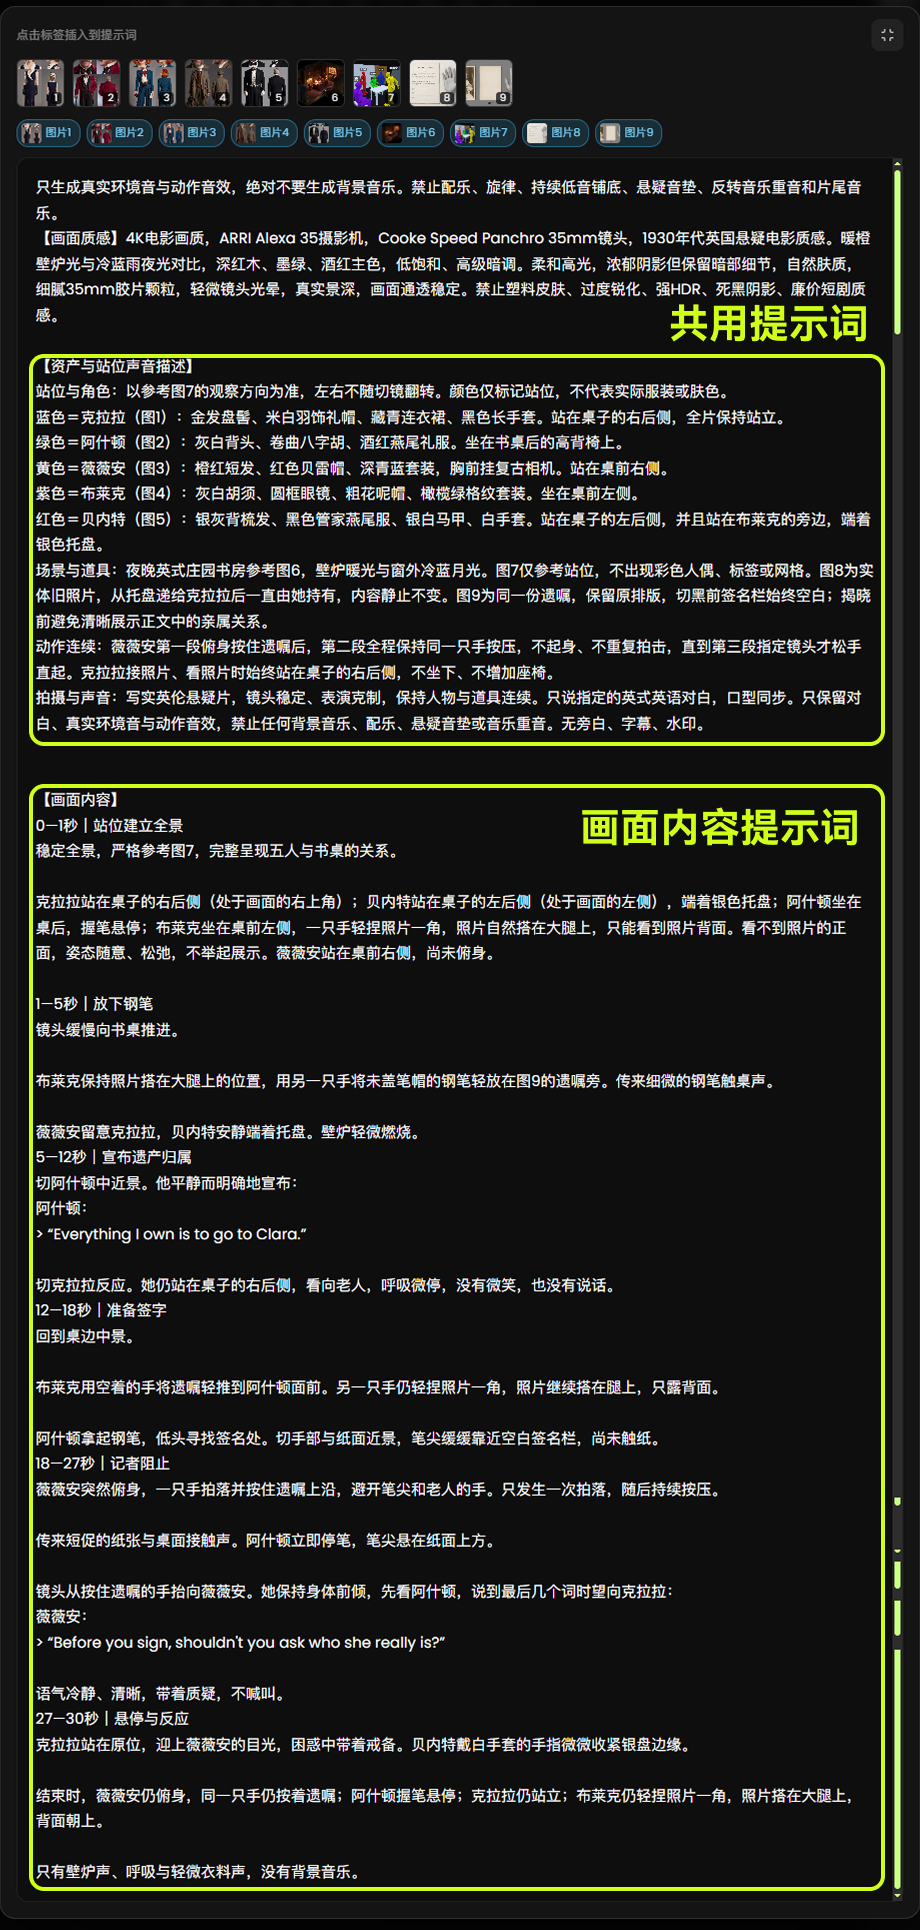
提示词示例
生成前,核对三个节点的参考图顺序、参数和提示词,确认每段都包含共用提示词,且画面内容没有复制错,再分别点击生成。
有站位图,也需要多次尝试
站位图能为视频模型提供更明确的人物位置和构图参考,但不能保证生成结果完全照着执行。多人同框时,仍可能出现人物位置偏移、朝向错误、互相遮挡或动作不连贯的情况。
因此,实际制作中通常需要多次生成,也就是大家常说的“抽卡”,再从中挑选合适的版本。如果同一个问题反复出现,就要回头检查站位图、图片顺序和提示词,调整后再生成。
这也是先用480P测试的原因:先确认人物关系和表演基本正确,再对选中的片段进行超分,减少不必要的时间和成本。
比如海外的Higgsfield团队做的电影,一个片段抽卡可能20到30次。
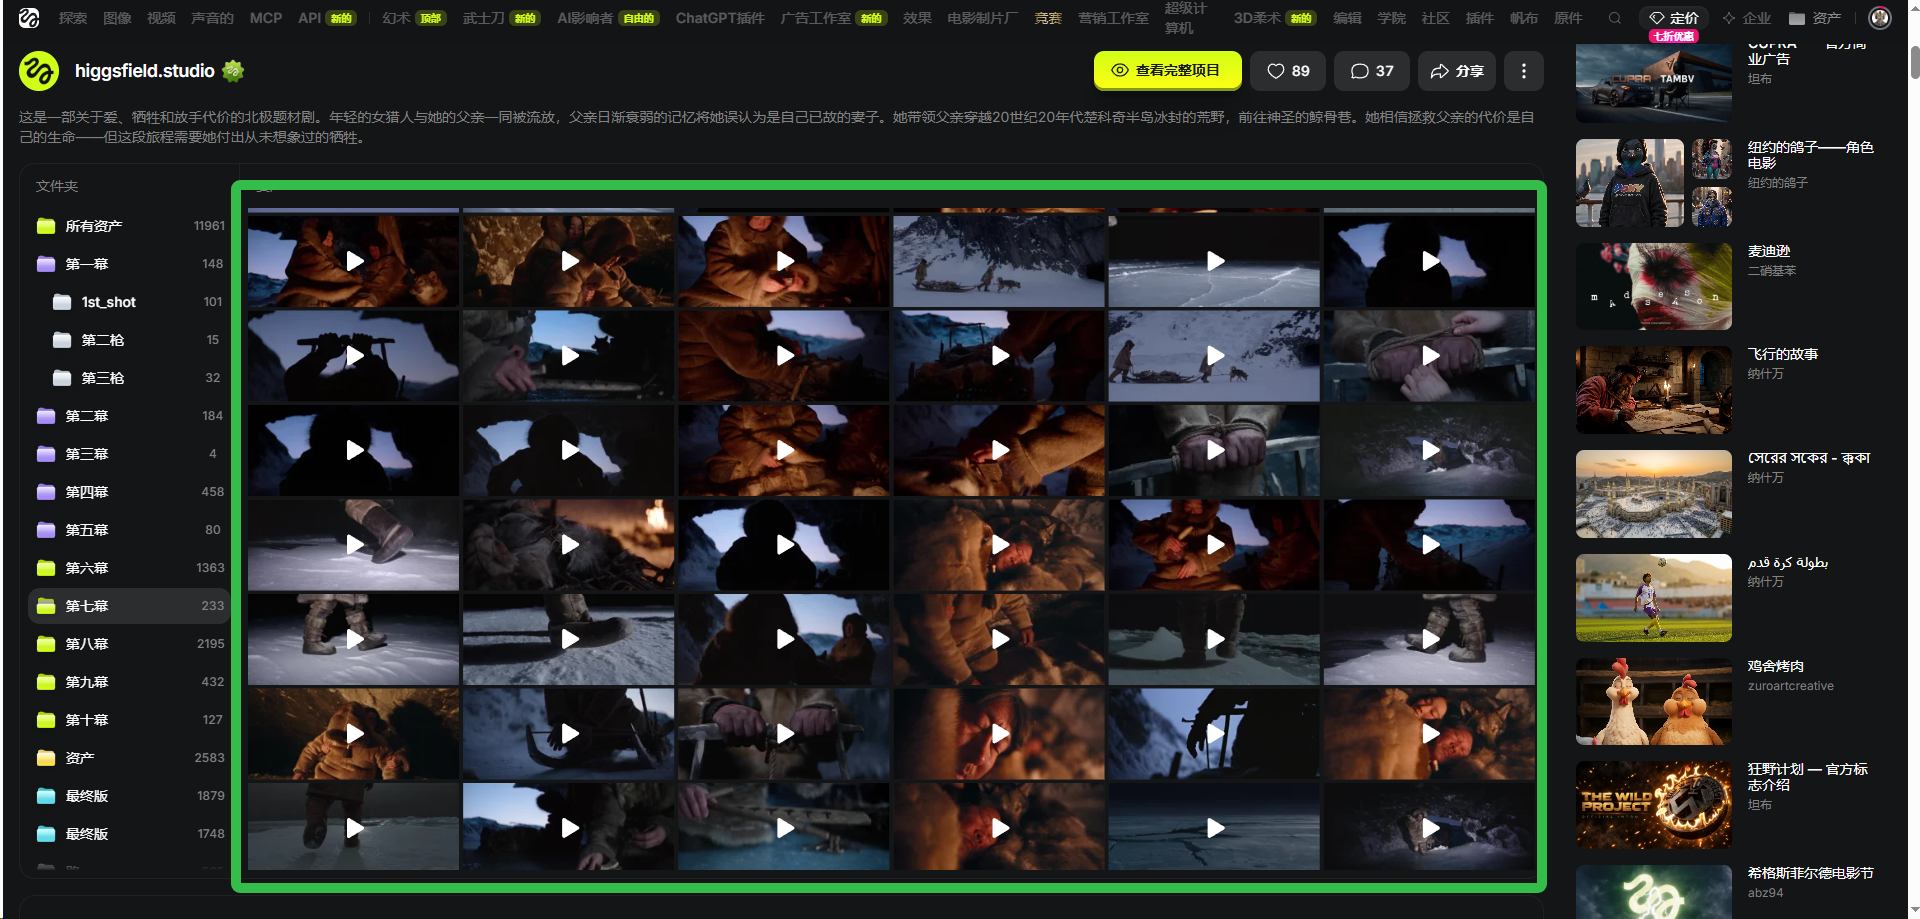
higgsfield的项目截图,每个片段抽卡20次以上
八、超分、剪辑和调色
这次先生成480P版本,检查人物站位、动作、面容和对白。确认可用后,再通过超分工具提升到1080P。
可以使用libtv的超清功能
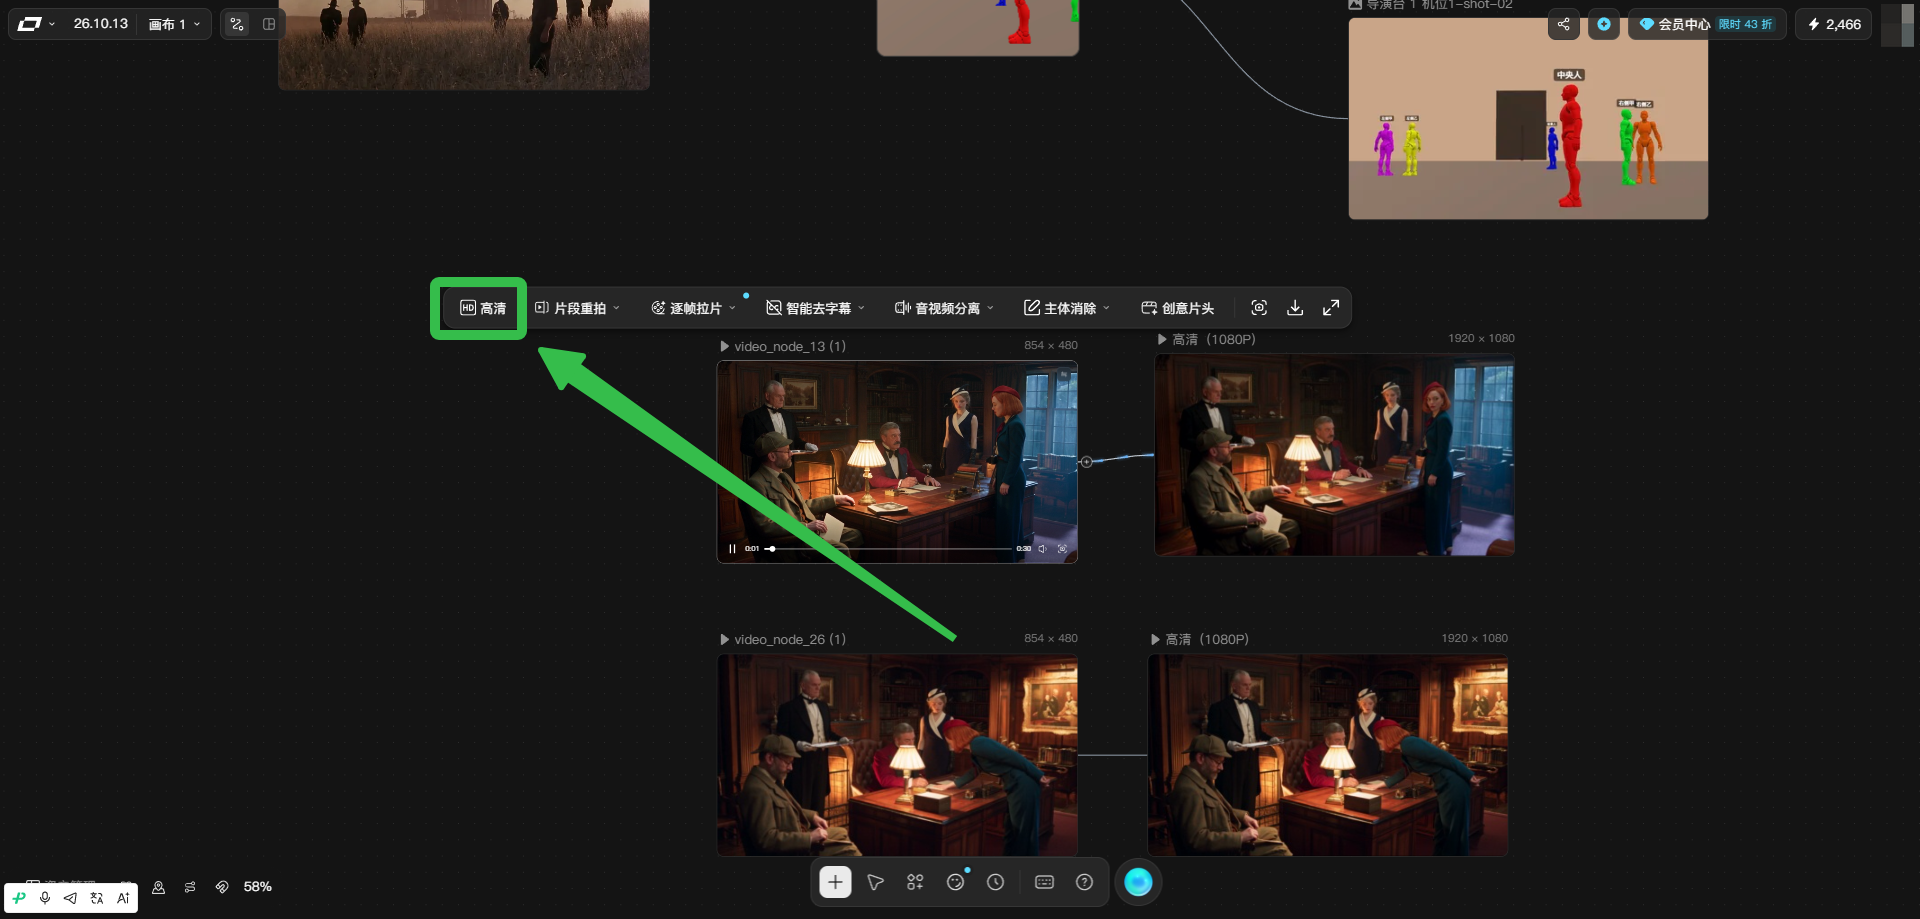
随后将三段视频导入剪映,完成拼接,修剪重复或多余的画面,调整对白与镜头之间的停顿。
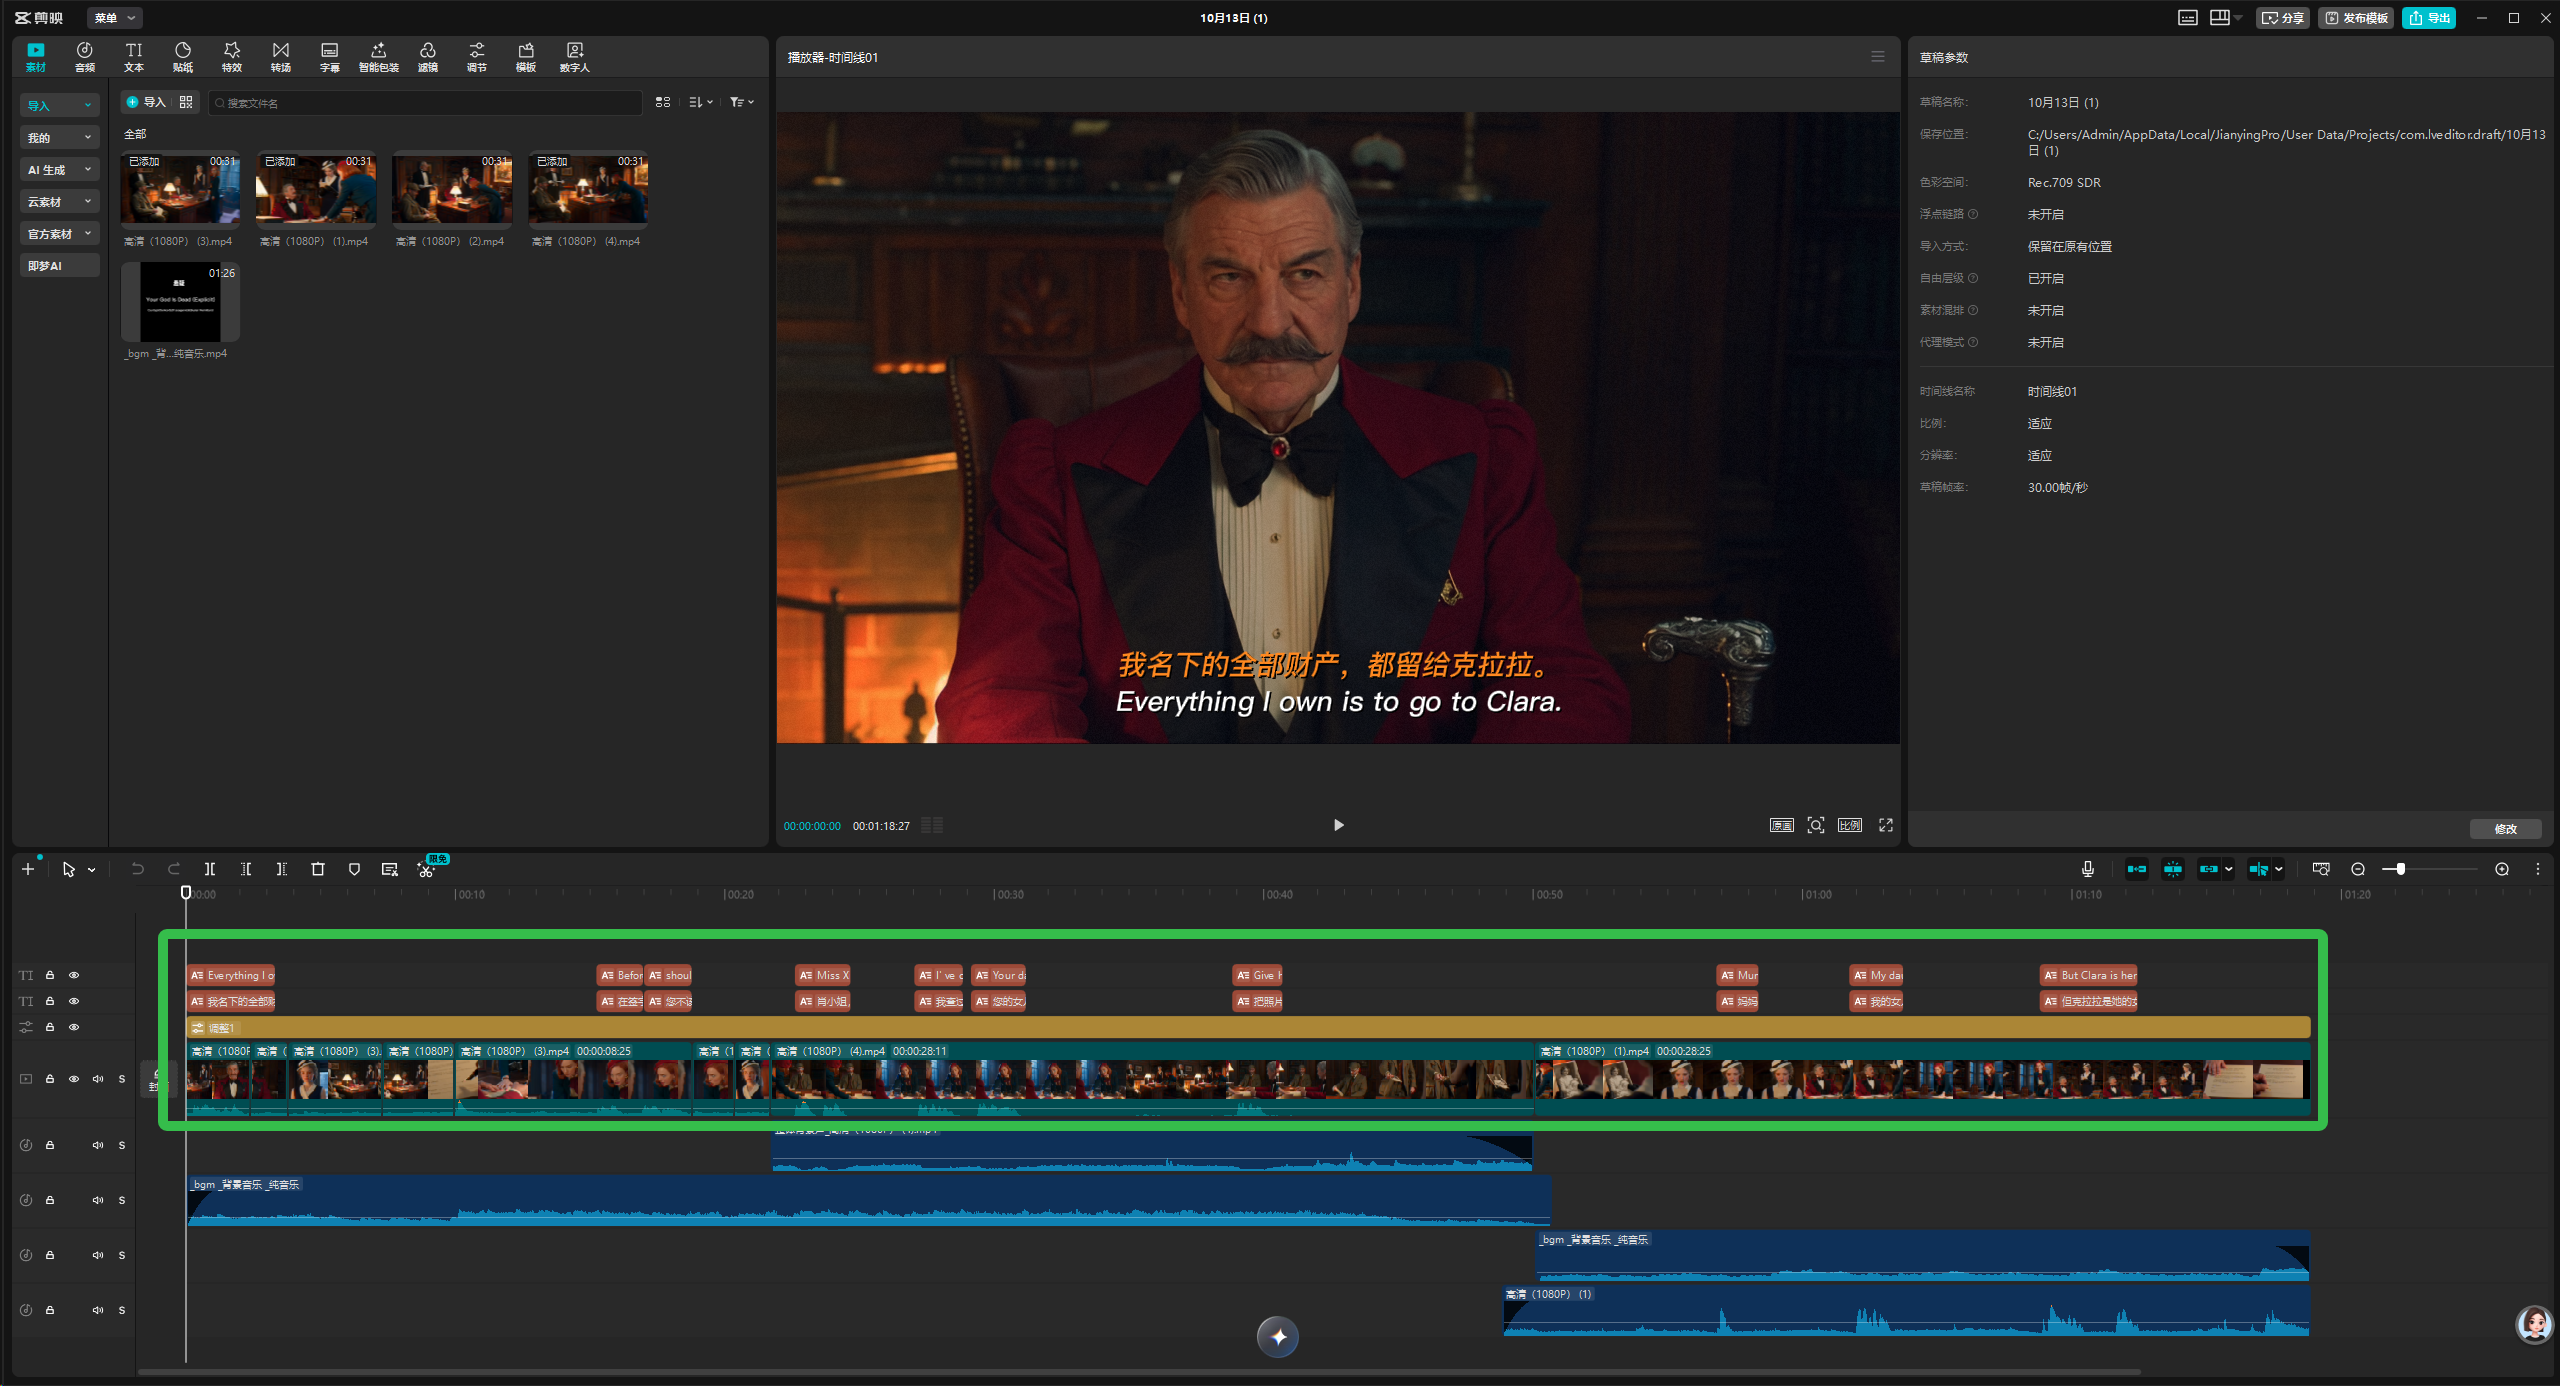
最后稍作调色,统一不同片段的亮度和冷暖关系
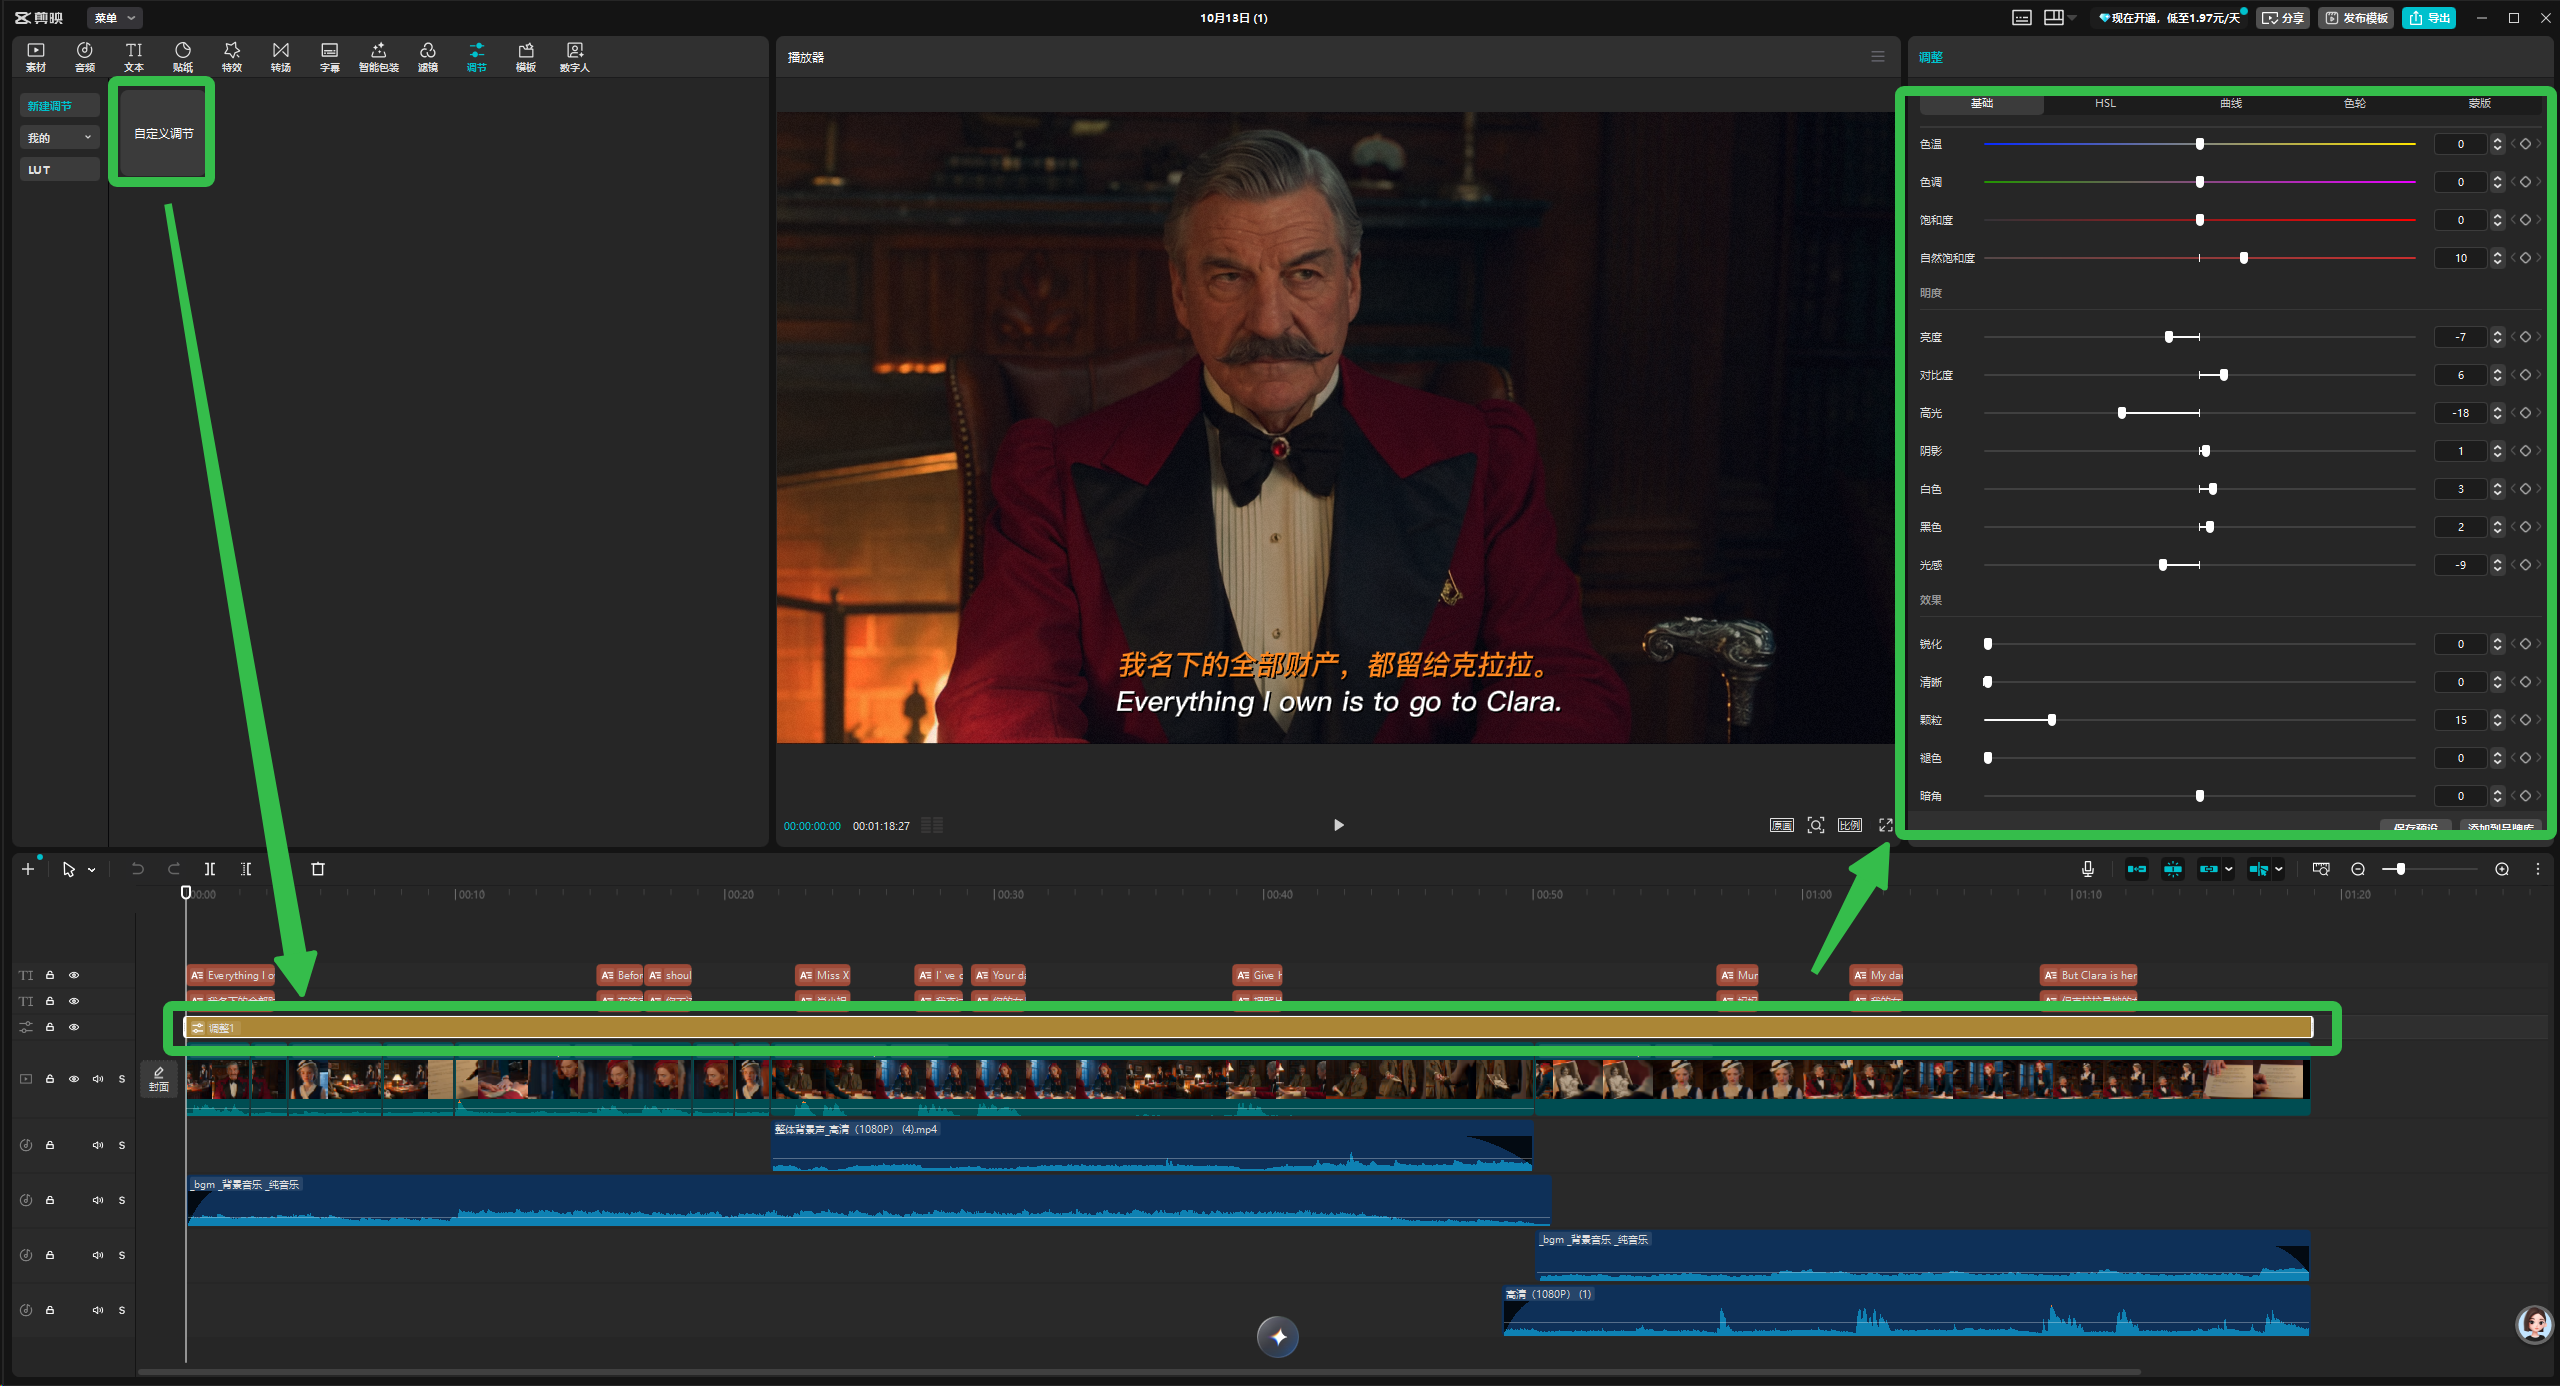
开头一秒的站位全景只用于辅助生成,可以在剪辑时裁掉;如果适合交代人物关系,就保留在成片里。
这套流程中,导演台截图承担的是人物位置与构图参考,人物资产负责外观,场景资产负责环境,道具资产负责细节。把这些信息准备清楚,再交给视频模型,后续的生成和修改才更有依据。
本次制作完成后,可重复的skill如下(复制到网址即可自动下载)
https://superi.mfdemo.cn/chaoji/2026/10/23/6adabf94109a9.zip
想学什么内容,欢迎在评论区留言,老师会参考大家的想法,安排后续课程!