一起来看一下成品:
准备工具
seedance2.5 https://jimeng.jianying.com/ai-tool/home/
Midjourney https://www.midjourney.com/explore?tab=top
ChatGPT https://chatgpt.com/
倘若不知道模型怎么使用,可以参考这个教程(https://www.super-i.cn/info-2796.html),与本教程一起使用
如果不想各个网页跳转模型,可以使用flowpix平台,已接入所有热门模型
https://www.flowpix.club/bj/45039.html?token=50f5908ef7be8fd0997c74cda3d3c8ef
以下是我与ChatGPT的对话记录,粘贴链接至浏览器,即可浏览所有对话历史
https://chatgpt.com/share/6aa7b141-a210-83ea-ab14-e63212201f7a
一、先别急着做运镜,先确定30秒到底发生什么
我这次一开始只有人物,没有剧本,也没有确定场景。
所以第一步不是打开Blender,而是把现有角色全部交给AI,让它先根据人物身份帮我推导适合一镜到底的情节。
我使用的提示词是:
我想做一个一镜到底运镜的视频,主要方法是使用GPT 6 Astra去制作Blender粗模运镜,然后使用Seedance 2.5去视频参考生成视频。这是我现有的模特,图1是女主,图2是公爵,图4是记者,图3是管家。我需要先做一个较大场景俯视场景运镜图,可以是方块的,有一些颜色区分,需要有一条摄像机运镜路线。你先帮我想几个适合这些人物的情节,让我筛选,保证最终视频能够控制在30秒以内。剧情尽量依靠人物动作、走位和镜头信息推进,不要依赖大量对白。
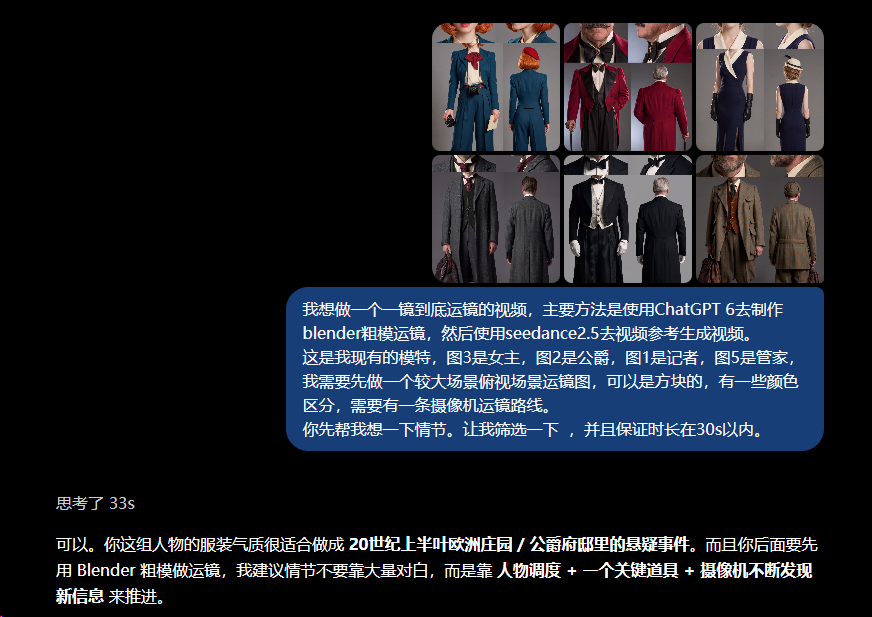
直接去询问ChatGPT
AI会根据人物身份给出几种剧情方向。
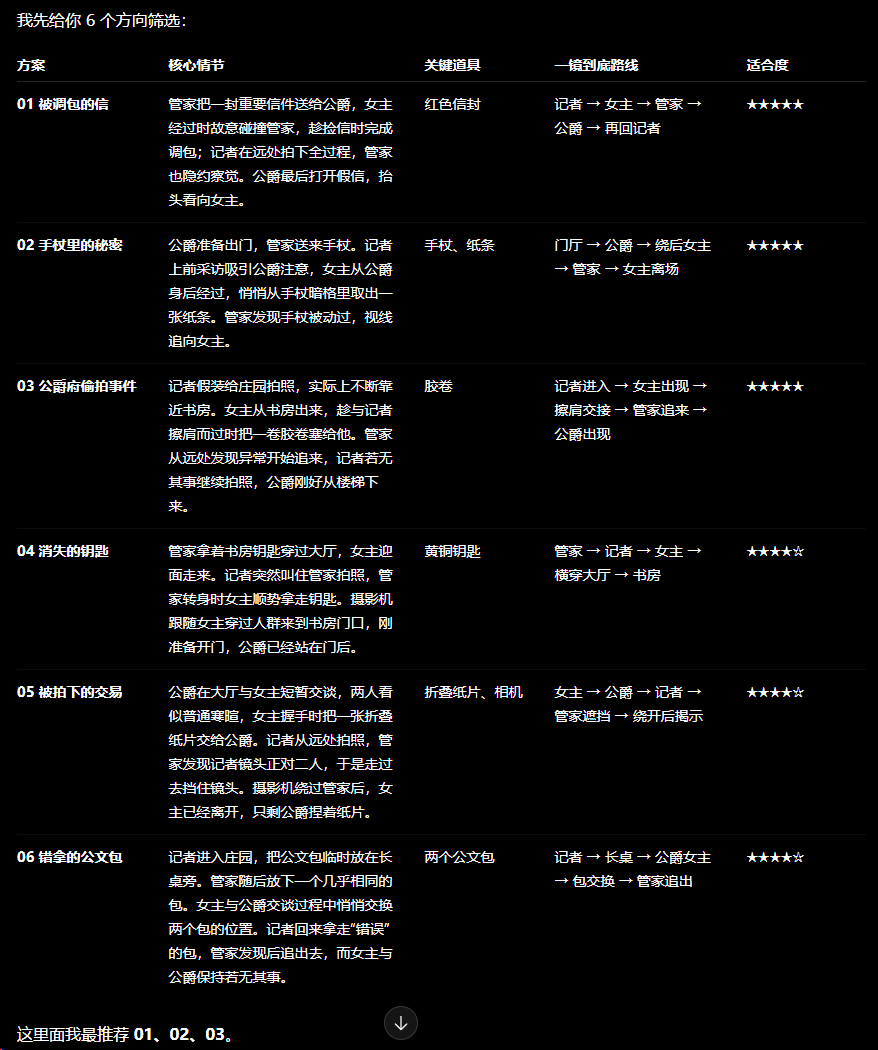
AI给我的几个剧本
这里我第一次拿到的剧本其实并不满意。
问题不在于剧情完全不能用,而是开头太正常了。
如果一个30秒视频前几秒只是人物进入大厅、管家走出来、摄影机开始跟拍,那么即使后面的调度很复杂,观众也未必愿意继续看。
所以我额外增加了一个要求:
开场从女主的腿开始拍。
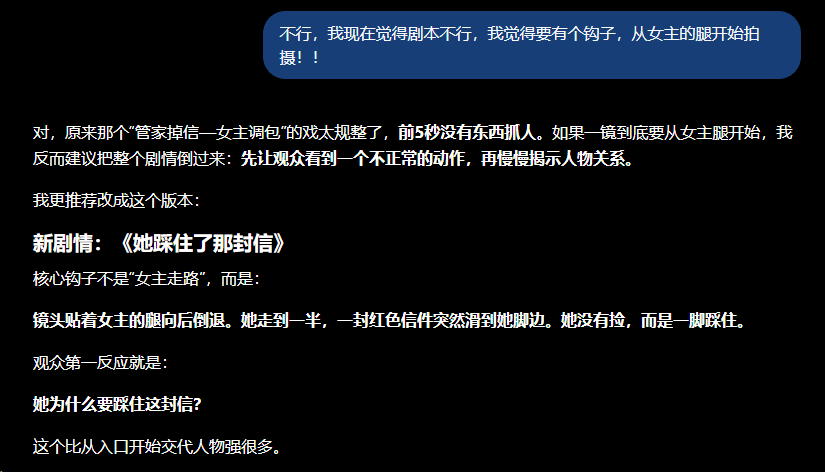
直接让ChatGPT修改
最终我把开头设计成:
女主向前走,一封红色信件突然滑到她脚边,她直接一脚踩住。
这件事发生以后,观众马上会产生一个问题:
她为什么要踩住这封信?
后面的剧情再继续解释,这封信来自管家、女主偷偷把它拿走、最终交给公爵,而记者则在远处拍下这一切。
这就是我认为AI写剧本时很重要的一步。
AI先帮你解决结构,但钩子不一定要全部交给AI决定。
你完全可以先选择一个大方向,再自己加入一个更有视觉吸引力的动作。
二、别看到剧本就开做,先验证30秒能不能真的拍完
AI写出的“30秒剧本”,不代表真的可以在30秒里完成。
因为文字里的“女主走过去”“摄影机绕到侧面”“管家停下来寻找”,读起来只有一句话,但真正变成视频以后,每个动作都需要时间。
尤其是一镜到底。
它不能依靠剪辑直接从A点跳到B点。
人物走过去需要时间,摄影机移动过去也需要时间。
所以选定剧情以后,我会再单独问AI一次(假如大家想做更长的剧本,可以不做限制):
请重新检查这个一镜到底剧本是否真的可以在30秒以内完成。不要只按照文字长度判断,请按照真实人物行走速度、人物动作耗时、动作之间的停顿、摄影机移动距离、摄影机环绕和升降机位所需要的时间进行判断。如果30秒内过于拥挤,请告诉我哪些地方应该压缩,但不要破坏核心剧情和开场钩子。
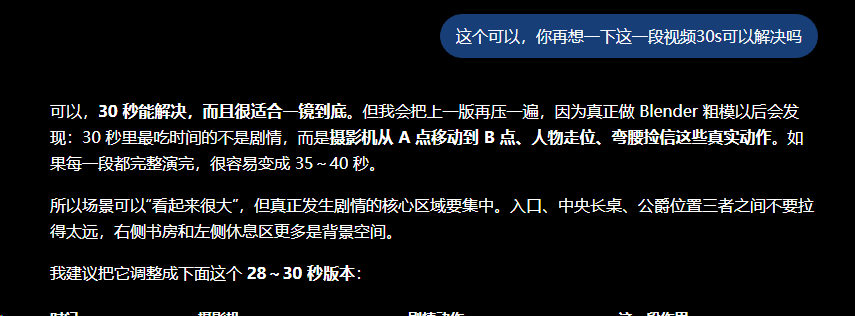
确认时长以后,我还会再让AI对整段剧本做一次专门针对Blender预演的优化。
这里可以直接使用下面这条提示词:
现在确定使用这版剧情,请不要改变核心事件和人物关系,帮我把它进一步完善成一段30秒以内可以真实执行的一镜到底运镜剧本。请同时考虑人物调度与摄影机调度,不要只写剧情。按照视频实际发生的顺序,明确每一阶段人物从哪里开始、向哪里移动、什么时候停下、与谁发生动作,以及摄影机此时位于人物什么方向。摄影机需要有明确的空间运动和高度变化,包括低机位跟随、横移、绕人物抬升、跟随动作下降、重新抬升、向前跟拍以及最后围绕公爵完成信息揭示。所有运镜都必须由剧情推动,不要为了炫技增加没有叙事作用的环绕。同时检查人物和摄影机之间的距离,避免30秒内出现移动范围过大、人物来不及走到指定位置的问题。最终把剧情、人物动作、人物视线、空间位置、摄影机方向、摄影机高度变化和最终落点整合成一份连续的一镜到底执行脚本。不要使用表格。
这样得到的就不再只是一个普通剧本,而是一份已经开始接近预演脚本的内容。
脚本链接如下:
https://superi.mfdemo.cn/chaoji/2026/09/14/6aa7ccbf3ef5a.rar
三、先做一张3D调度图,把文字变成空间
文字剧本确认以后,我没有马上让GPT 6 Astra制作Blender。
因为这时候还有一个问题:
我们知道故事怎么发生,但还没有真正看到人物在空间里到底站在哪里。
所以我先让AI制作一张3D半俯视调度图。
我给出的要求很简单:
你先给我俯视调度图吧,要有人物站位以及摄影机路线,用简单的方块就行。做成一个半俯视3D示意图,图中有简易的一些场景模型,不同人物使用不同颜色区分,同时标出人物移动路线和摄影机完整运动路线。调度必须按照刚才确定的剧本,不要重新设计剧情。
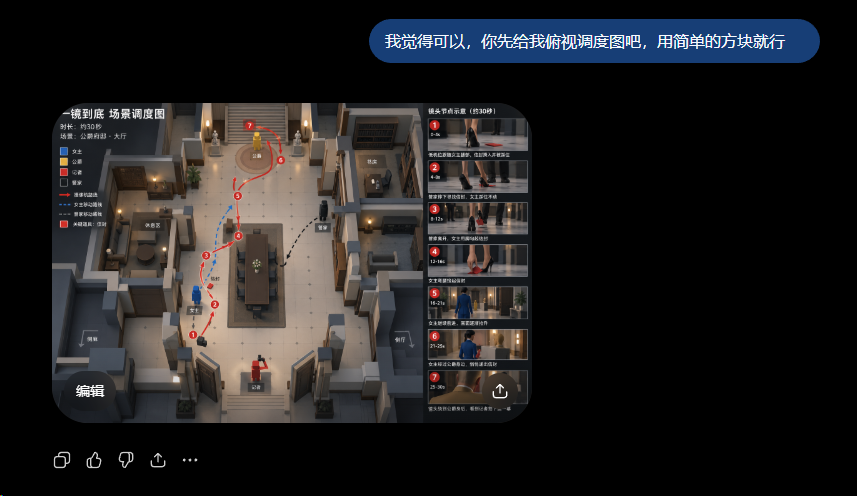
假如你的AI是ChatGPT,那么他会直接调用image2.5去给你出一张图,假如不是ChatGPT,你可以让AI直接给你提示词,然后去其他平台生成
这里不需要追求好看。
甚至人物就应该是方块。
因为这张图的任务只有一个:
检查空间关系。
比如这次的剧情里,需要同时看清女主的路线、管家从哪个方向出现、公爵站在哪里、记者应该处于哪个背景位置,以及摄影机从低机位开始以后,大致沿着什么方向继续深入大厅。
得到图片以后,不要直接进入下一步。
先自己检查一次。
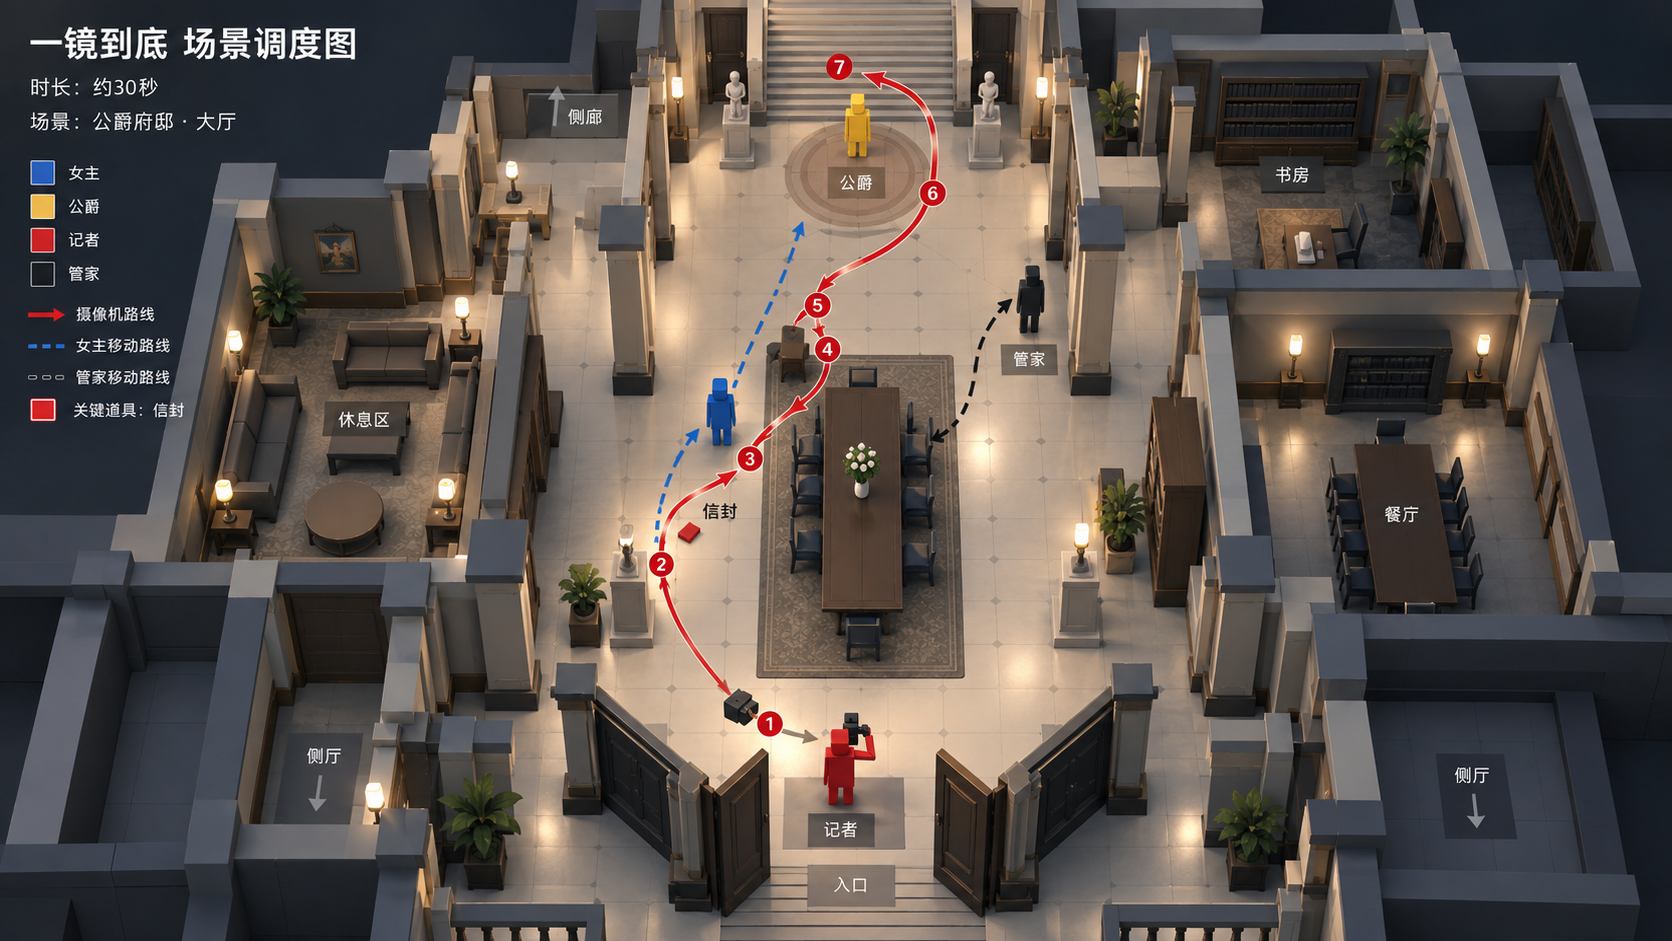
尤其关注三个问题:
摄影机有没有不必要的折返?人物会不会互相挡住?最后从公爵身后看到记者的角度是否成立?
如果图里的关系和自己想的不一样,就在这个阶段修改。
因为修改一张调度图远比Blender已经K完30秒动画以后再修改轻松。
四、场景不要只做“漂亮图”,要做空间规划资产
人物调度确定以后,我才开始真正设计场景。
这里和普通AI场景图的制作方式稍微有些不同。
以前我们可能会直接生成一张非常漂亮的大厅正面图。
但是对视频参考生成,这类图的问题是:
它很好看,却不一定告诉你整个场景到底长什么样。
所以这次我要求的是:
45°俯视场景空间规划图。
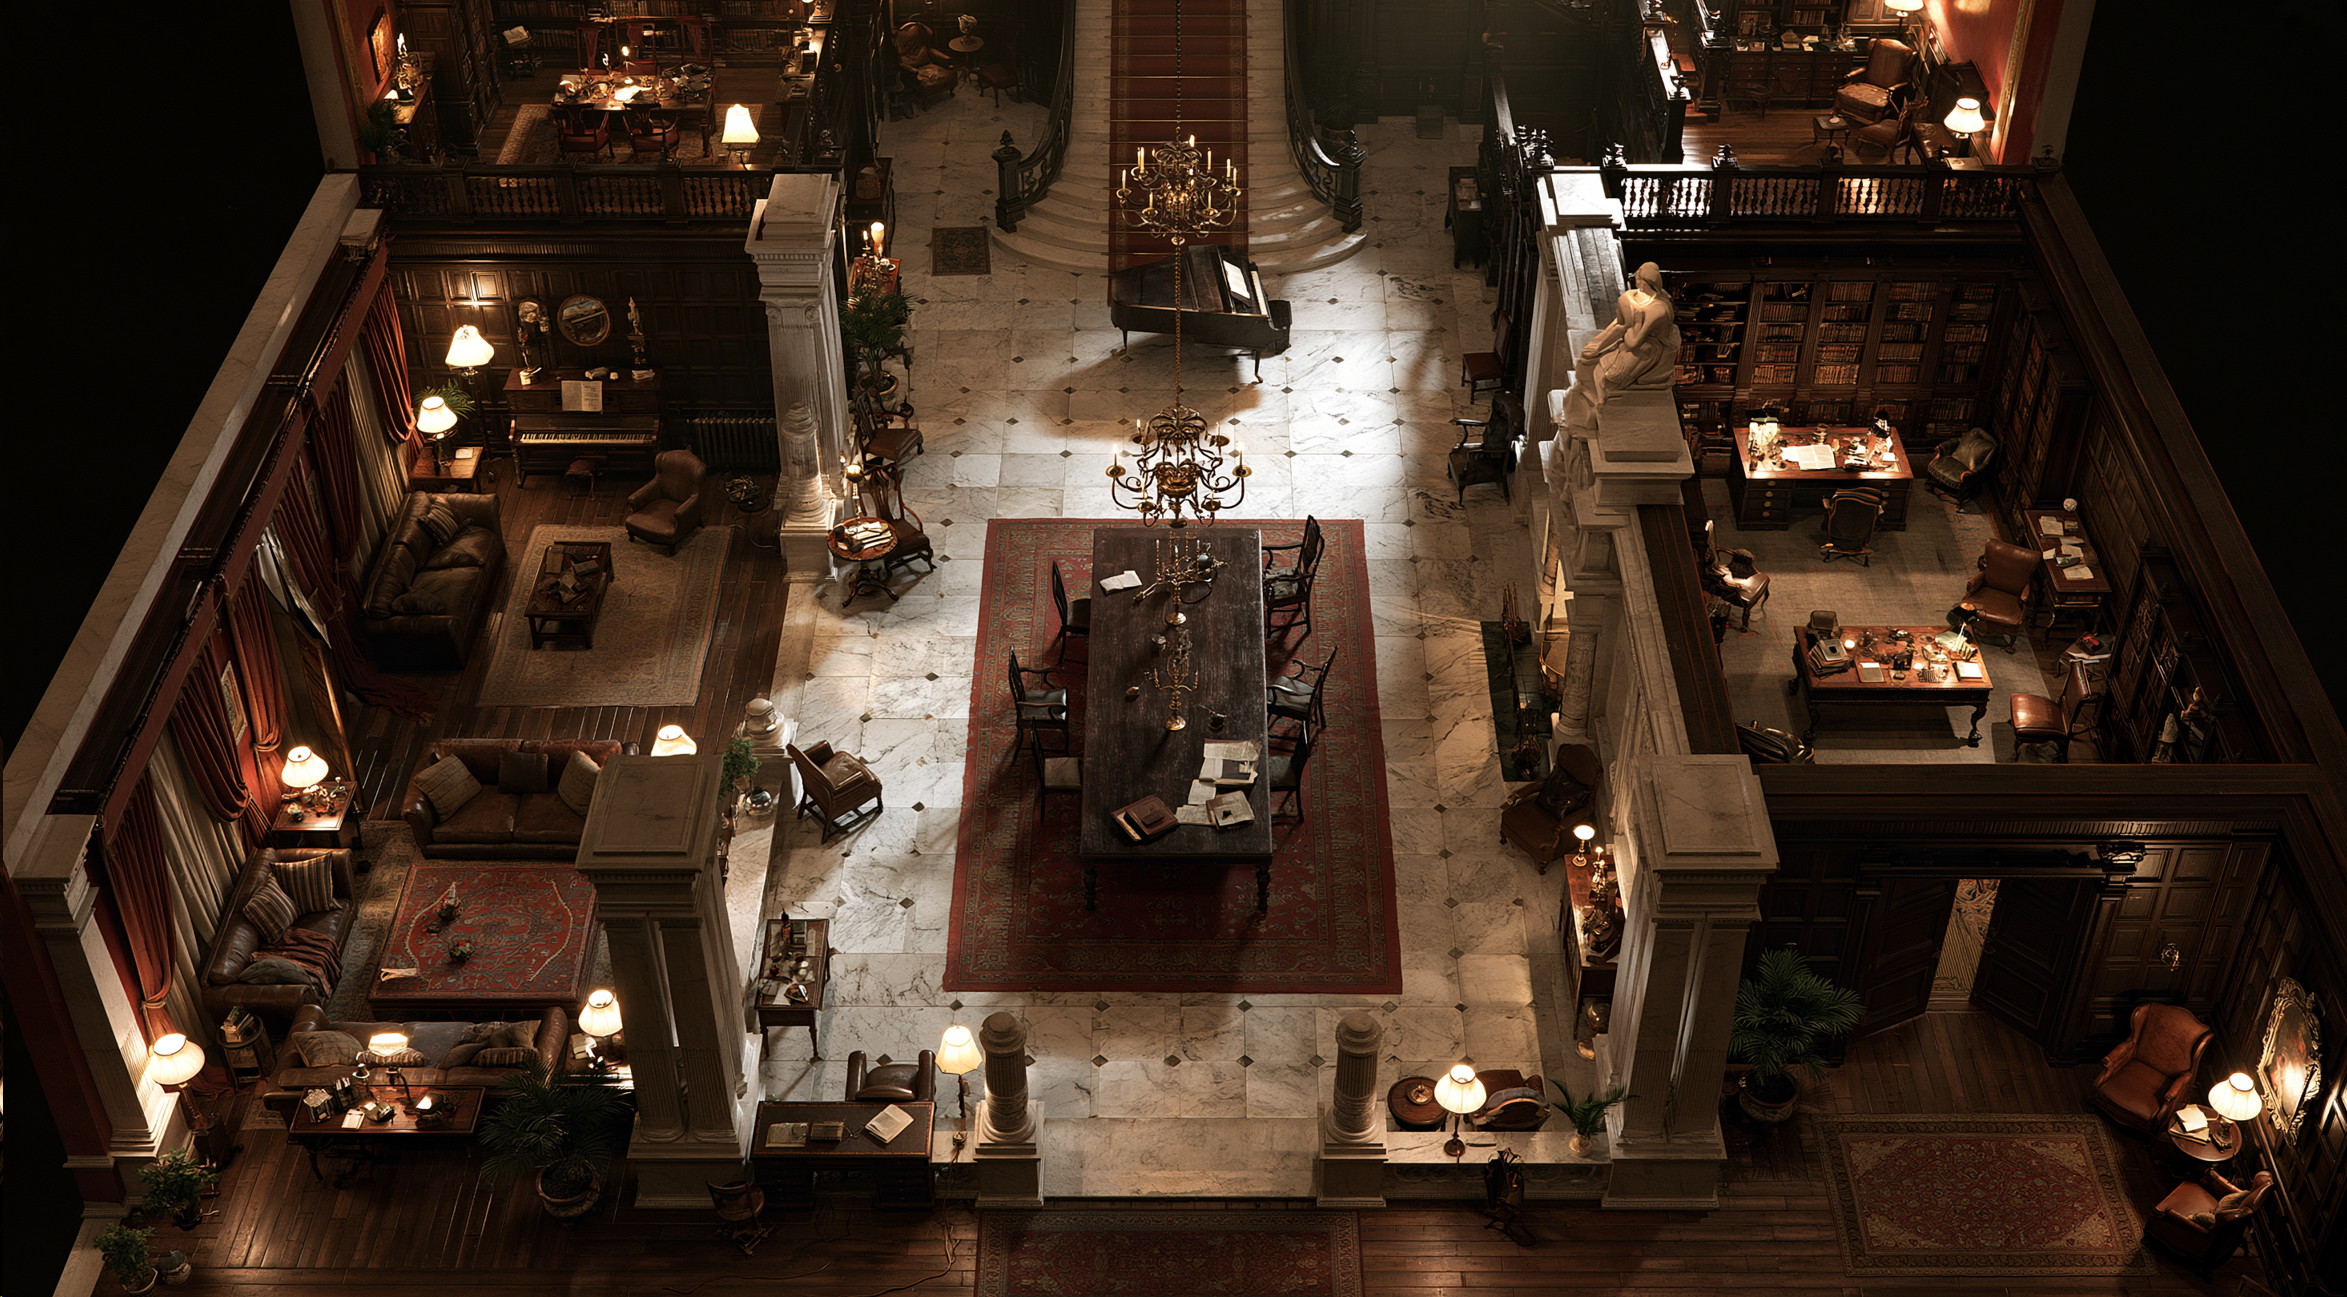
既能够看到大厅整体布局,又能看到家具和建筑的高度。
我让AI先根据剧本帮我整理场景,然后要求它输出一条精简的Midjourney V8.2提示词。
例如这次的方向就是(使用Midjourney生成):
45° bird’s-eye view of a grand 1930s European duke mansion hall, spacious rectangular layout, central dark wood table, lounge area on the left, open study on the right, grand staircase at the far end, marble floor, dark wood paneling, vintage furniture, elegant aristocratic atmosphere, cinematic realistic interior, clear spatial layout, warm soft lighting, no people, architectural visualization, high detail --ar 16:9 --v 8.2
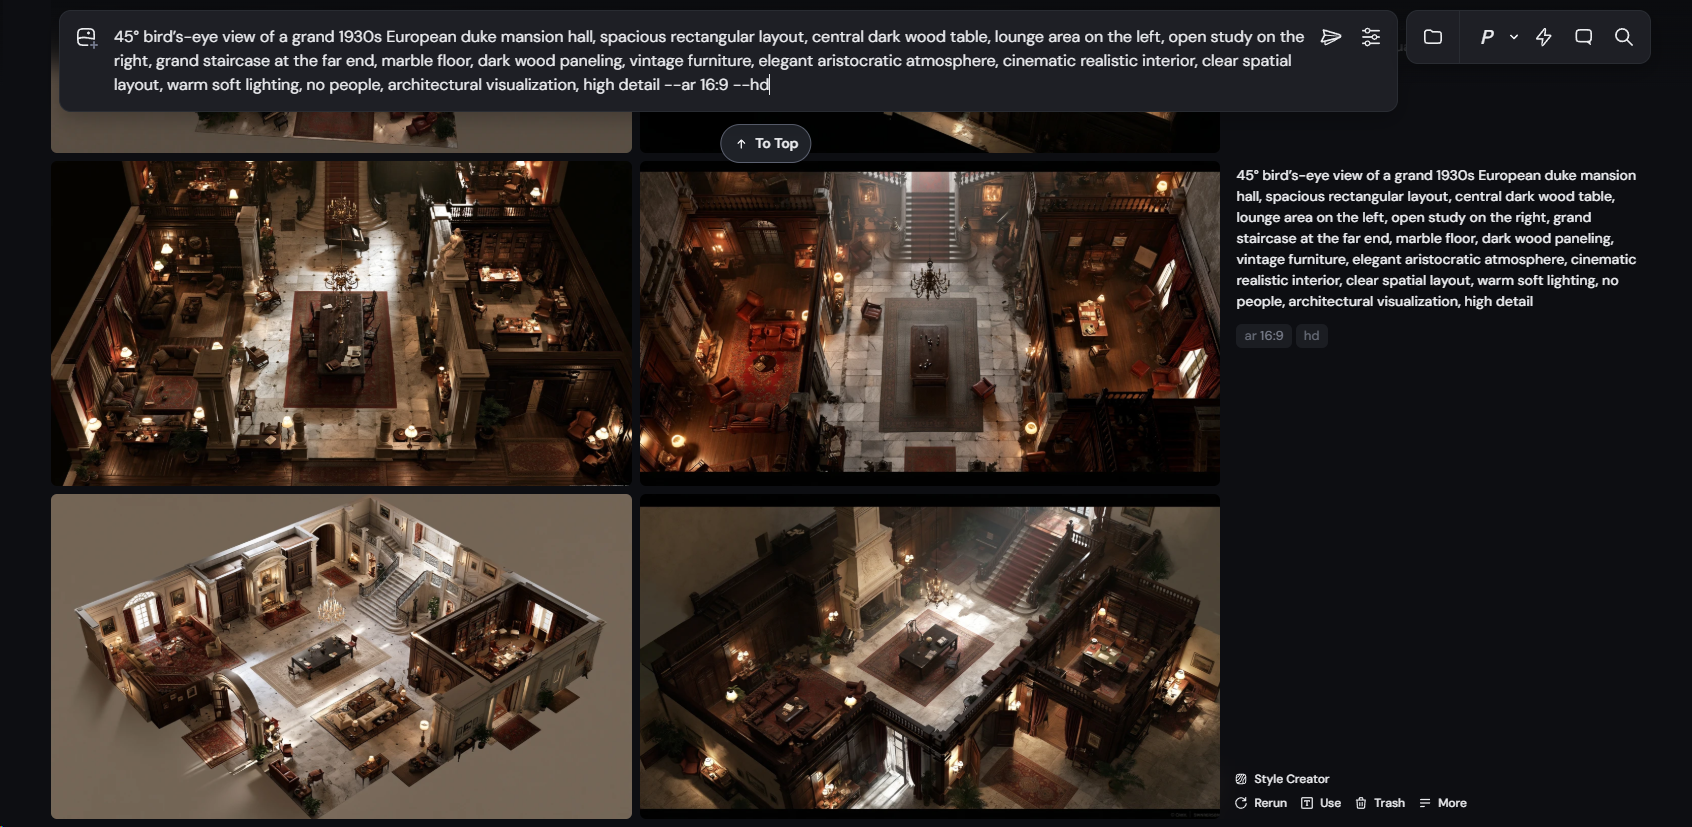
这种45°俯视图有一个很大的优势:
它既不是完全垂直的平面图,也不是只能看到局部空间的电影镜头。
一张图就能同时提供空间结构、家具位置、视觉风格和整体纵深。
可以作为Seedance 2.5的场景参考资产。
五、真正关键的一步:让GPT 6 Astra先在Blender里“拍一遍”
到这里,我们已经有了俩份非常关键的信息:
完整的一镜到底剧本与运镜、3D半俯视调度图。
接下来才进入这次流程最重要的部分,打开codex,新建一个消息。
把这些资料一起交给GPT 6 Astra,让它直接使用Blender搭建一个非常简单的粗模场景。
这里千万不要一上来要求精细建模。
我们不是要让Blender生成最终画面。
Blender只负责解决摄影机。
我这次使用的提示词逻辑是:
图1是我生成的3D调度图,图2是场景空间参考图,实际人物调度、剧情和运镜以我下面提供的一镜到底剧本为准。请使用Blender帮我搭建一个用于电影Previs预演的粗模场景,并制作完整的一镜到底摄影机动画。不需要精细建模。人物使用一个长方体作为躯干、一个球体作为头部即可,不同人物使用明显不同的颜色区分。场景同样以简单几何体和方块搭建,3D调度图只作为空间关系辅助,如果图片与文字剧本发生冲突,以文字剧本为准。最终完成30秒左右的Blender动画并输出一段可以作为AI视频模型运动参考的视频。
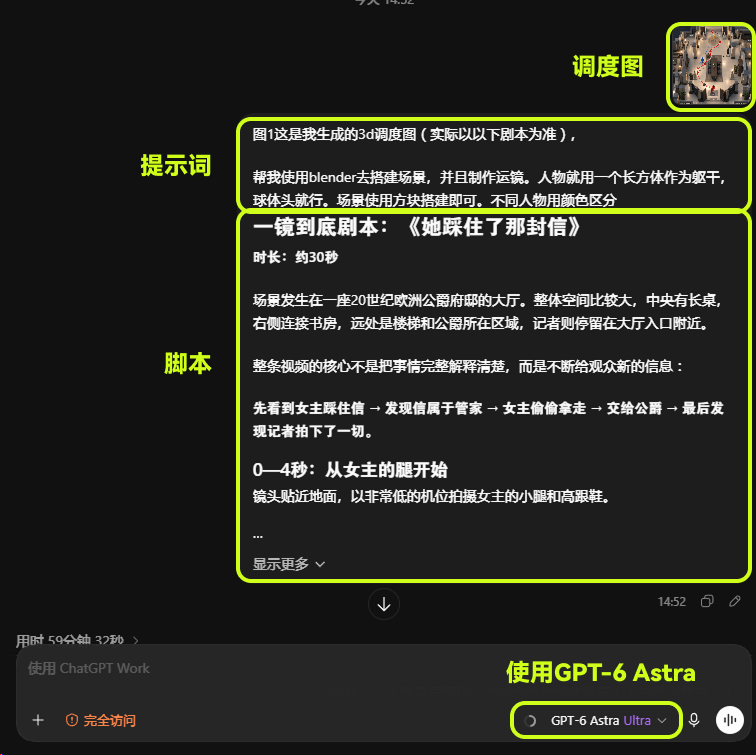
接下来GPT 6 Astra会通过代码完成场景搭建、人物方块、Camera、路径以及关键帧。
这也是整套流程中等待时间比较长的一步。
我这次实际制作时,等待了大约半小时到一小时。
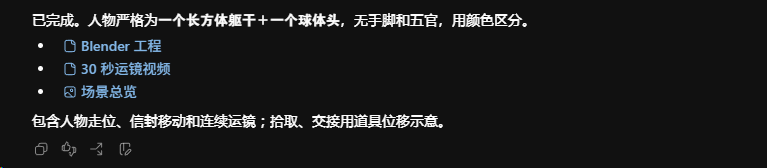
但真正得到那段Blender视频以后,你会发现前面的工作都开始有意义了。
因为原本只能靠文字想象的:
摄影机从哪里开始、什么时候下降、什么时候抬起来、女主走多远、最后怎么绕到公爵背后……
现在已经全部变成了一段能够直接播放的视频。
哪怕它只是方块。
blender工程如下
https://superi.mfdemo.cn/chaoji/2026/09/14/6aa7d4460218b.rar
六、最后再让Seedance 2.5负责“把粗模变成电影”
Blender粗模视频出来以后,接着刚才的聊天,把最终需要使用的全部素材再次整理清楚。
这次我准备的是:
视频1负责运镜与人物调度。
图1负责女主身份和服装。
图2负责公爵。
图3负责管家。
图4负责记者。
图5负责场景。
然后让AI根据这些素材,重新生成一份符合Seedance 2.5的视频提示词。
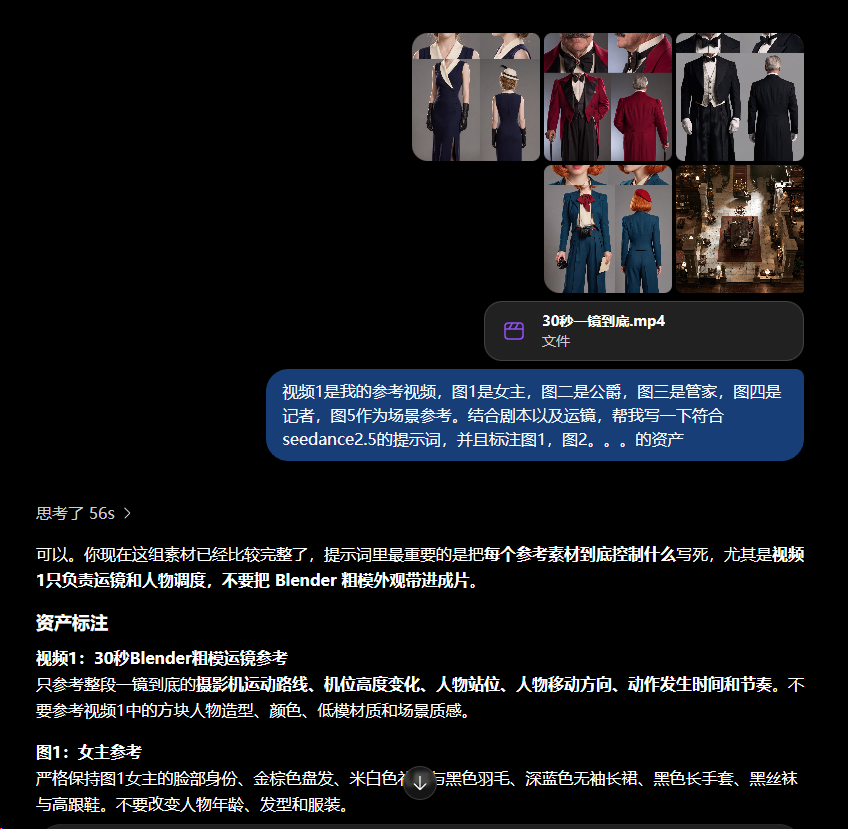
我使用的是:
视频1是我的参考视频,图1是女主,图2是公爵,图3是管家,图4是记者,图5作为场景参考。结合我们前面已经确定的剧本以及视频1中的运镜,帮我写一份符合Seedance 2.5的视频提示词,并且明确标注图1、图2、图3、图4、图5以及视频1分别控制什么。视频1只参考摄影机运动、人物站位、人物移动、动作发生顺序和时间节奏,不参考其中的Blender低模造型与材质。人物身份分别严格参考对应图片,场景空间和视觉风格参考图5。提示词按照视频真实发生顺序连续描述,重点写清人物动作、摄影机运动、机位高度变化、视线、空间关系以及最后的画面状态。全程保持一镜到底,不切镜,不新增剧情。
这里有一个非常重要的原则:
不同素材必须分工。
不要简单告诉模型“参考这些素材”。
因为视频参考里的方块人物只是用来控制动作和运镜,如果不说明,很容易让不同参考之间互相影响。
所以应该明确:
视频管运动,人物图管身份,场景图管环境。
最后把生成好的Seedance 2.5提示词、人物图片、场景图片和Blender运镜视频一起上传,直接生成。
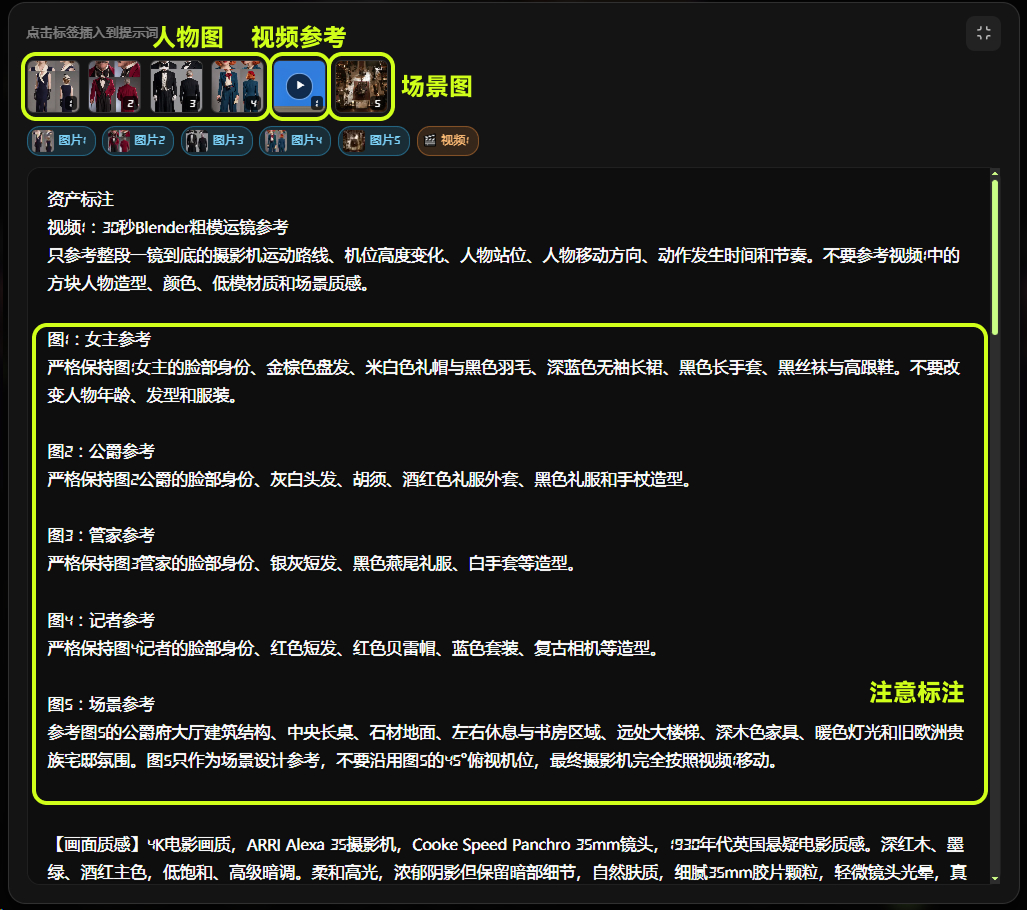
AI给我的提示词如下:
资产标注 视频1:30秒Blender粗模运镜参考
只参考整段一镜到底的摄影机运动路线、机位高度变化、人物站位、人物移动方向、动作发生时间和节奏。不要参考视频1中的方块人物造型、颜色、低模材质和场景质感。
图1:女主参考 严格保持图1女主的脸部身份、金棕色盘发、米白色礼帽与黑色羽毛、深蓝色无袖长裙、黑色长手套、黑丝袜与高跟鞋。不要改变人物年龄、发型和服装。
图2:公爵参考 严格保持图2公爵的脸部身份、灰白头发、胡须、酒红色礼服外套、黑色礼服和手杖造型。
图3:管家参考 严格保持图3管家的脸部身份、银灰短发、黑色燕尾礼服、白手套等造型。
图4:记者参考 严格保持图4记者的脸部身份、红色短发、红色贝雷帽、蓝色套装、复古相机等造型。
图5:场景参考 参考图5的公爵府大厅建筑结构、中央长桌、石材地面、左右休息与书房区域、远处大楼梯、深木色家具、暖色灯光和旧欧洲贵族宅邸氛围。图5只作为场景设计参考,不要沿用图5的45°俯视机位,最终摄影机完全按照视频1移动。
【画面质感】4K电影画质,ARRI Alexa 35摄影机,Cooke Speed Panchro 35mm镜头,1930年代英国悬疑电影质感。深红木、墨绿、酒红主色,低饱和、高级暗调。柔和高光,浓郁阴影但保留暗部细节,自然肤质,细腻35mm胶片颗粒,轻微镜头光晕,真实景深,画面通透稳定。
【画面内容】 生成一段约30秒的电影写实一镜到底视频。严格以视频1作为整段摄影机轨迹、机位高度、人物空间位置、移动方向和时间节奏参考,保持视频1从低机位开始、逐渐抬升、跟随女主深入大厅、最后环绕公爵并揭示远处记者的整体运动逻辑。全程禁止切镜,摄影机连续、稳定、自然运动,不复制视频1中的Blender方块造型和低模视觉。
场景严格参考图5,是一座20世纪上半叶欧洲公爵府邸内部大厅,宽阔挑高的空间,浅色石材地面,深木色墙板与家具,中央大型长桌,左右分布休息区和书房,远处为宽阔庄重的大楼梯。暖色古典灯具形成柔和局部照明,空间深处略暗,带有克制、优雅、略微悬疑的电影氛围。真实电影布景质感,细腻自然材质,轻微胶片感,人物与环境保持统一光线。
0—4秒。
按照视频1开场机位,从极低视角开始,摄影机距离地面约30—40厘米,近距离正对图1女主膝盖以下的双腿和高跟鞋,并随着她向前行走平稳向后滑动。开场暂时不要看到女主完整脸部,画面重点是她的高跟鞋、黑丝袜、裙摆下缘和大厅石材地面。女主步伐从容而明确。
摄影机继续倒退时,一个小型深红色信封从画面右前方滑入女主行走路线。女主察觉后没有明显慌张,她原本迈出的脚顺势落下,准确踩住红色信封,将它藏在鞋底下方。摄影机在这一瞬间轻微减速,但不要停死。
4—8秒。
继续严格跟随视频1的低机位运动。图3管家从画面右侧进入女主附近,他刚刚从书房方向经过,发现自己遗失了东西,停下来低头寻找,并且管家画外音小声念叨 :“Where's the envelope?”
摄影机做轻微横向滑动,让女主的双腿保持前景主体,同时把管家的腿部和部分身体自然带入画面。女主保持镇定,踩住信封的脚没有移动,身体没有夸张反应,只是短暂观察管家。
管家在附近寻找片刻,没有发现信封,随后转身继续向大厅深处离开。
8—12秒。
按照视频1摄影机轨迹,从女主侧面开始做自然的小幅环绕,同时摄影机由低机位持续缓慢上升。
镜头依次从女主鞋子、小腿、腰部升到上半身,最终第一次完整揭示图1女主的脸部和造型。保持图1人物身份与服装完全一致。
女主的视线短暂追随离开的管家,确认对方没有回头后才收回视线。她的表情平静、克制,不要做明显偷窃式紧张表演。
12—16秒。
管家已经走远。女主轻轻抬起踩住信封的脚,用鞋尖将深红色信封悄悄向自己身后勾动一点。
她随后自然弯腰,动作看起来像短暂整理鞋子或裙摆,而不是直接明显地捡东西。
摄影机按照视频1同步下降并靠近她的动作区域,使红色信封重新成为视觉重点。女主戴着黑色手套的手迅速拿起信封,把信封贴近身体隐藏起来,没有打开查看。
女主重新站直,摄影机随人物身体同步平稳抬升,恢复正常人物跟拍高度。
16—21秒。
女主继续若无其事地向大厅深处行走。
摄影机按照视频1开始与女主保持稍远距离的连续跟随,画面逐渐从局部人物近景扩大为能够看清大厅空间的中景。随着向前移动,中央长桌从侧面经过,远处楼梯和站在楼梯前方的图2公爵逐渐进入画面。
图2公爵保持威严、冷静的姿态,人物身份、酒红色礼服和手杖造型保持一致。
入口区域的图4记者此时可以极小地存在于远景背景中,但不要主动强调她,让观众暂时不会立刻注意。
21—25秒。
女主继续朝公爵方向行走,不停下来与他正面对话。
摄影机按照视频1靠近两人,并轻微向侧面弧形移动,为二人的擦肩动作留出清晰视角。
女主经过公爵身旁的一瞬间,两人没有明显对视,也没有大幅度手势。女主靠近公爵一侧的手自然下垂,在身体交错产生遮挡的一瞬间,将刚刚取得的深红色信封秘密递进公爵手中。
整个交接动作控制在约一秒,隐蔽、克制、自然,像事先约定好的秘密交接,不要表现成正式递信。
女主完成交接后继续向前离开,没有回头。
25—28秒。
摄影机不再继续跟随女主,而是按照视频1的路径逐渐减速并将运动中心转移到图2公爵。
镜头开始围绕公爵做连续的小幅弧形环绕。
公爵先保持原来的姿态,随后低头看到自己手中的深红色信封。他的动作明显停顿一下,神情从平静变成轻微凝重和警觉,但不要夸张震惊。
女主继续向远处离开,并逐渐退到背景。
28—30秒。
摄影机继续完成视频1最后的环绕,从公爵侧面绕到他的肩后位置。
公爵成为前景主体,他的肩膀和酒红色礼服形成自然前景遮挡。随着摄影机绕过他的身体,画面深处大厅入口方向逐渐露出图4记者。
图4记者站在远处,已经举起复古相机对准大厅内部。她刚刚拍下秘密交接,随后缓慢将相机从脸前放下,安静看向公爵方向。
摄影机最终停在公爵肩后,通过公爵前景看向远处记者,形成前后两个空间层级。
到这里直接结束,不增加新的动作,不切镜。
七、这套工作流真正解决的是什么?
把整个流程重新整理,其实只有一条主线:
先解决故事,再解决空间,最后才解决画面。
如果没有剧本,先根据人物推导剧情,并人为补充一个足够明确的开场钩子。
剧情确认以后,不要直接生成,而是检查30秒是否真的能够执行,再把人物动作与摄影机动作合并成一份完整调度脚本。
随后通过3D半俯视调度图确认人物与摄影机的空间关系,再使用45°俯视场景图把抽象空间变成可以参考的场景资产。
等这些条件都确定以后,再让GPT 6 Astra使用Blender把整段运镜做成最简单的Previs。
最终Seedance 2.5需要做的事情反而变简单了。
它不需要重新设计摄影机。
它只需要:
按照这段运镜,把方块换成真实人物,把粗模场景换成电影场景。
这才是Blender粗模在这套工作流里的真正作用。
它不是为了增加制作步骤。
而是提前把AI最难猜的那部分——空间和摄影机——先确定下来。