刚开始接触AI设计时,真正让人头疼的往往不是不会生成,而是各种名字突然一起出现:ChatGPT、Gemini、Nano Banana、GPT Image、Seedream、Seedance、提示词、多模态、文生图、图生视频、首尾帧……
这些东西看起来都和AI有关,但实际上有的是平台,有的是模型,有的是生成方式,还有的是AI本身具备的一种能力。如果这些最基础的关系没有理顺,后面学再多工具,也很容易变成“会点按钮,却不知道自己到底在用什么”。
所以这一节我们先不讲复杂技巧,也不研究模型背后的技术原理,而是把AI设计中最常见的一批基础概念一次梳理清楚。
一、先搞清楚:AI、模型和平台分别是什么
我们平时说的“AI”其实是一个非常大的概念,语音识别、自动驾驶、推荐算法都属于人工智能。
但在AI设计里,我们真正频繁接触的是生成式AI。
所谓生成式AI,可以简单理解成:根据你提供的信息,创造新的内容。
比如输入一段要求,让AI帮你写广告方案;描述一个画面,让AI生成图片;上传一张人物照片,让AI把人物放进新的场景,甚至进一步生成动态视频。这些都属于生成式AI。
而真正负责理解你的要求、生成结果的,就是我们经常听到的“模型”。
对于普通设计师来说,不需要先研究模型到底有多少参数、怎么训练,只需要知道:不同模型擅长完成不同的任务。
例如有的更擅长分析、推理和写作,有的专门负责生成图片,还有的主要负责视频。
这里又会遇到一个特别容易混淆的问题:
模型和平台不是一回事。
像ChatGPT、Gemini、即梦,更接近我们直接使用的产品或平台;
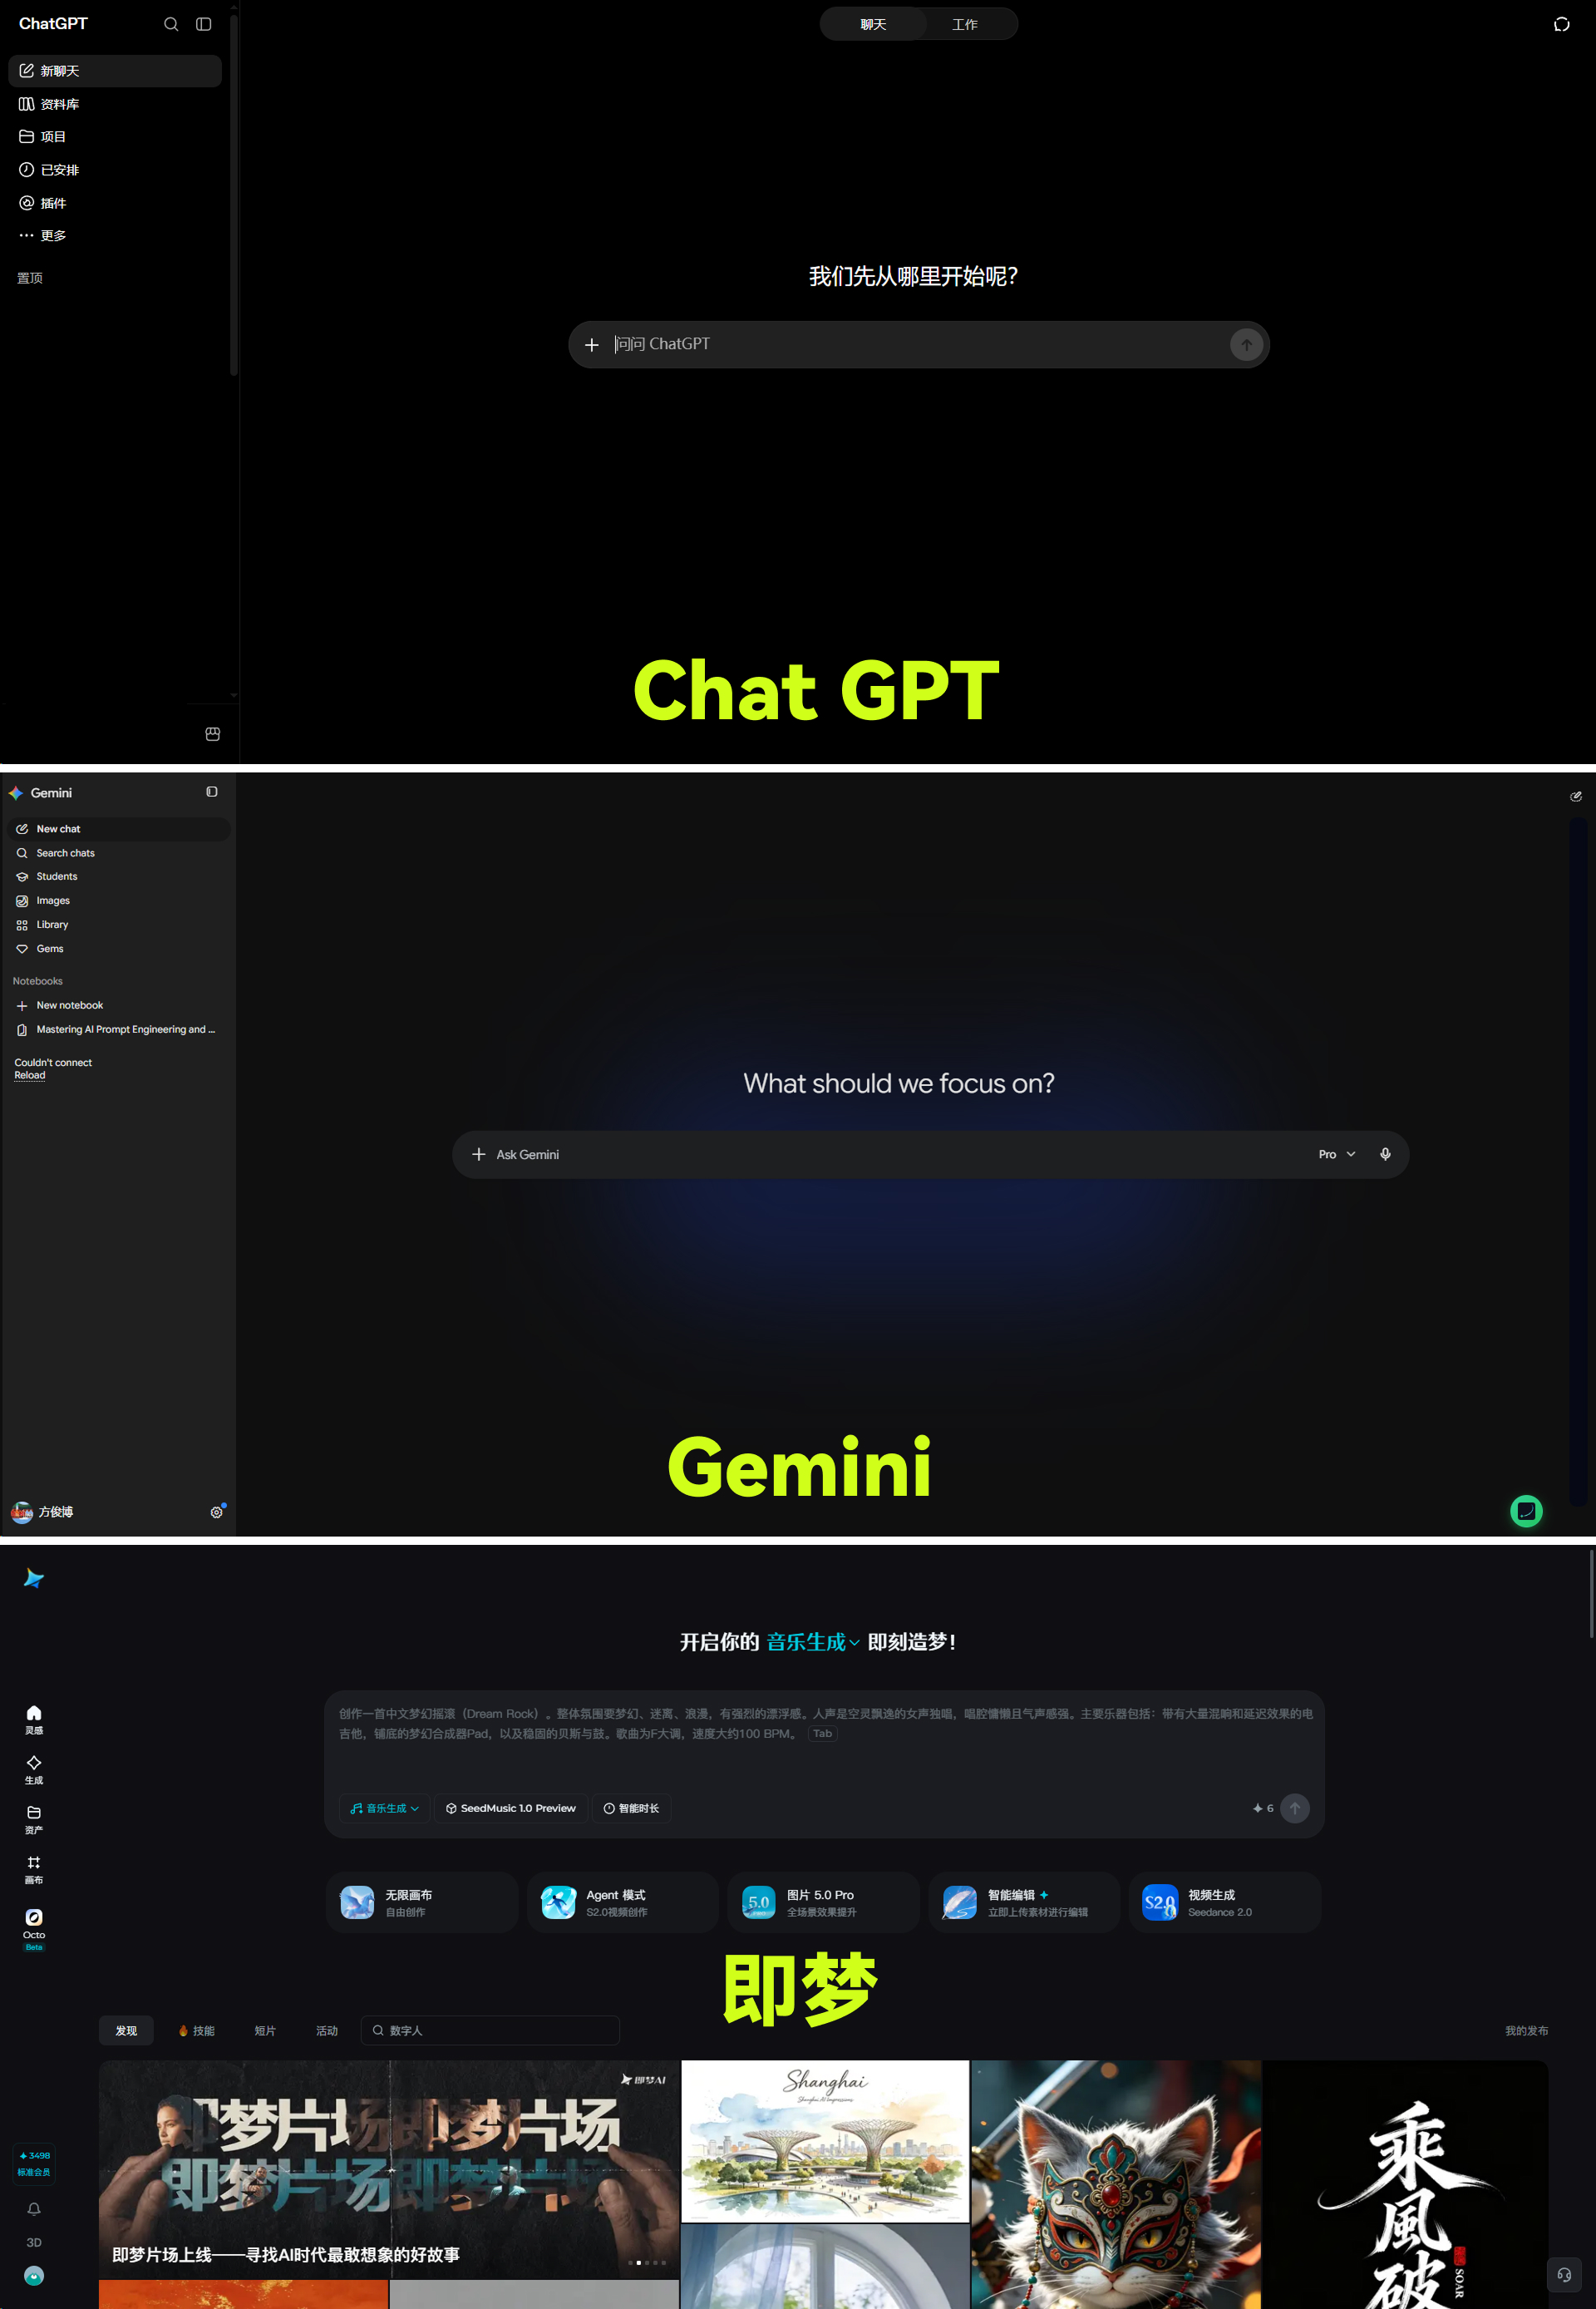
三个平台,2个大语音模型平台,一个图片视频创作平台
Nano Banana、GPT Image、Seedream、Seedance,则属于具体的模型。
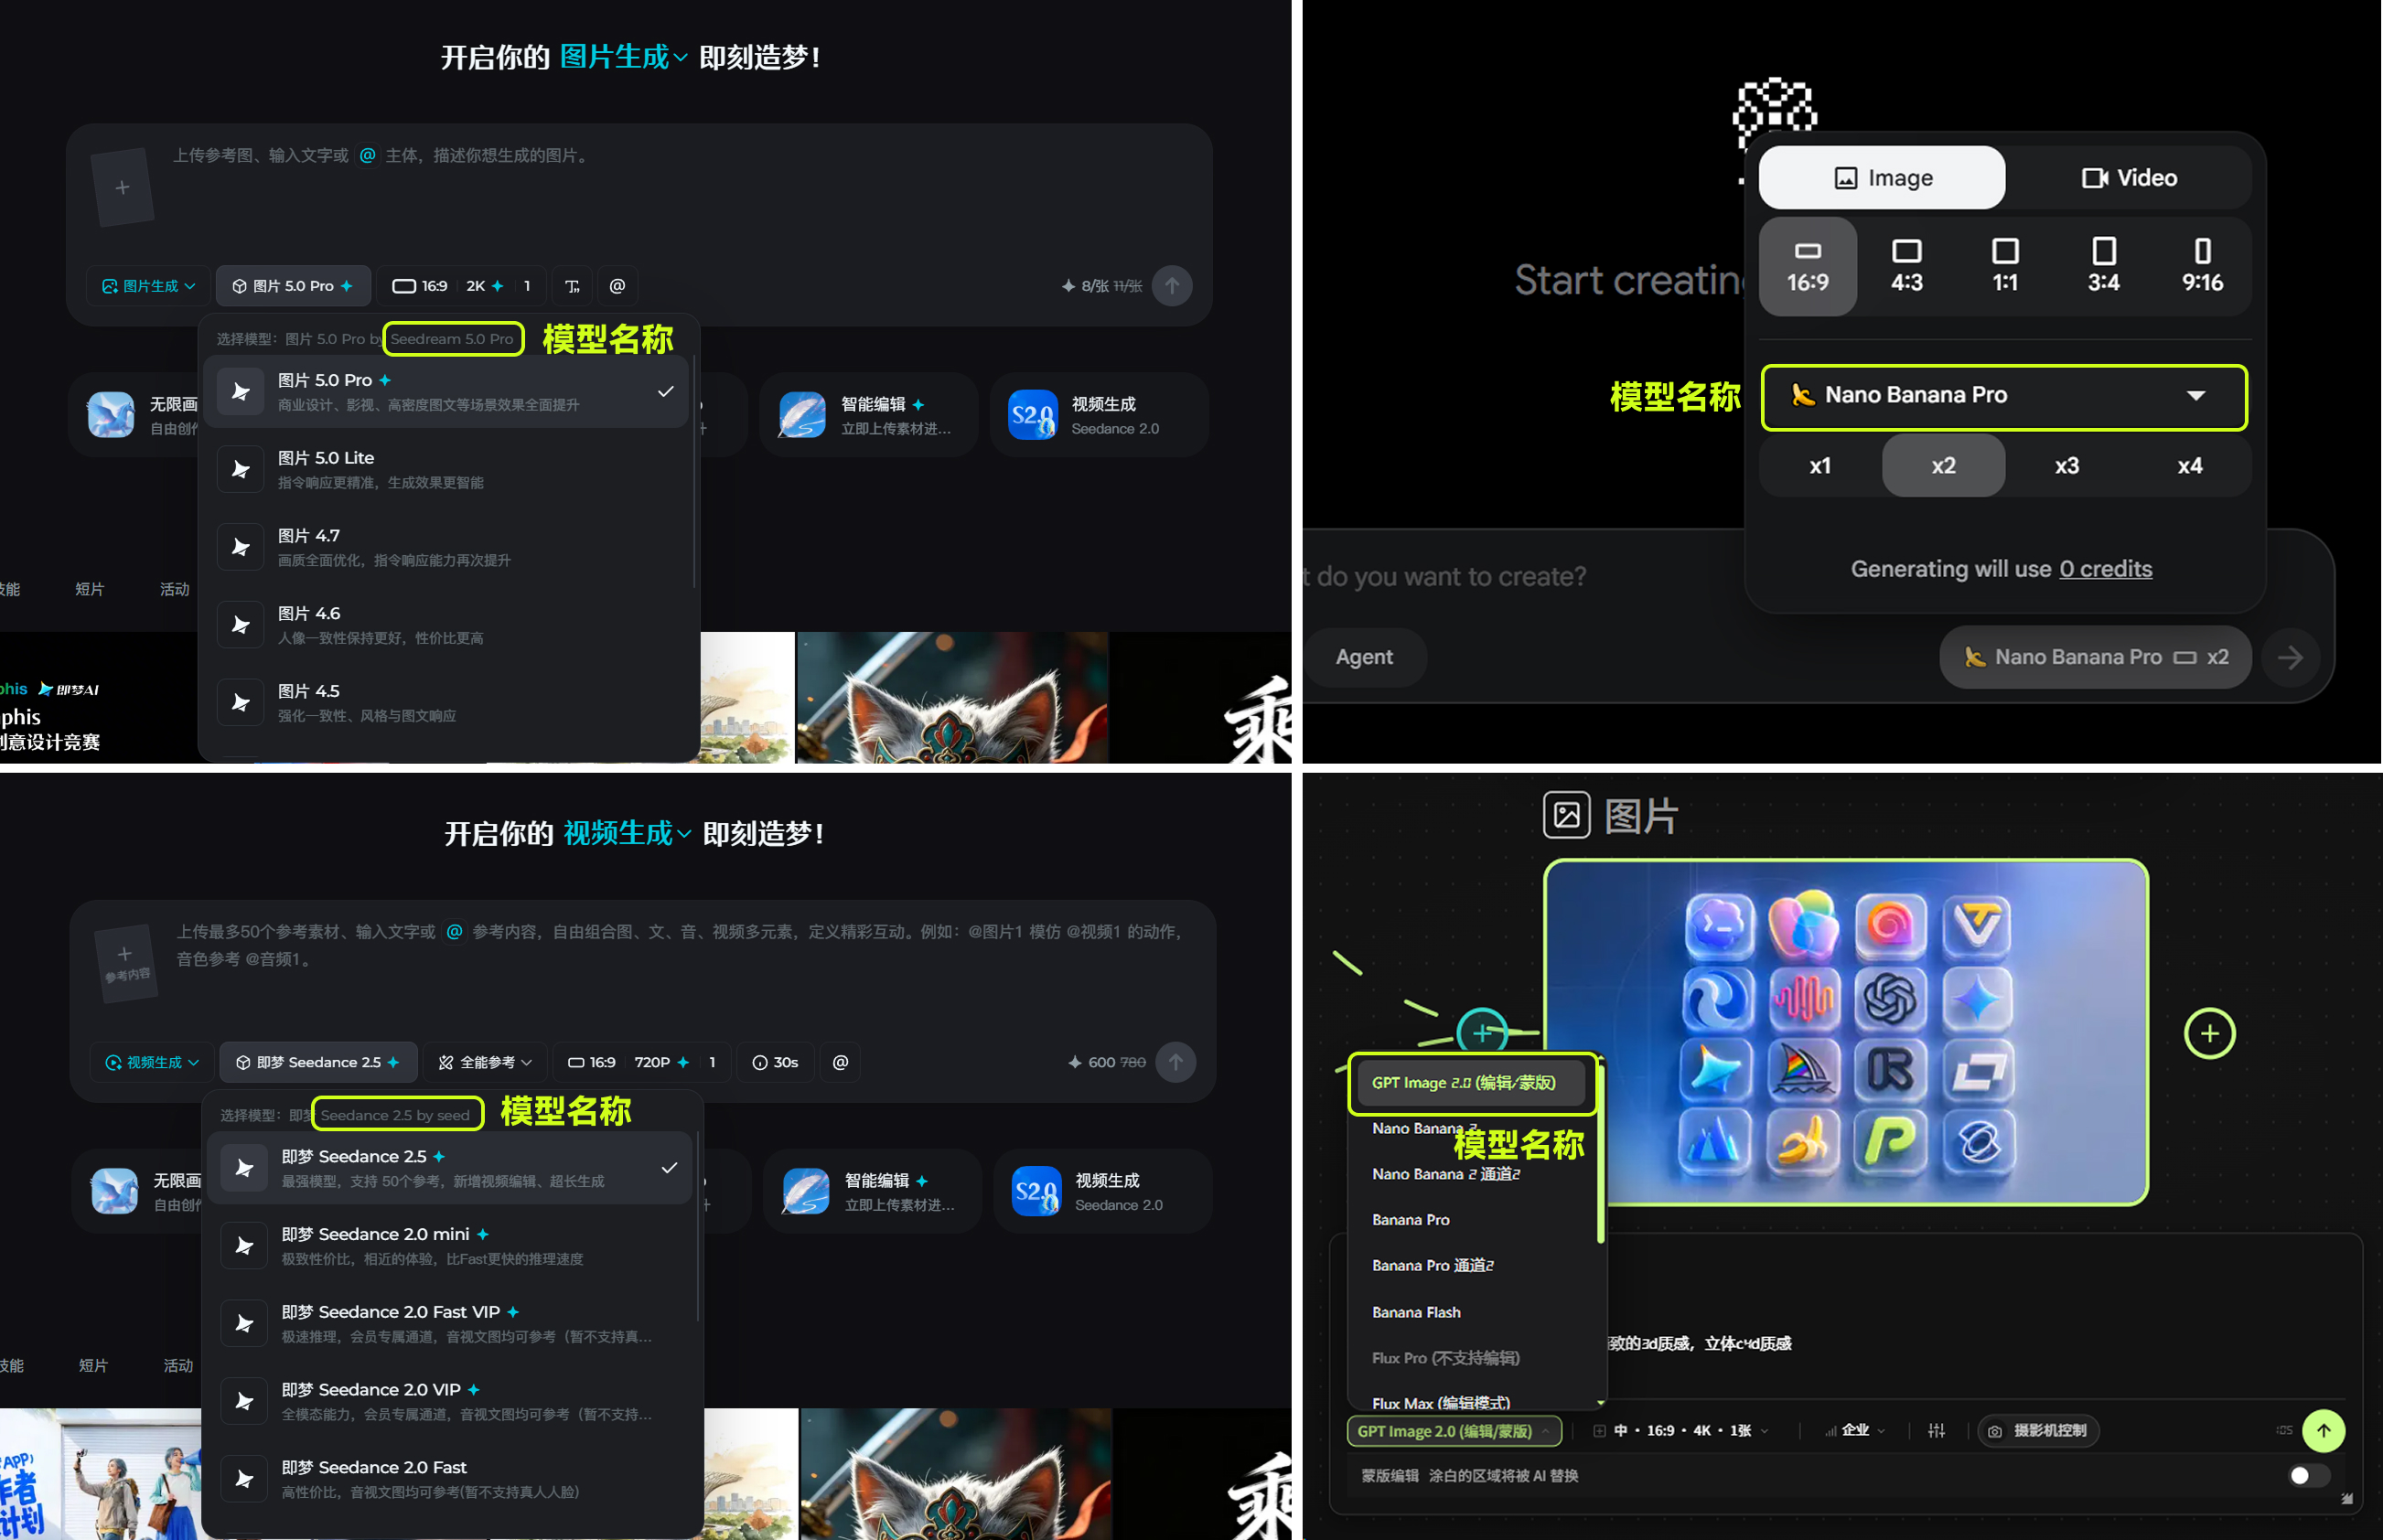
四种模型,接入到不同的平台中
可以简单理解成:
平台是你进入AI的工作空间,模型是真正帮你完成任务的能力。
现在很多平台里也会同时接入多个不同模型,所以以后看到一个新的AI名字,可以先问自己两个问题:
它是一个平台,还是一个模型?它主要负责什么?
这两个问题搞明白,基本就不会乱。
二、不同模型,到底分别负责什么
AI模型很多,但对于做设计的人来说,没有必要一开始就记住几十个名字。先按照使用场景,大致分成三类就够了。
第一类是分析、语言和推理类AI。
例如ChatGPT、Gemini、Claude这类工具,我们做设计时通常会用它们分析需求、找创意、写文案、拆脚本、分析参考图、整理提示词。
简单来说,它们更多负责:
帮你想。
第二类是图片模型。
比如Nano Banana pro、GPT Image 2.0、Seedream 5.0pro、Midjourney(目前这四个模型是最好用的),它们主要负责生成图片、修改图片、组合不同素材、调整人物服装、更换背景、制作广告视觉、电商图等。
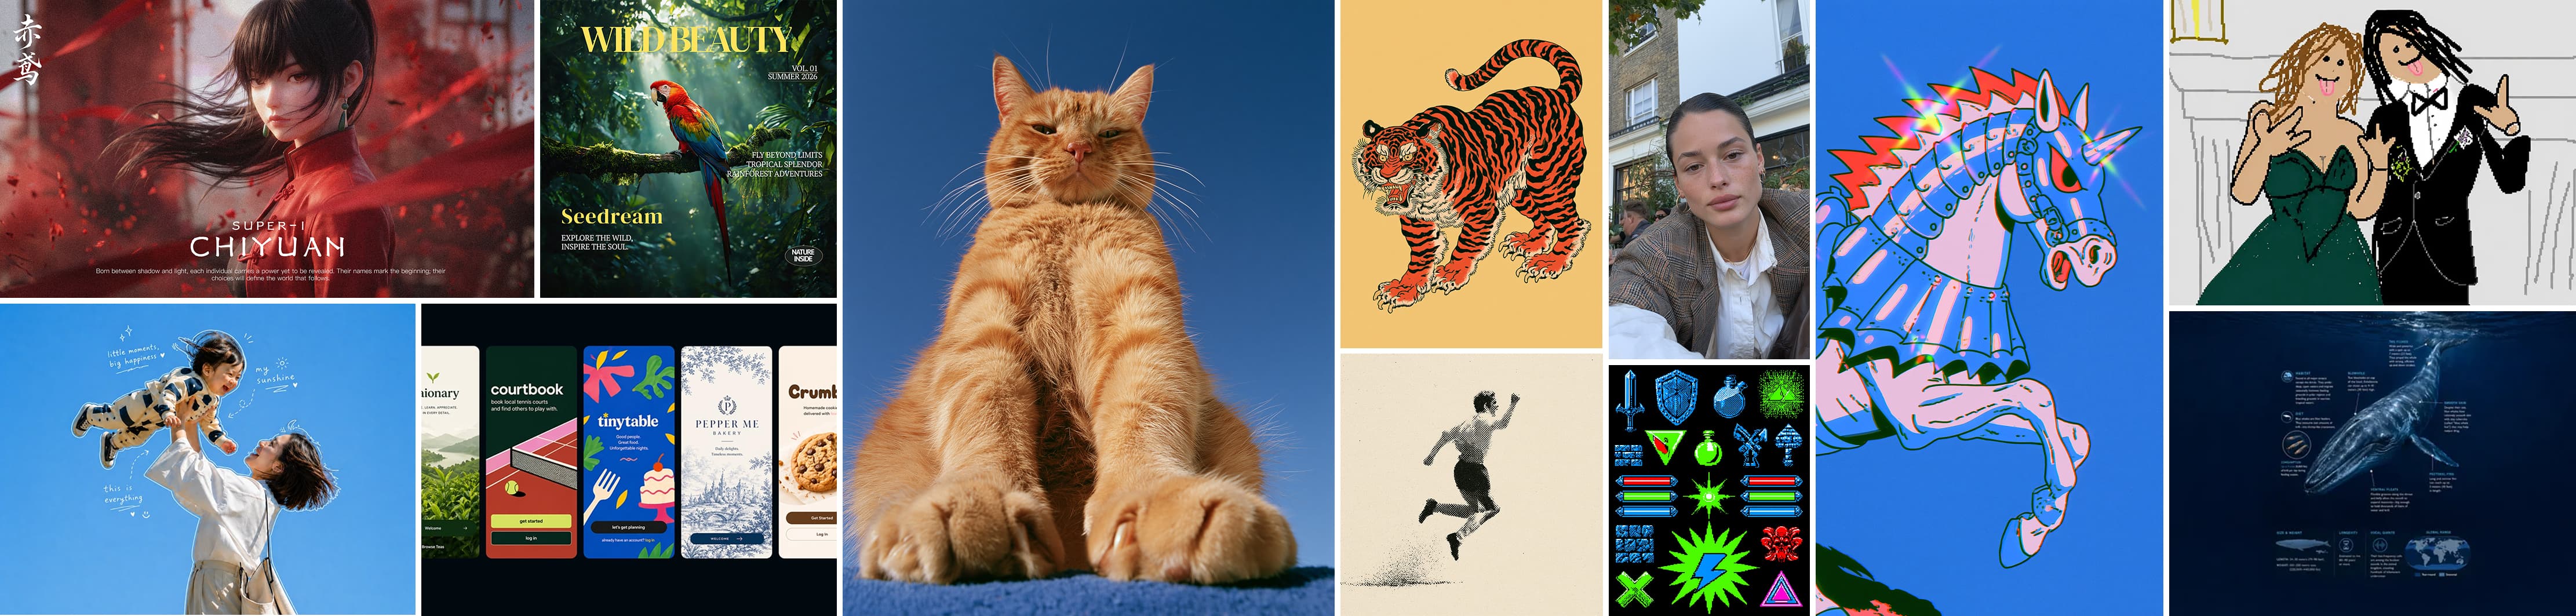
它们更多负责:
帮你做视觉。
第三类则是视频模型。
像Seedance 2.5、Minimax H3、WAN 3.0,主要负责文生视频、图生视频、首尾帧、视频参考、人物动作以及镜头运动等。
它们更多负责:
让静态画面真正动起来。
所以学AI设计并不是要把所有模型都学一遍,而是先判断自己现在缺什么。
如果还没有创意,先分析;如果已经有想法,需要做视觉,就进入图片模型;如果图片准备好了,需要变成动态画面,再进入视频模型。
先确定任务,再选择模型,比记住模型排行榜更重要。
三、多模态:现在AI为什么越来越好用了
“多模态”是现在AI设计里非常重要的一个概念,但它并没有听起来那么复杂。
所谓“模态”,可以简单理解成不同形式的信息。文字是一种,图片是一种,视频是一种,声音也是一种。
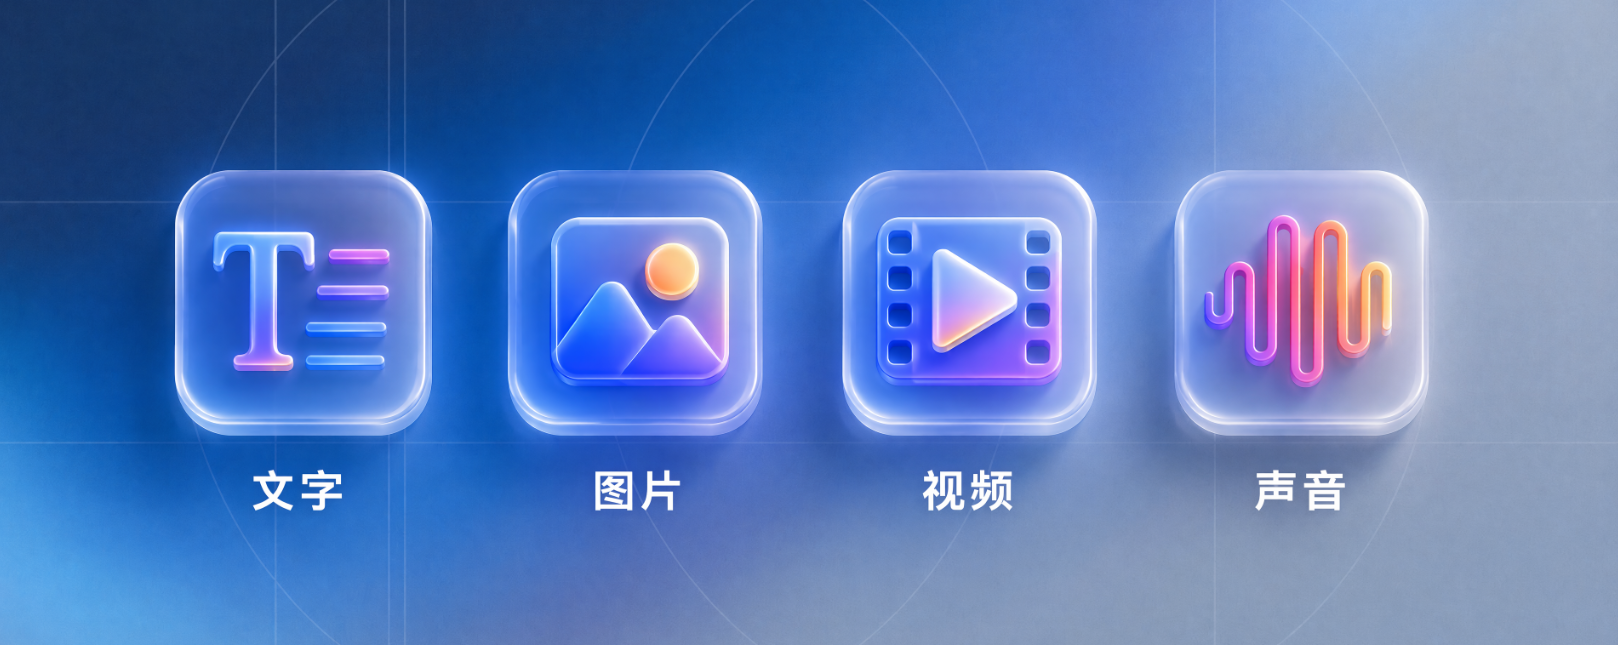
以前很多AI工具只能接受文字,所以我们不得不用提示词把所有内容都描述出来。
例如:
“一个黑色长发、白色皮肤、穿蓝色连衣裙的年轻女性站在海边……”
但现在,如果你已经有这个人物的图片,其实根本没必要花几百字描述她。
直接把图片交给AI就行。
甚至可以同时上传:
人物图片、服装图片、场景图片、产品图片,再用一句话说明它们之间的关系。
比如:
使用图1的人物,让她穿图2中的衣服,出现在图3的场景里,同时手里拿着图4的产品。
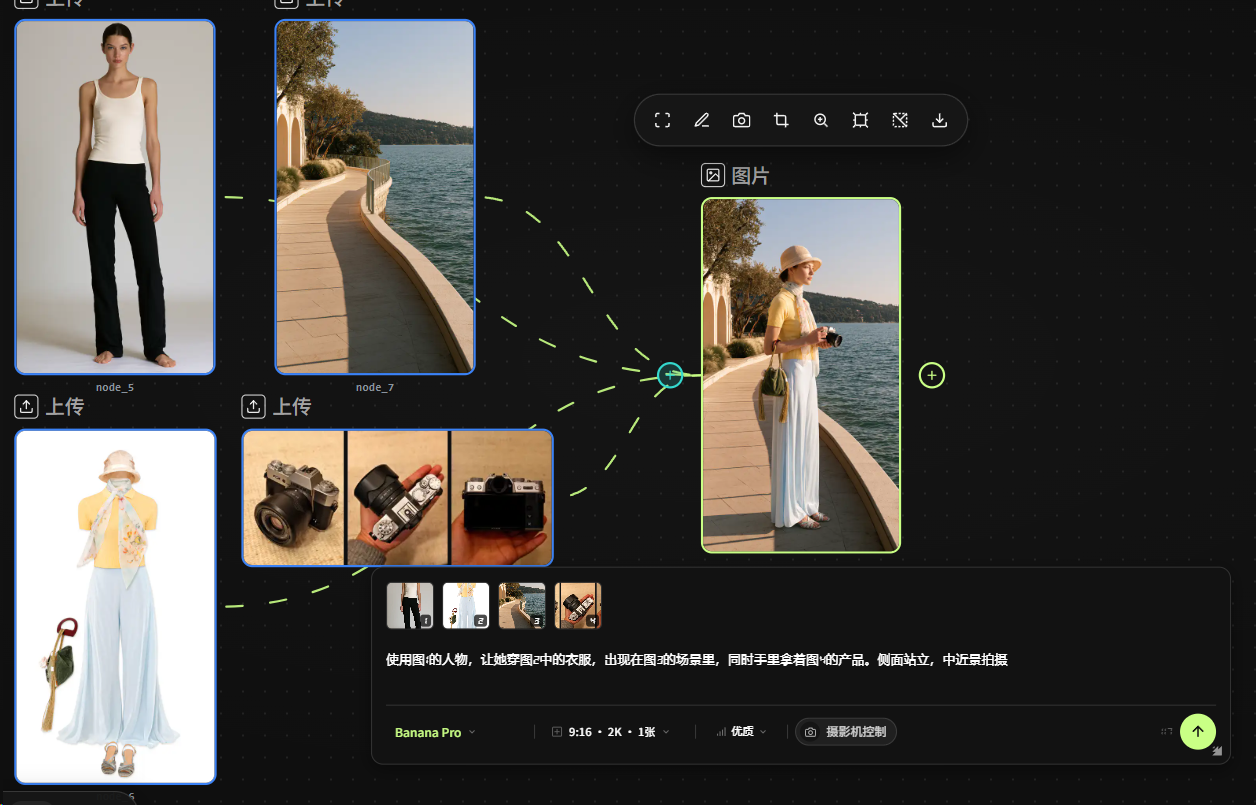
这就是现在很典型的多模态创作方式。
所以多模态对设计最大的意义,不是多了一个复杂技术名词,而是:
很多过去说不清楚的东西,现在可以直接给AI看,并且只需要用到自然语言描述。
文字负责告诉AI“你想做什么”,图片、视频和声音则负责提供更加具体的信息。
这也是为什么现在AI设计越来越依赖参考素材,而不再只依赖一条很长的提示词。
四、提示词已经从“关键词”变成了正常沟通
1.Prompt(提示词)
Prompt,也就是提示词,本质上就是:
你告诉AI要做什么的那段话。
过去很多AI生图教程里,经常能看到这样的写法:
“masterpiece、best quality、8K、cinematic、ultra detailed……”
大量关键词堆在一起,看起来很专业,也让很多新手误以为:提示词必须背很多特殊单词,AI才能生成好结果。
但现在主流模型的理解能力已经发生了很大变化。
提示词正在越来越自然语言化,也越来越口语化。
比如以前可能会写:
年轻女性,办公室,黑色西装,电影感,柔光,8K,高级感。
现在完全可以直接写:
一个年轻女性坐在现代办公室窗边,穿着简洁的黑色西装,下午自然光从右侧进入。人物正低头看桌上的文件,整体保持真实、干净的企业摄影质感。
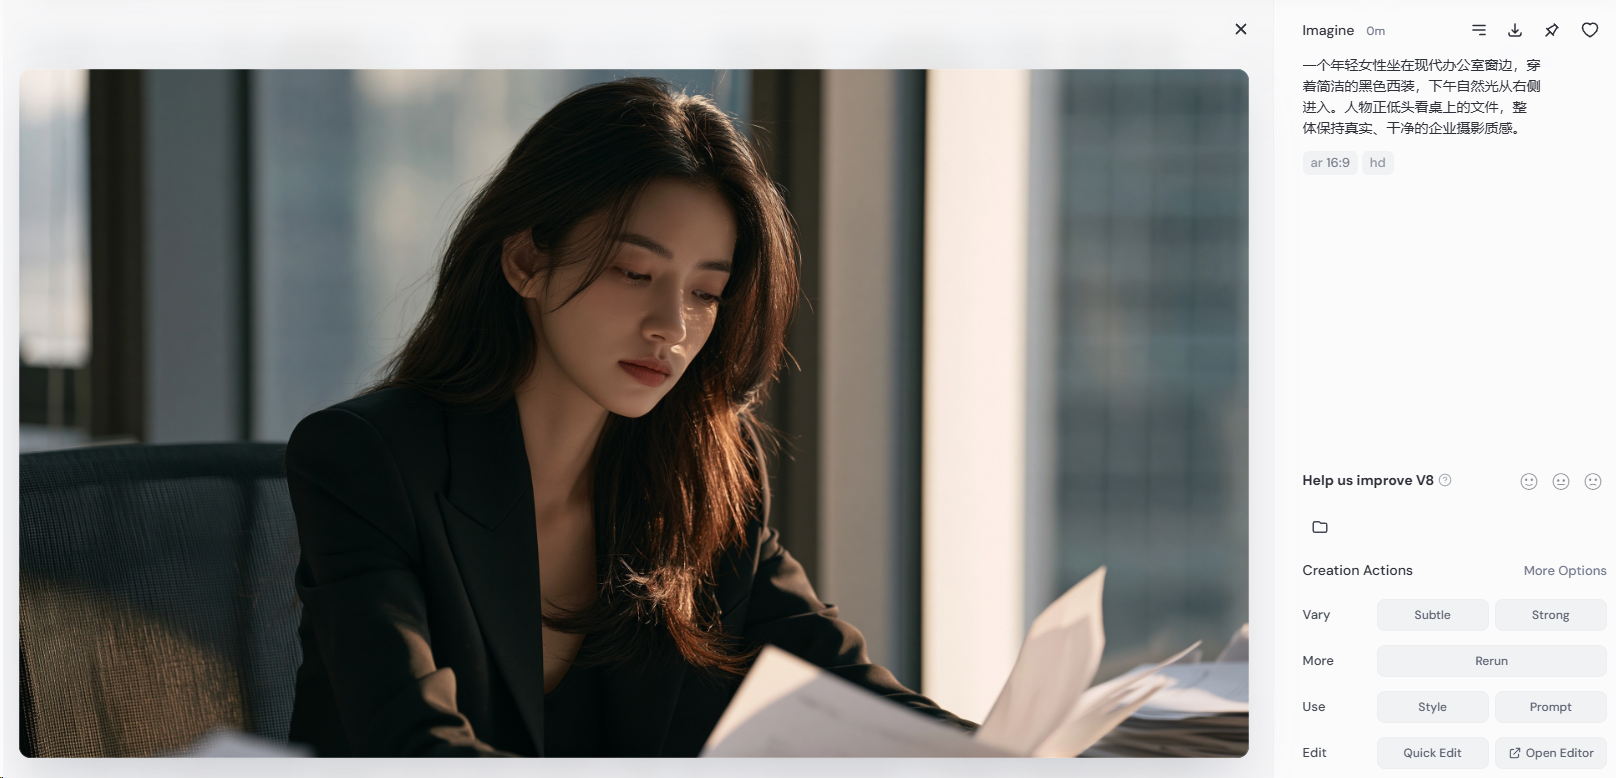
这里真正发生变化的,不只是句子变长了。
而是我们不再单纯依靠关键词,而是在描述一个完整需求。
你希望人物做什么、场景在哪里、哪些内容必须保持、哪些地方需要修改,都可以直接告诉AI。
所以现在学习提示词,最重要的已经不是记住多少“高级词汇”,而是:
学会把自己的想法说清楚。
可以把它理解成你正在和一个设计师、摄影师或者导演沟通。
你的要求越明确,AI越容易理解。
2.上下文也让提示词越来越简单
这里还有一个经常出现的概念:上下文。
例如你先把品牌资料交给AI,又上传了产品图片,让它帮你想三个广告创意。
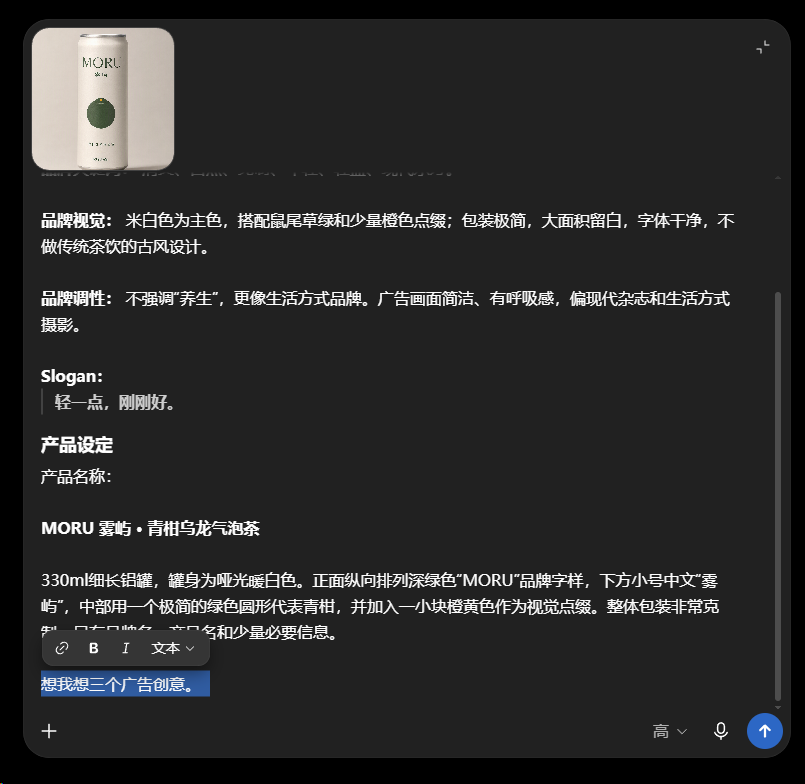
AI给出结果以后,你只需要说:
第二个不错,再优化一下。
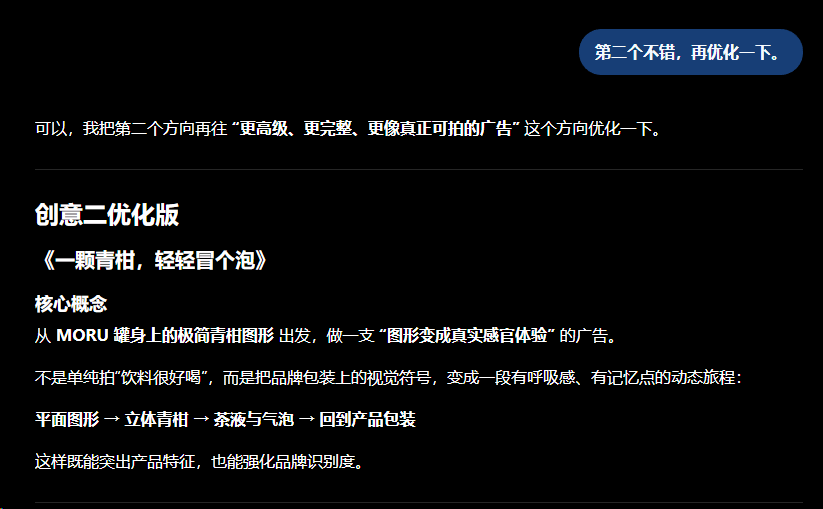
它依然知道“第二个”指什么,也知道前面的品牌和产品是什么。
这就是因为AI会结合前面的聊天、图片、文件和已经确认的信息继续理解。
这些AI当前能够参考到的前置信息,就可以理解成上下文。
所以现在使用AI,也不需要每次都把完整要求重新复制一遍。
完全可以连续修改:
人物再年轻一点。
保持其他内容不变,只修改背景。
继续按照刚才的风格做下一张。
这种连续沟通,本身就是现在AI设计非常常见的使用方式。
五、AI图片最常见的两种生成方式
搞清楚前面的模型、多模态和提示词以后,再来看图片生成就会简单很多。
现在AI图片最常见的方式,基本可以归为2种。
文生图和图生图。
区别也非常简单:有没有图片参与生成。
1. 文生图:只用文字生成图片
文生图,也就是:
文字 → 图片
你不需要提供任何图片,只需要通过提示词把想要的画面描述清楚,AI 就会根据这些信息从零开始生成。
例如:
一间建在海边悬崖上的现代咖啡店,巨大的落地窗面向大海,室内使用浅色木材和灰白色石材,清晨自然光从窗外进入,整体保持真实、干净的建筑摄影质感。
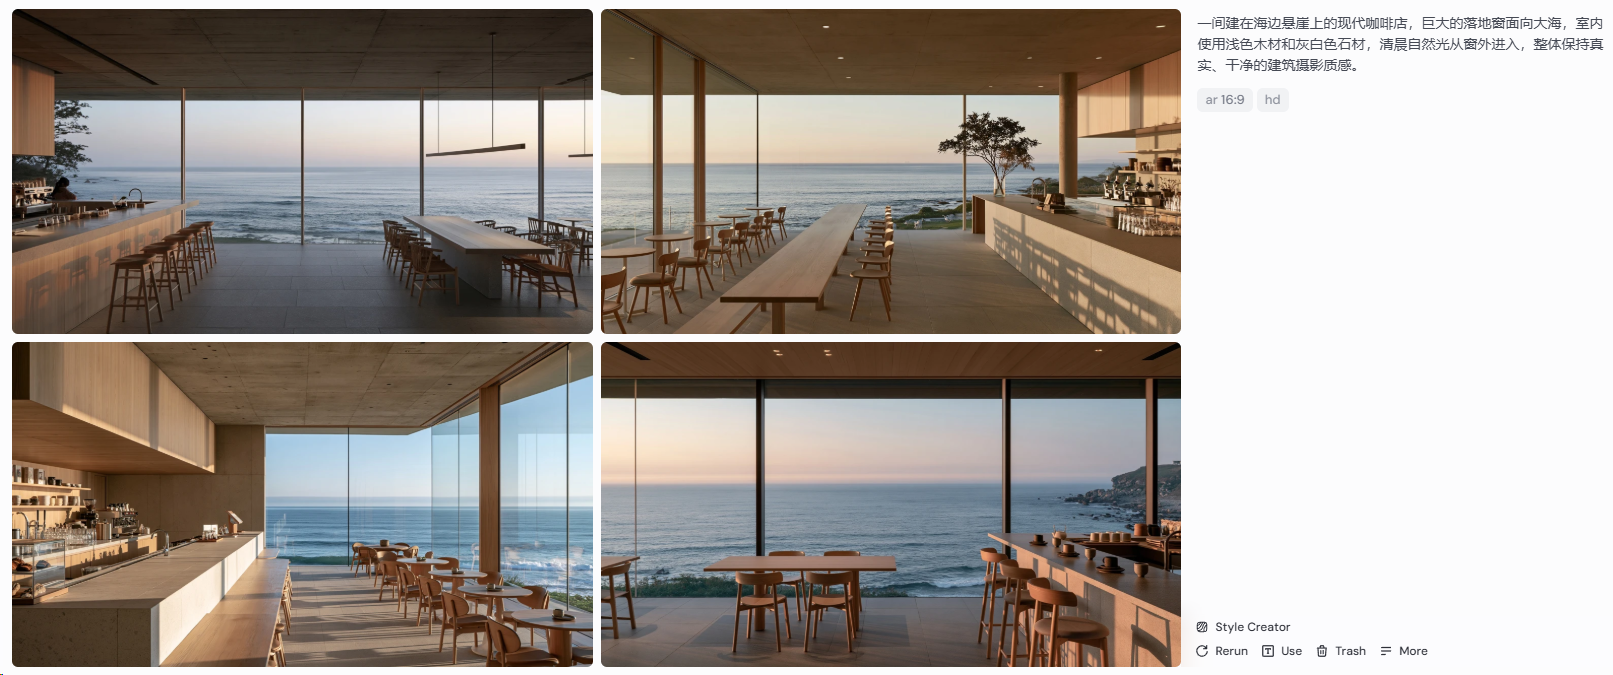
这里没有任何参考图片,人物、建筑、材质、光线和构图都由 AI 根据文字自行理解并完成。
所以文生图比较适合从零开始找创意、探索视觉方向。前期还不知道画面具体应该长什么样时,可以先通过文字快速得到多个方案。
2. 图生图:有图片参与生成
只要你在生成过程中提供了一张或多张图片,都可以先把它理解成:
图生图。
也就是:
图片 + 提示词 → 新图片
但现在的“图生图”已经不只是过去那种简单地把一张图重新画一遍,它里面包含了很多不同的使用方式,比如图片编辑、图片参考和多图参考。
2.1图片编辑
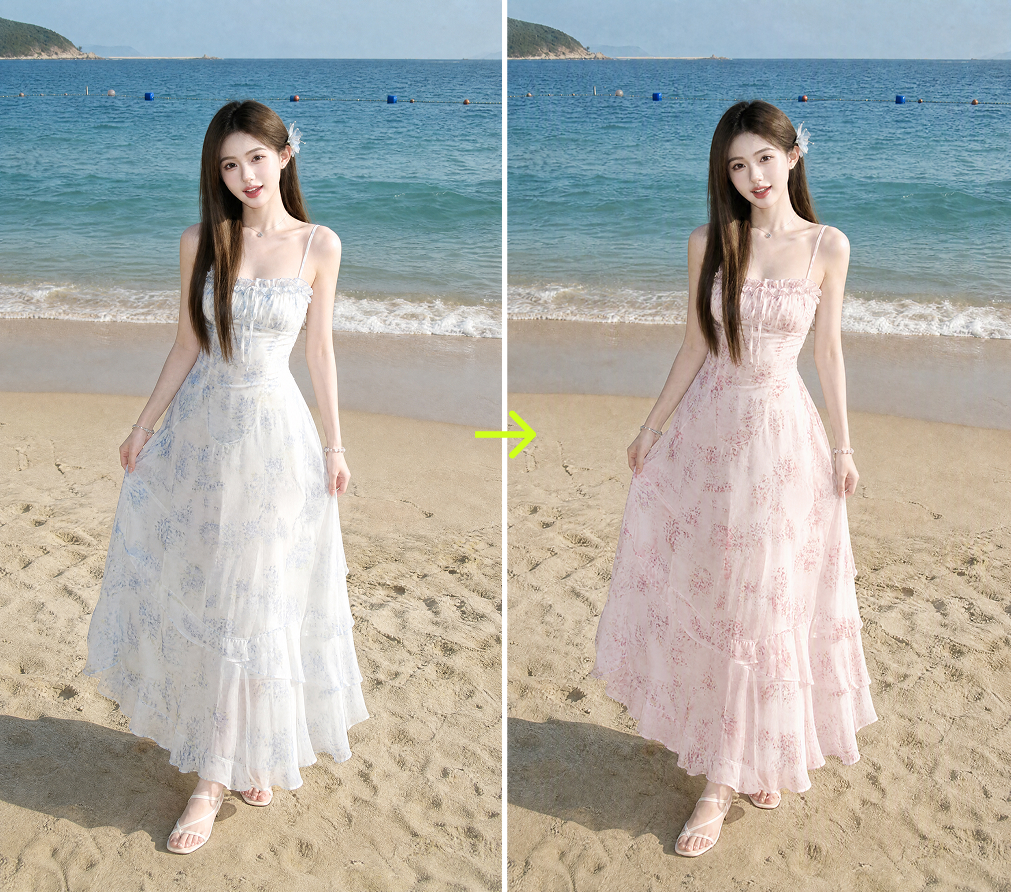
图片编辑很好理解,就是已经有了一张基本满意的图片,只修改其中某些内容。
例如上传一张人物照片:
保持人物脸型、发型和姿势不变,改成淡粉色碎花长裙
或者:
删掉客厅中的猫咪,其他内容保持不变
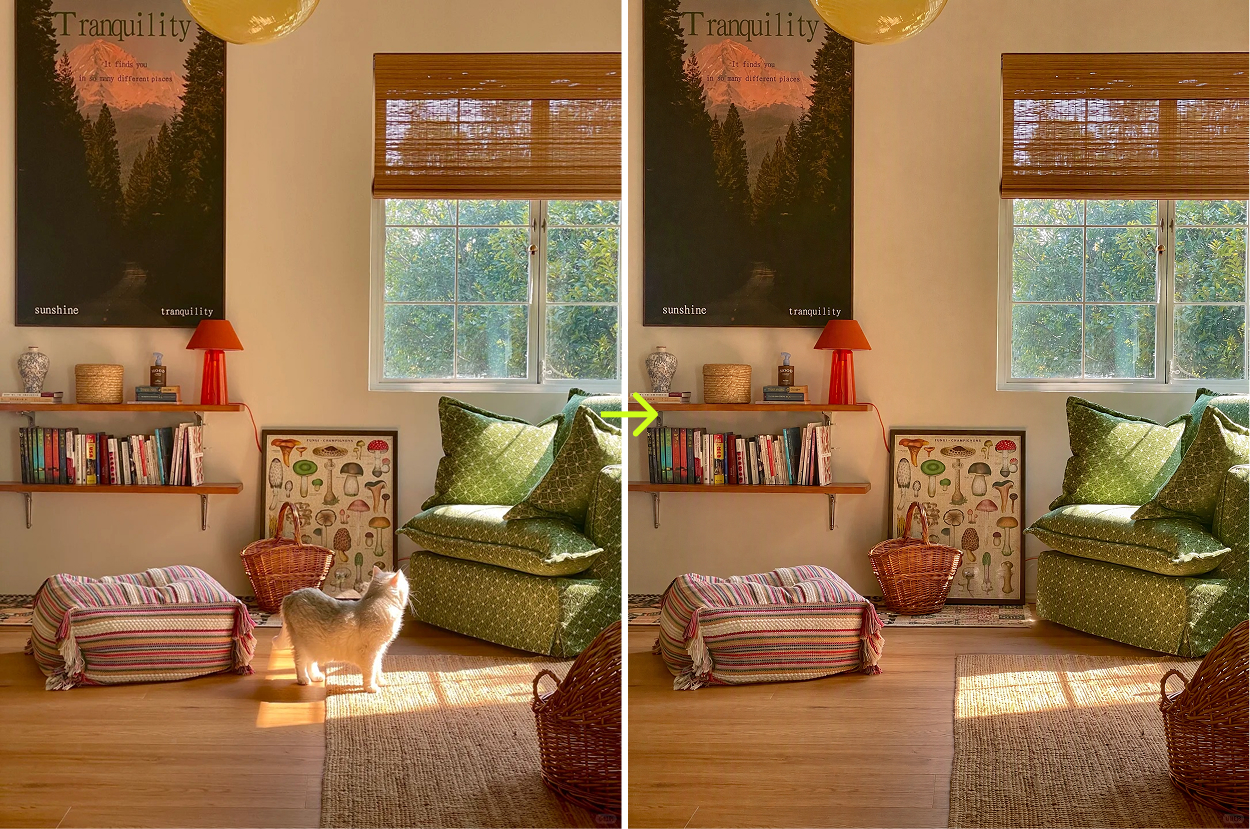
以前使用 AI 图片时,某个地方不满意,往往只能重新生成整张图。现在越来越多模型可以直接理解“哪里需要改、哪里不要动”。
所以 AI 图片正在从过去的:
生成失败 → 重新生成
慢慢变成:
先生成 → 找到问题 → 继续修改。
这也是现在 AI 做设计非常重要的变化。
2.2图片参考
另一种很常见的方式,是上传一张图片作为视觉参考。
例如你已经有一个人物,就可以直接上传人物照片,再告诉 AI:
使用这个人物,生成一张她坐在咖啡店窗边看书的照片。
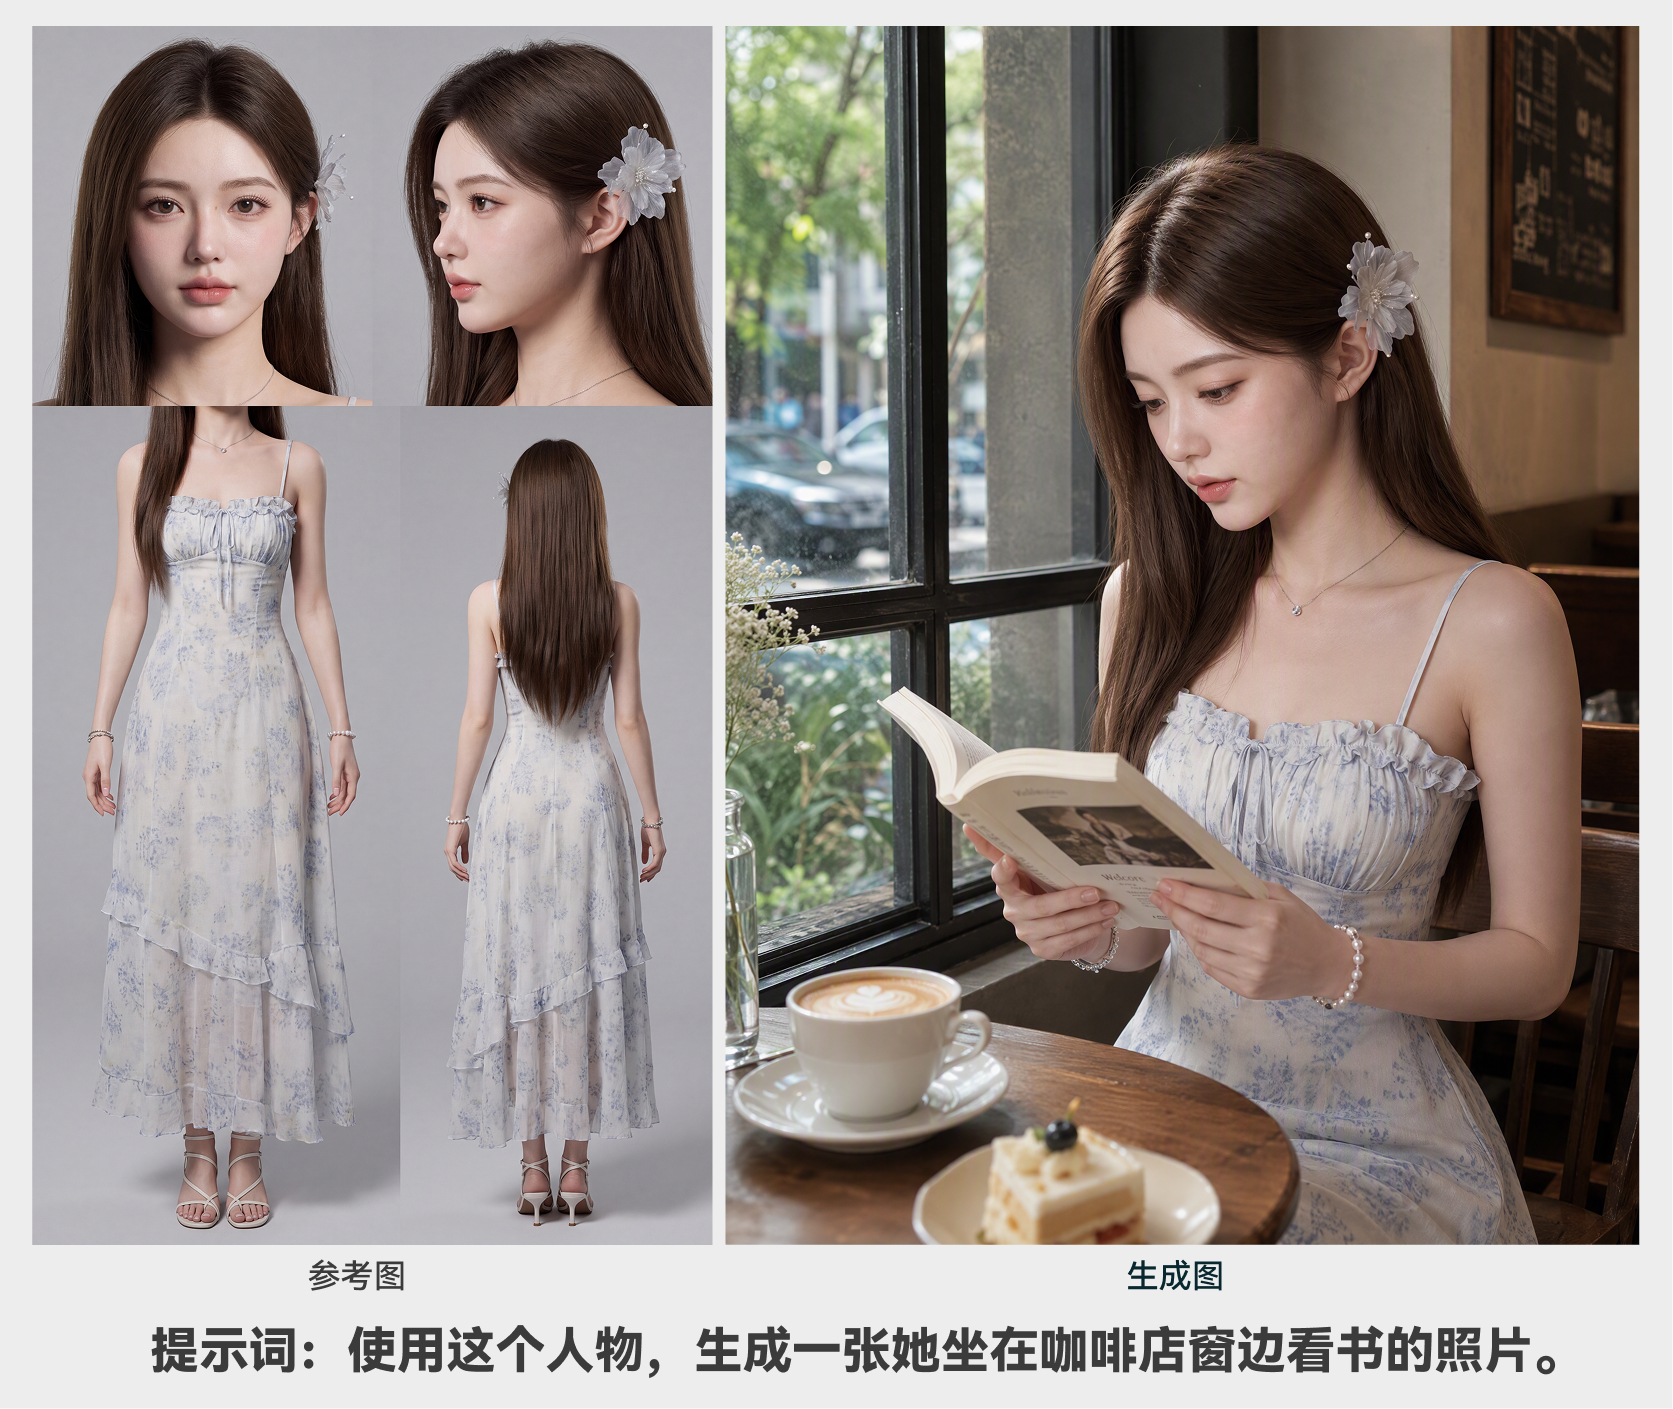
这时候参考图主要告诉 AI:
人物长什么样。
同样的,你也可以上传:
产品图,让 AI 知道产品长什么样;
场景图,让 AI 参考环境;
服装图,让 AI 参考衣服;
构图图,让 AI 参考画面布局。
所以很多过去需要写很长提示词才能描述的内容,现在可以直接通过图片提供。
文字负责告诉 AI 要做什么,图片负责告诉 AI 某些东西具体长什么样。
2.3多图参考
如果一张图片不够,也可以同时上传多张图片。
例如:
人物参考图 + 产品参考图 + 场景参考图
然后告诉 AI:
使用这个(图1)人物,生成一张她坐在咖啡店(图2)窗边拿着图3手机的图片。中景拍摄
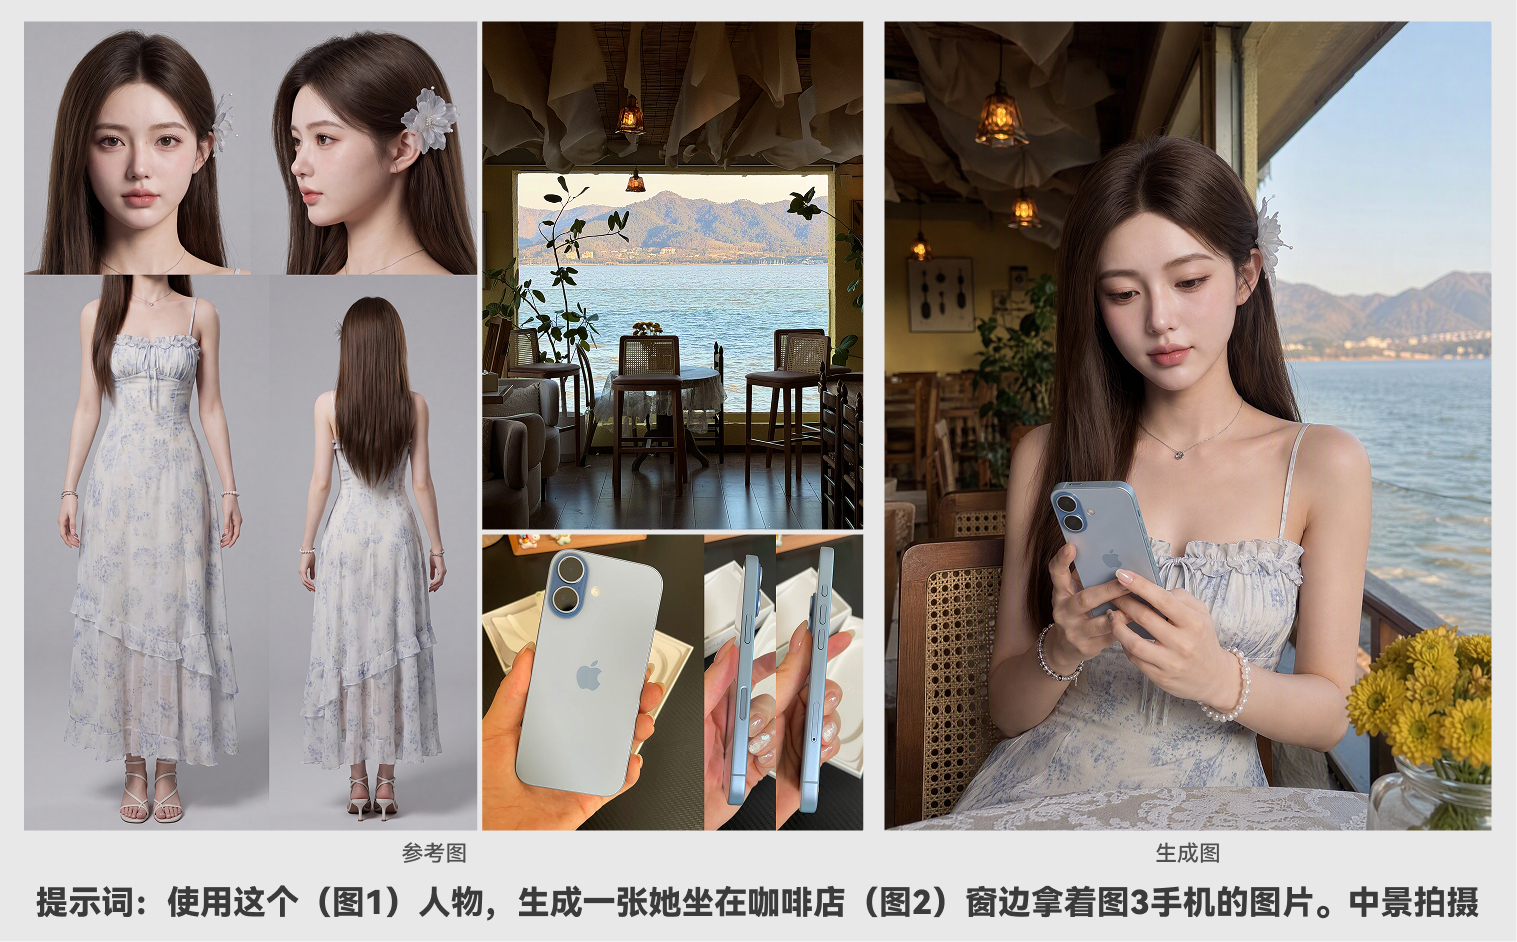
这就是现在非常常见的多图参考。
与单张参考相比,多图参考可以把不同素材的信息组合起来,也让我们对最终画面拥有更多控制。
不过参考图并不是越多越好。图片数量增加之后,不同素材之间也可能出现互相影响,比如人物参考影响了服装、场景参考改变了人物风格。
这些关于多图参考、一致性和素材之间如何分工的问题,我们会放到第二节再详细讲。
3.所以 AI 图片其实没有那么多复杂分类
这一部分学完以后,只需要记住一个最简单的判断方式:
没有图片参与,就是文生图;有图片参与,就是图生图。
而在图生图里面,我们最常遇到的又包括:
图片编辑、图片参考、多图参考。
这样以后不管遇到 Nano Banana、GPT Image、Seedream,还是新的图片模型,都可以先从这个逻辑理解它到底在做什么。
六、AI视频:从图生视频到多模态参考
图片之后,就是视频。
AI视频最基础的两种方式其实很好理解。
文生视频,就是只通过文字描述画面和动作,由AI直接生成视频。
例如:
一个男人撑着黑色雨伞走过雨夜街道,摄影机从侧面缓慢跟随,路面的积水反射街边灯光。
由seedance2.5直接生成
而图生视频,则是先提供一张图片,再告诉AI画面应该怎么运动。
例如上传一张人物图:
人物先看向镜头,随后慢慢转头看向窗外,头发被微风轻轻吹动。
1.首帧、尾帧和首尾帧
首帧就是视频开始时的画面,尾帧则是视频最终需要达到的画面。
如果同时给AI首帧和尾帧,就是我们经常说的首尾帧生成。
它相当于告诉AI:
从这个画面开始,最后一定要走到这个画面,中间的变化过程由你完成。
相比只提供首帧,首尾帧会进一步确定视频的起点和终点。
2.视频参考和多模态参考
现在的视频模型也不只是“给一张图让它动起来”。
如果你看到一段视频,喜欢里面人物的动作、摄影机运动或者表演节奏,这段视频本身也可以成为参考素材。
例如:
人物动作参考一个视频;
人物形象来自一张图片;
环境来自另一张场景图;
产品又来自一张单独的产品图。
再加上文字提示词,甚至声音素材,一起控制最终视频。
这就是现在越来越常见的:
多模态参考。
它不是某一种新的参考方式,而是强调:
图片、视频、文字、声音等不同类型的信息,可以共同参与一次生成。
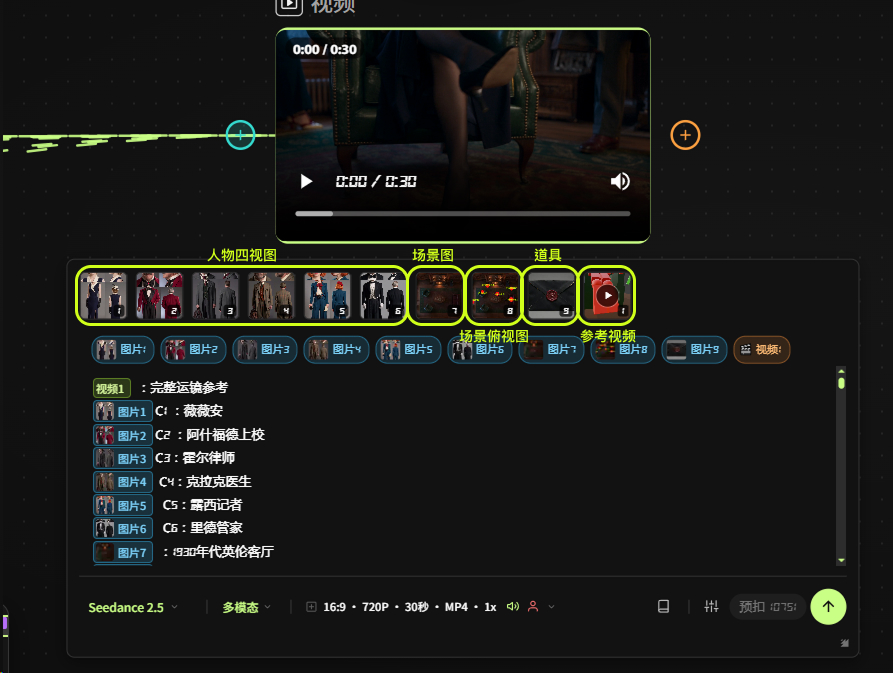
注意要使用支持多模态参考的模型!!(seedance2.0/seedance2.5/mini max h3/wan3.0)
比如制作一条视频,可以让人物图负责角色形象,道具图负责道具,场景图负责场景,参考视频可以负责运镜,最后再通过提示词把整个要求串起来。
这也代表AI视频正在发生一个很明显的变化:
从过去的:
“让一张图片动起来”
逐渐变成:
“使用多种素材共同控制一条视频”。
总结:先把这些关系搞清楚,再去学工具
这一节看起来出现了很多名字,但真正需要记住的逻辑其实并不复杂。
首先,平台和模型不是同一种东西。平台是我们操作AI的入口,而模型是真正负责理解和生成内容的能力。
其次,不同模型负责解决不同的问题。分析和策划可以交给语言类AI,图片模型负责视觉,视频模型负责动态内容。遇到一个新模型时,不需要马上研究它所有功能,先弄清楚它主要负责什么。
第三,AI已经进入多模态时代。文字不再是唯一输入,图片、视频和声音都可以帮助AI理解你的需求。很多无法准确描述的视觉内容,与其写几百字,不如直接给参考素材。
最后,提示词本身也正在发生变化。现在真正重要的已经不是堆叠大量关键词,而是能不能用正常语言把自己的需求表达清楚。
图片可以从文生图一路发展到图片编辑和多图参考,视频也从简单的文生视频、图生视频,逐渐进入首尾帧、视频参考和多模态参考。
这些基础逻辑搞清楚以后,后面再接触任何新的AI设计工具,都会容易很多。
下一节我们会继续进入更实际的部分:多图参考、一致性、多图融合、自然语言修改、动作和运镜参考,以及Agent和无限画布到底是什么。