一起来看一下成品:
准备工具
seedance2.5/seedream 5.0pro https://jimeng.jianying.com/ai-tool/home/
nanobanan pro https://labs.google/fx/tools/flow
豆包 https://www.doubao.com/chat/
倘若不知道模型怎么使用,可以参考这个教程(https://www.super-i.cn/info-2796.html),与本教程一起使用
如果不想各个网页跳转模型,可以使用flowpix平台,已接入所有热门模型
https://www.flowpix.club/bj/42403.html?token=6d763b20bab822f2380d5700d0527053
为什么要先做分镜
Seedance 2.5对长提示词的理解能力很强。只要写好一段完整的“论文式提示词”,就能直接生成15—30秒的视频。
不过,一条真正有效的长提示词,其实同时包含了编剧和导演的多项工作:
如何拆分镜头;
每个镜头持续多久;
景别怎样变化;
人物从哪里进入、看向哪里;
动作怎样形成因果;
前后镜头怎样保持空间连续;
声音怎样配合画面;
什么时候切镜头,什么时候保持长镜头。
如果没有较强的编导和写作基础,直接让AI完成整段提示词,经常会出现以下问题:
分镜看似丰富,前后逻辑却不连贯;
人物突然改变位置或运动方向;
一个镜头里塞入太多动作;
重要情节出现得太快;
人物、场景和道具发生变化;
单个画面很漂亮,组合起来却不像同一场戏。
更麻烦的是,一段15—30秒的视频只要有几秒出错,往往就需要重新生成整段,不仅等待时间更长,也会消耗更多算力。
因此,我采用了一种分阶段制作的方法:
先让AI提供分镜候选,由人筛选构图;再根据选中的分镜逐镜生成视频(也可以使用minimax H3去生成视频,成本更低)。
本次案例共制作10段分镜,最终剪成约30s的视频。即使某一镜出现错误,也只需要重新生成这一小段。
第一步:准备剧本和视觉资产
开始制作前,需要准备剧本和资产。
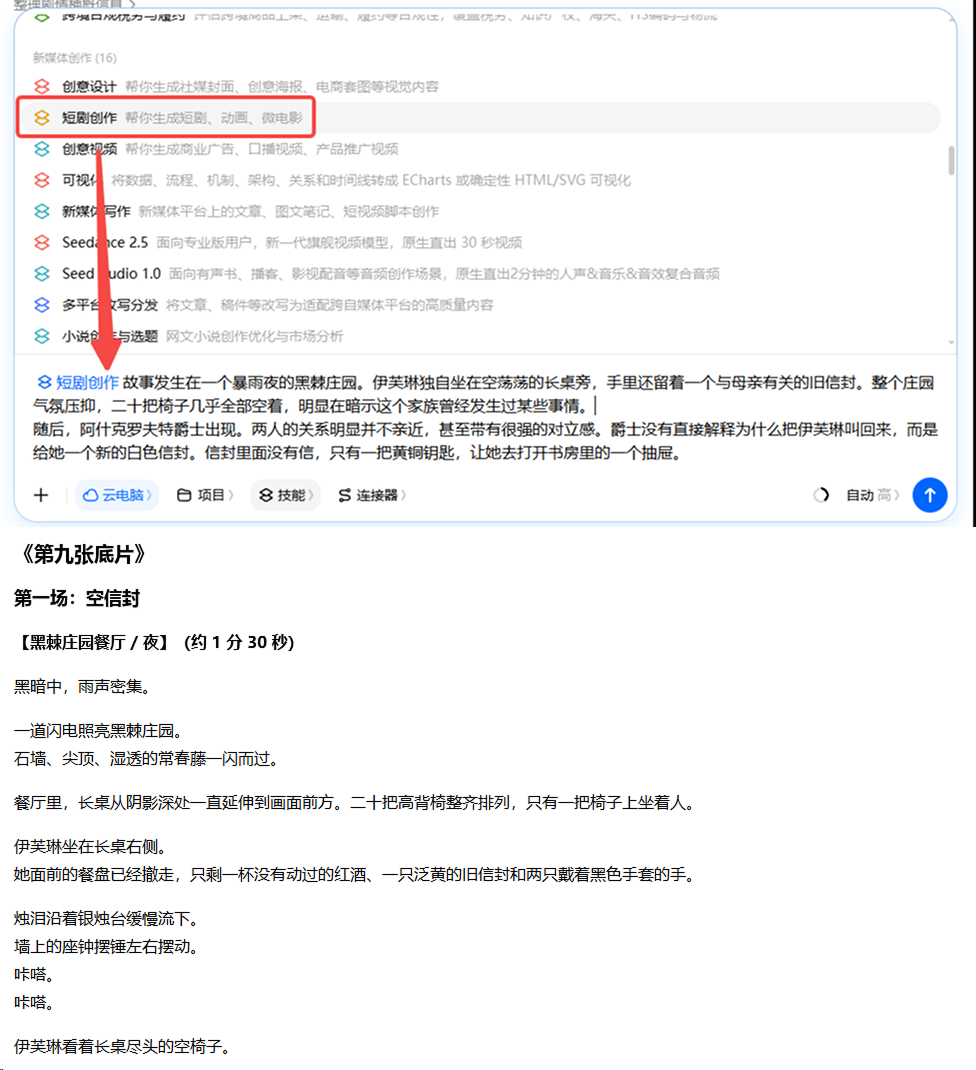
1. 准备可以被拍出来的剧本(我的这个剧本还是有些简陋了)
剧本要尽量写清楚画面中能看见和听见的内容。
剧本如下(复制到网址自动下载)
https://superi.mfdemo.cn/chaoji/2026/08/31/6a953344118ad.rar
这里的剧本也可以用豆包生成,给豆包一个大纲,然后调用短剧创作skill去完善剧本
2. 准备视觉资产
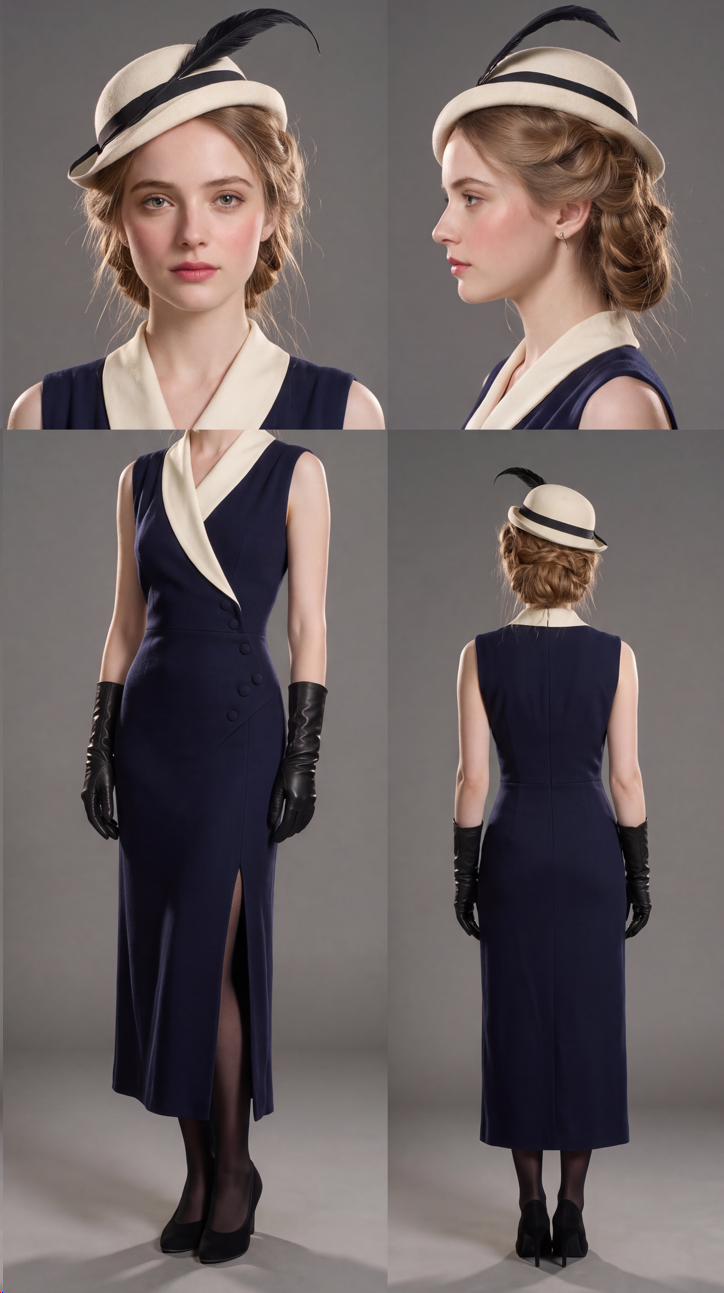
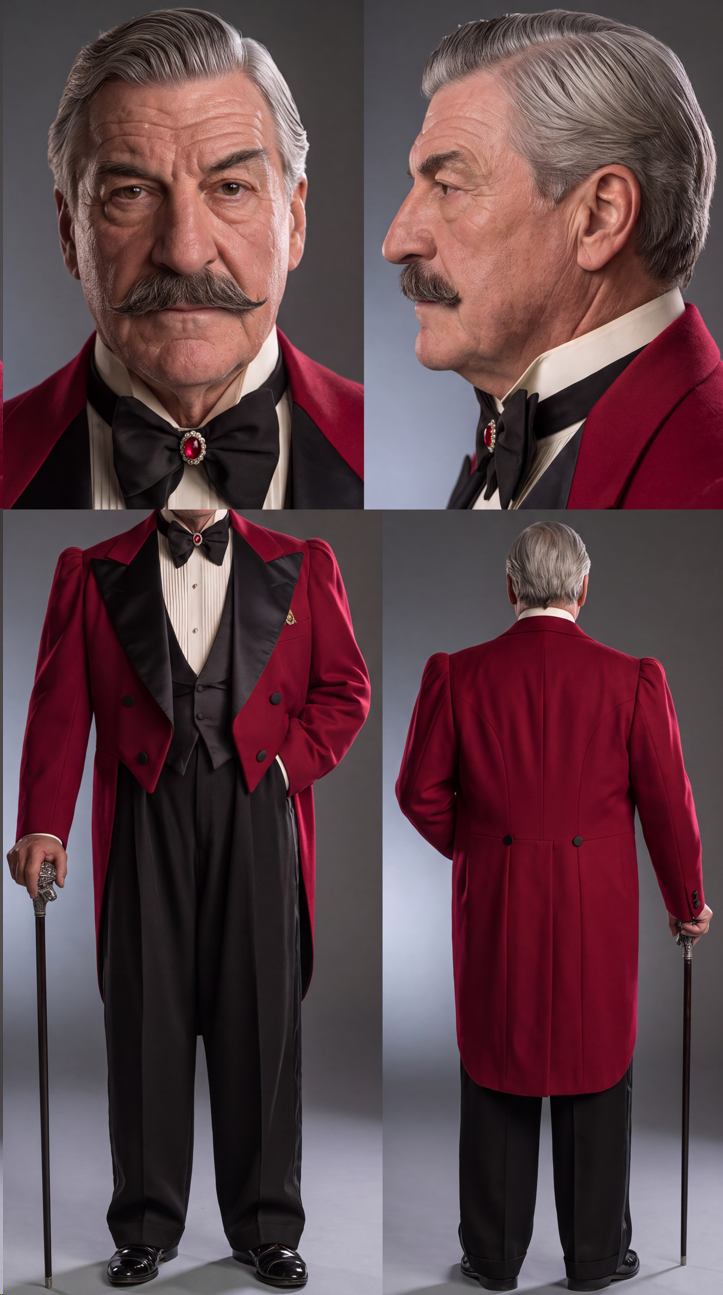
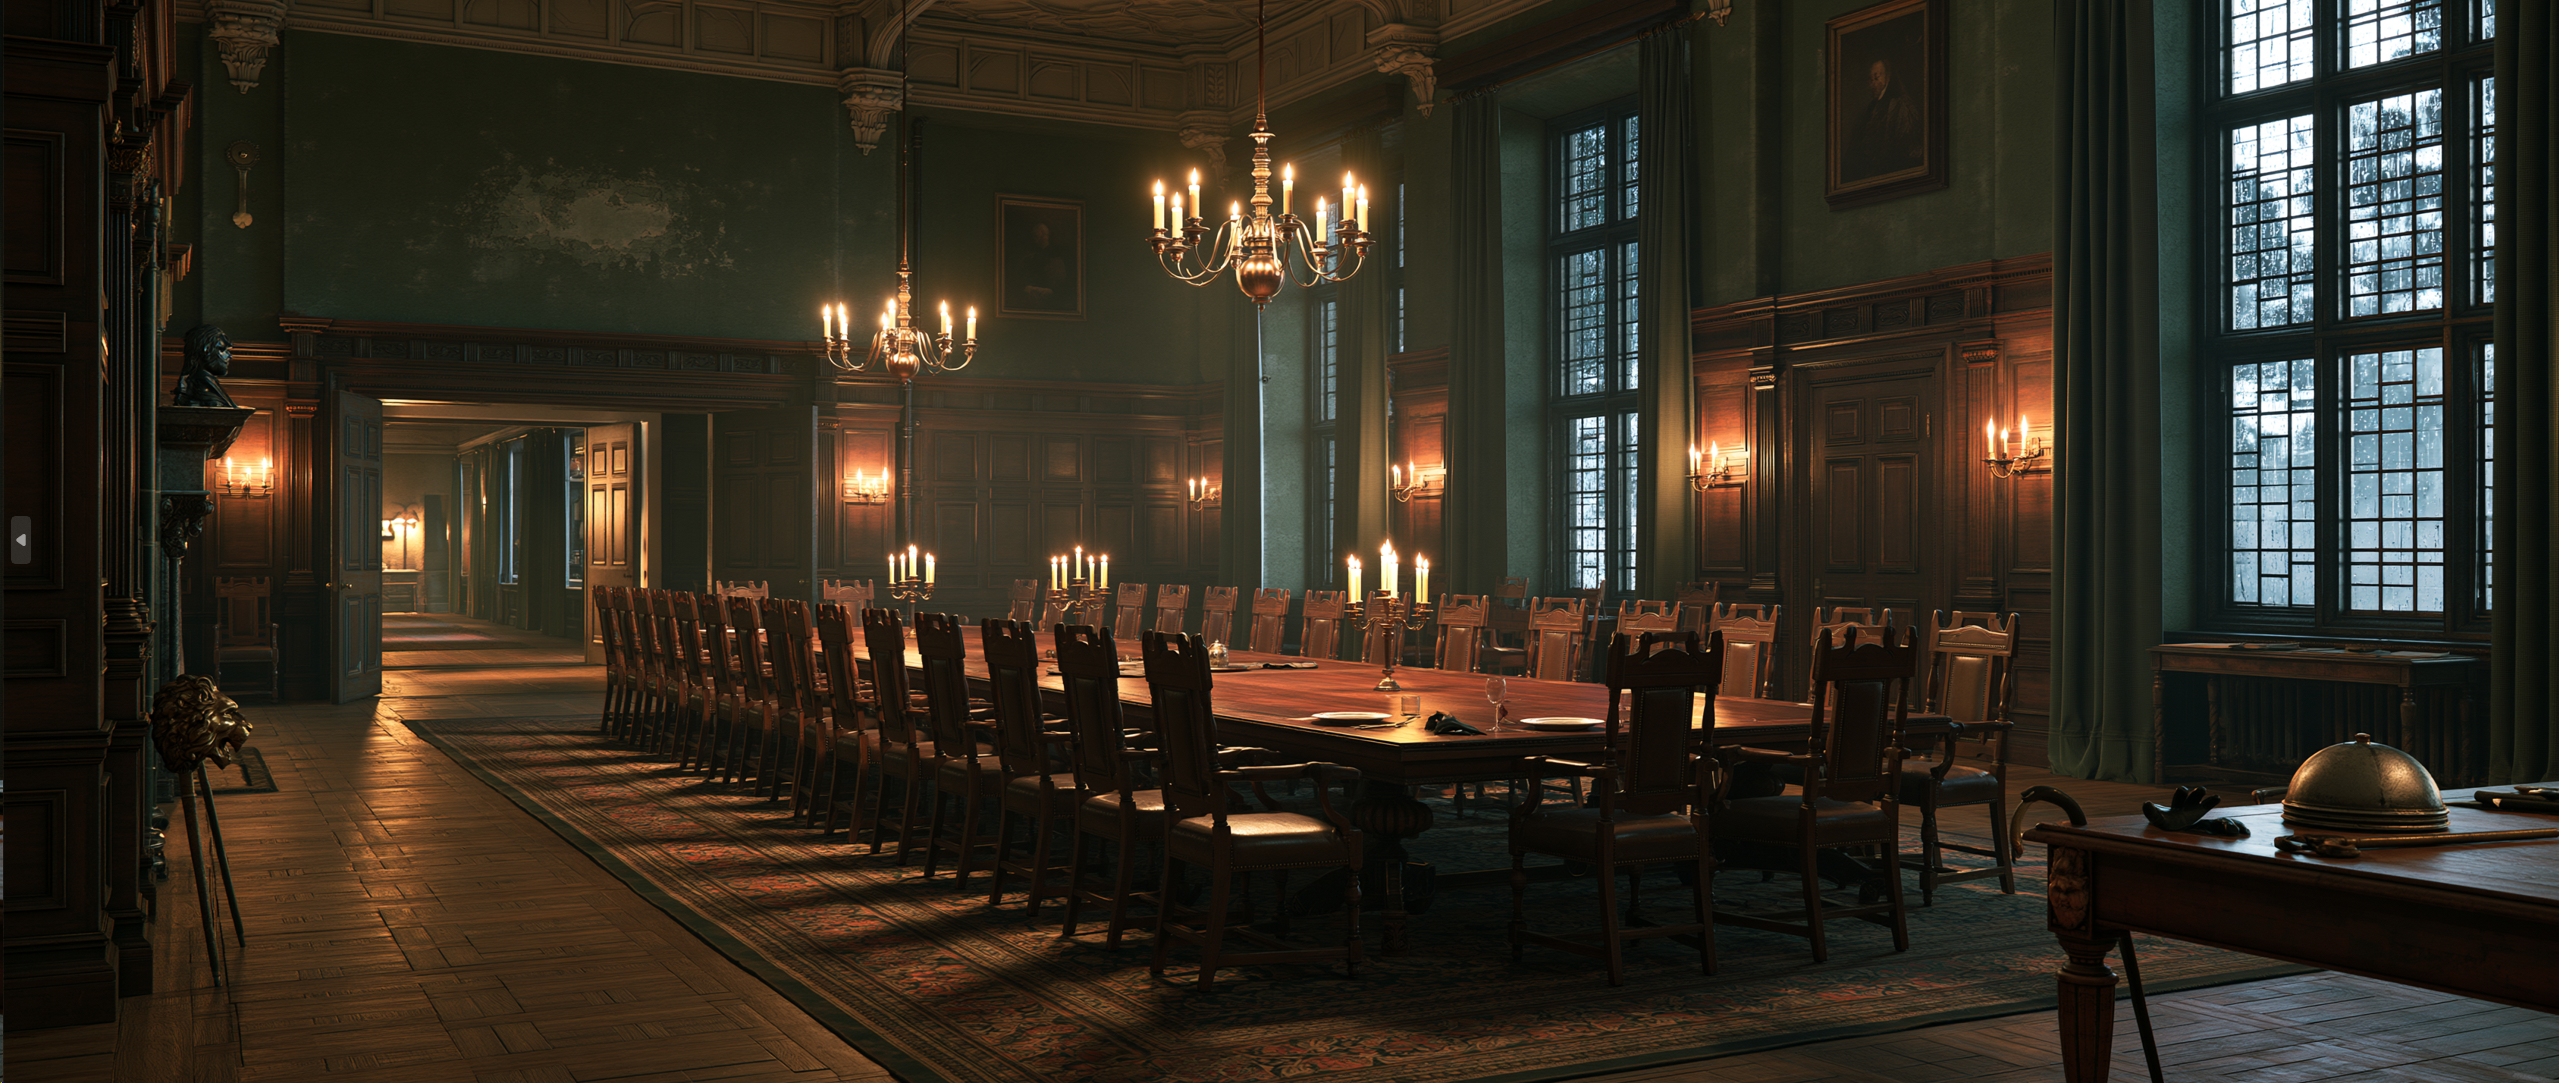
资产主要分为三类:
人物资产: 人物五官、发型、服装和体型参考;
场景资产: 庄园、餐厅、走廊等固定空间;
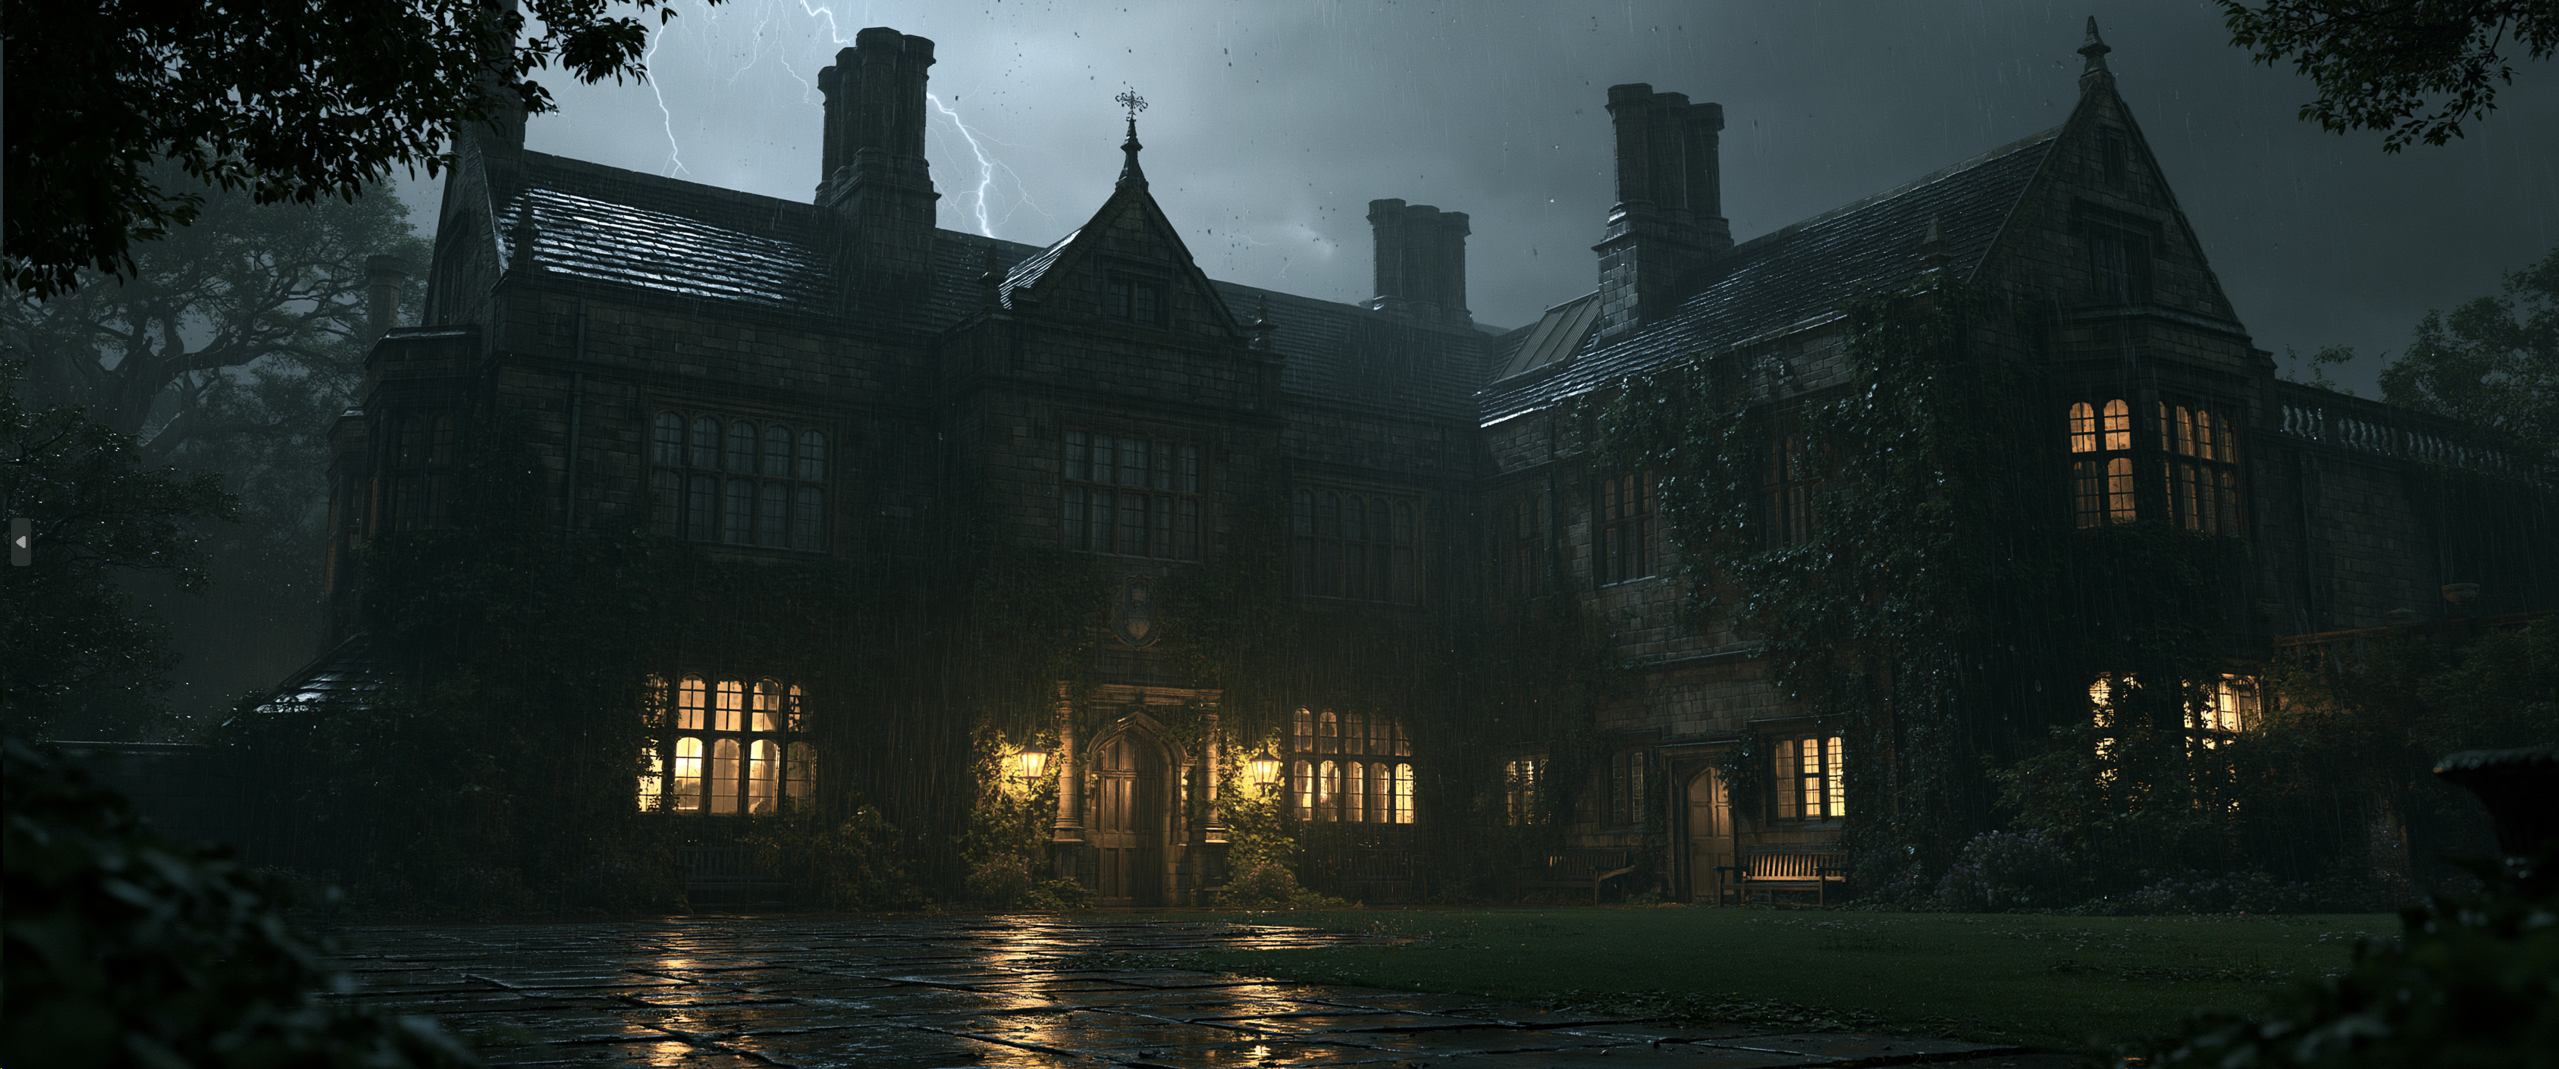
道具资产: 信封、手杖、钥匙、相机等重要物件。
如果还不会制作资产,可以参考:AI视觉资产制作教程。
第二步:用 Seedream与剧情 生成九宫格分镜
准备好当前剧情需要的人物图、场景图和道具图后,将它们作为参考图上传。
这里有一个非常重要的区别:
我们要生成的不是“9个连续剧情镜头”,而是同一个剧情、同一个场景下的9种不同拍摄方式。
这样做的目的,是让 AI 先提供不同的景别、焦距和构图,我们再从中选择最合适的镜头。
然后使用下面这段九宫格提示词(这里可以用豆包中的seedream 5.0pro去生成):
九宫格分镜的制作流程 默认使用16:9的比例,分析参考图像的整体构成。识别所有存在的主体(无论是单独一人、多人、车辆还是其他元素)及其空间关系/互动情况、根据我的剧情生成连贯的3x3网格"电影分镜网络"包含9个在相同环境中拍摄的、针对这些主体的不同景别分镜,根据内容调整标准的电影镜头类型(例如,如果是一个群体,请保持群体在一起:如果是物体,则涵盖整个物体),网格展示了输入图像中特定主体/场景在多种焦距下的表现。保证完全参考图中的风格,形象与场景,每一个宫格的左上角标号。剧情内容为:
将需要制作的剧情内容直接接在模板后面。
例如庄园外景:
“黑暗中,雨声密集。一道闪电照亮黑棘庄园。”
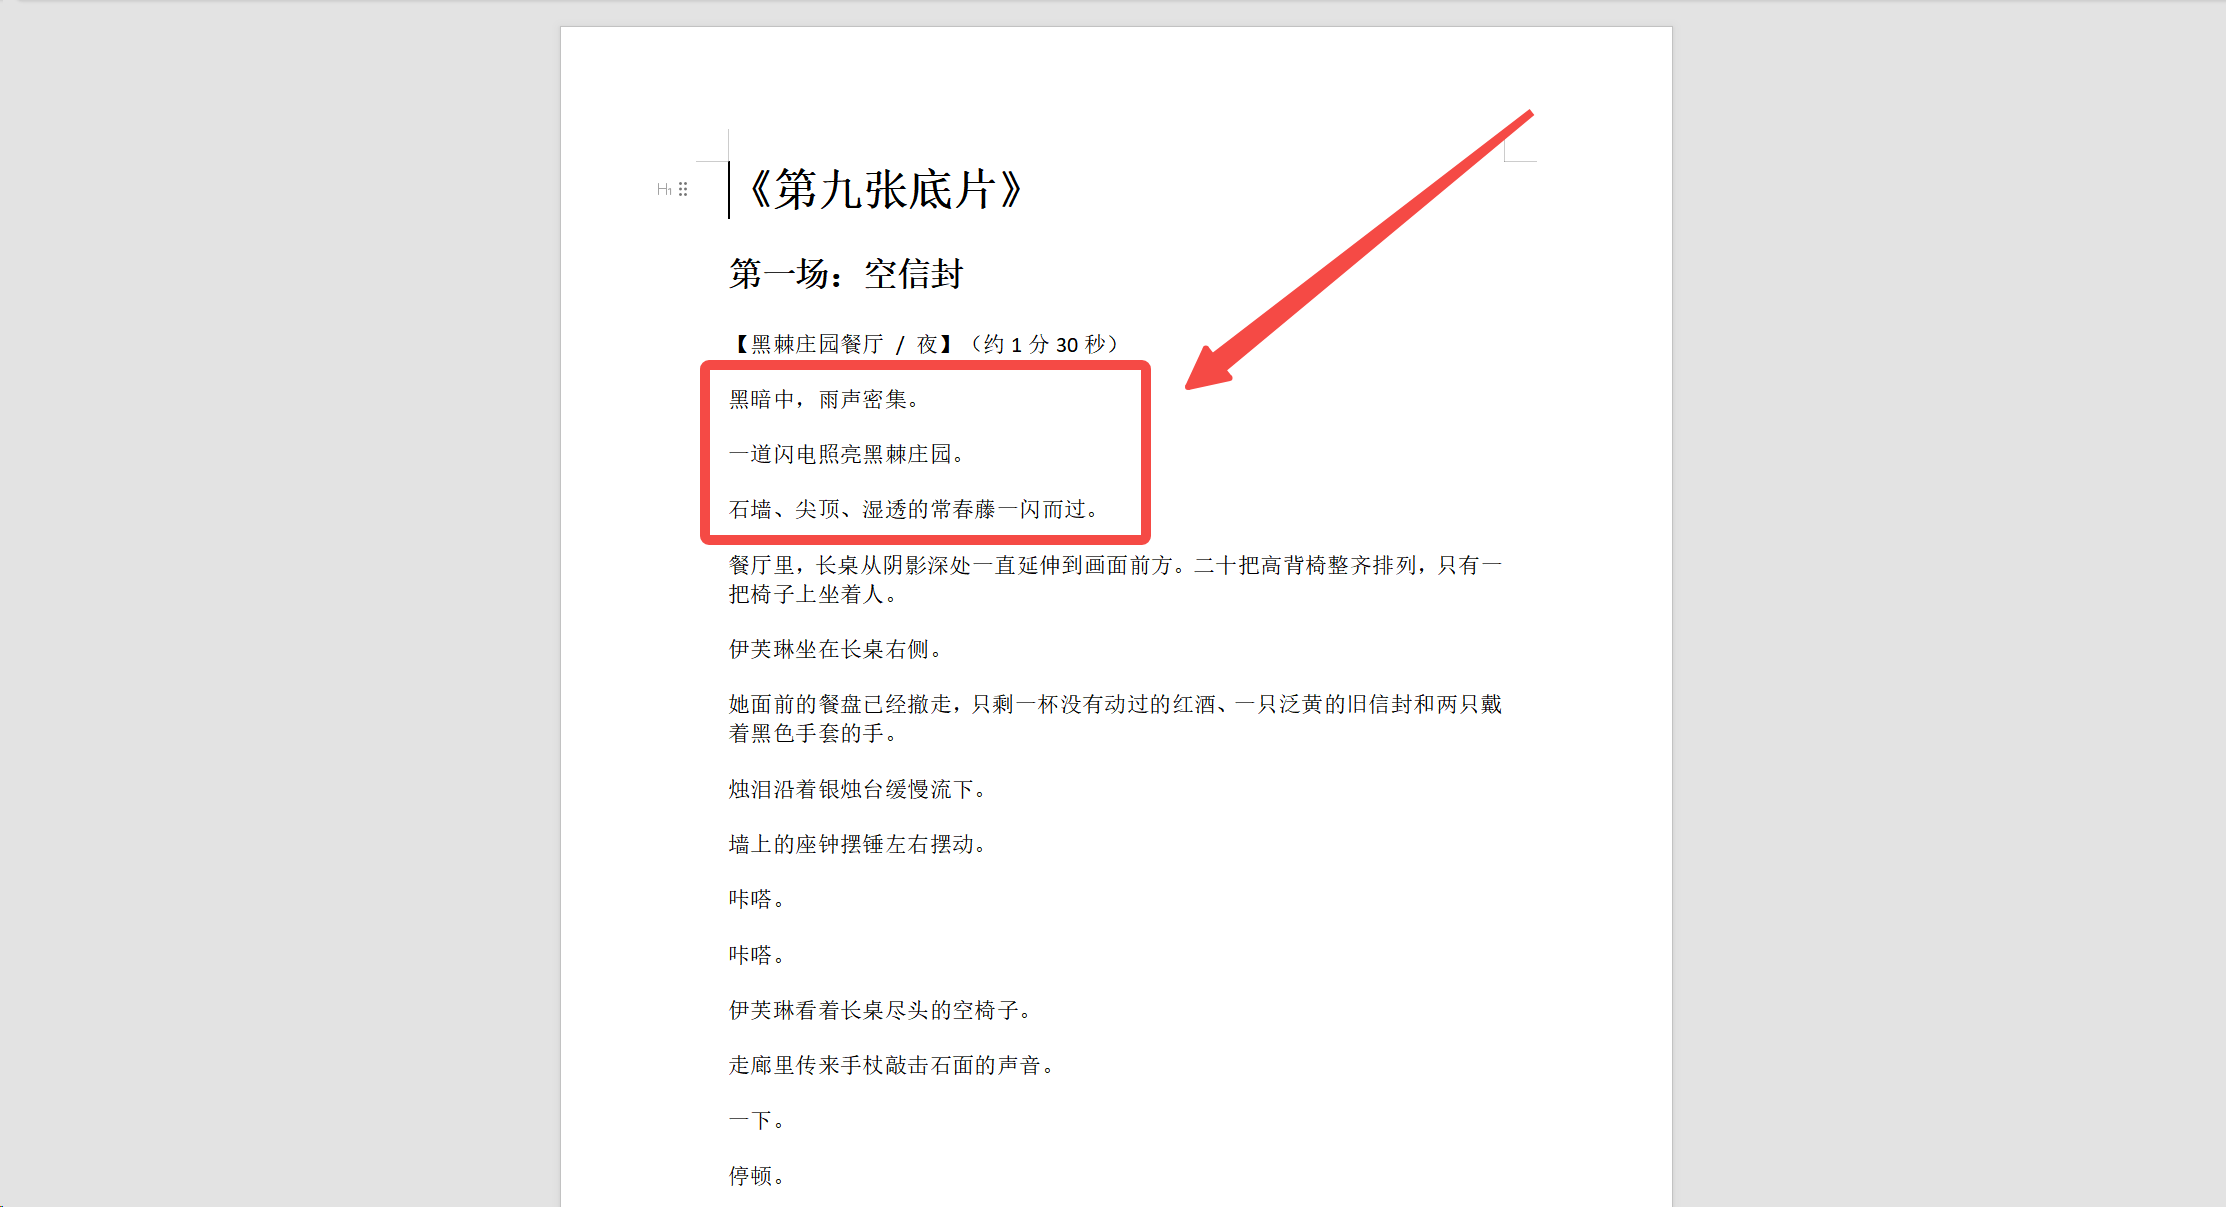
剧本内容
完整提示词就是九宫格模板加上这段剧情,并同时上传庄园场景图作为参考。
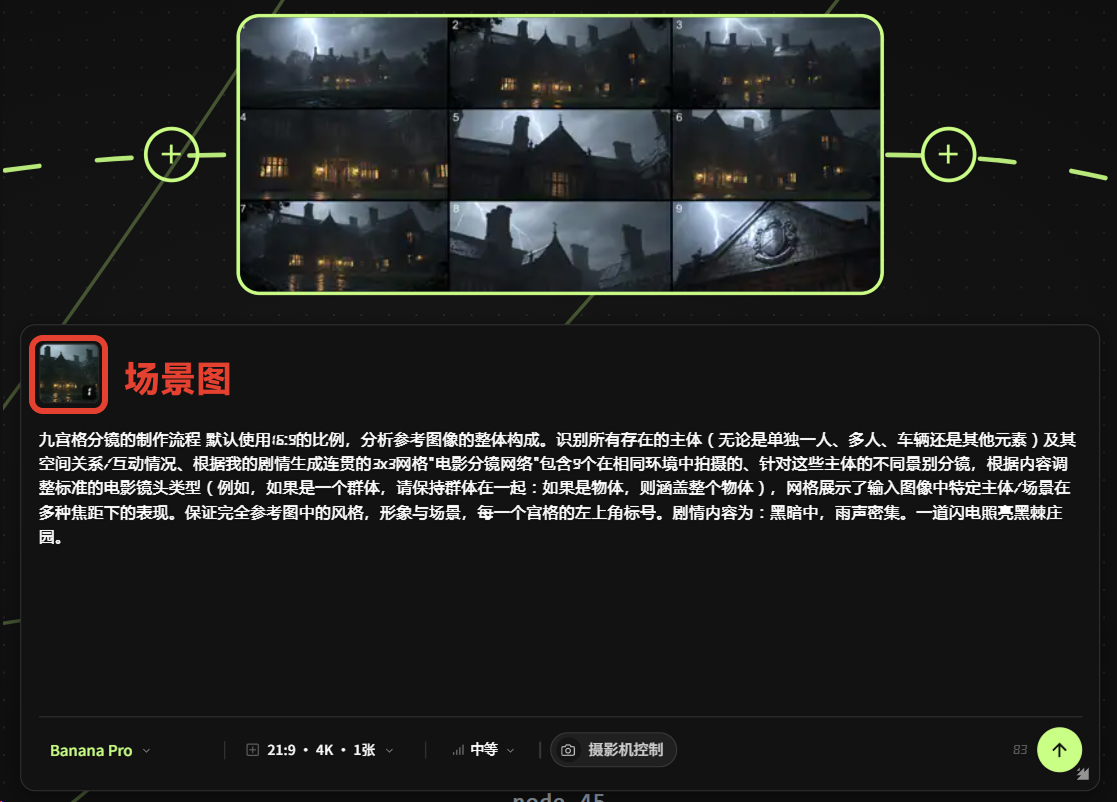
这是我在flowpix中生成的
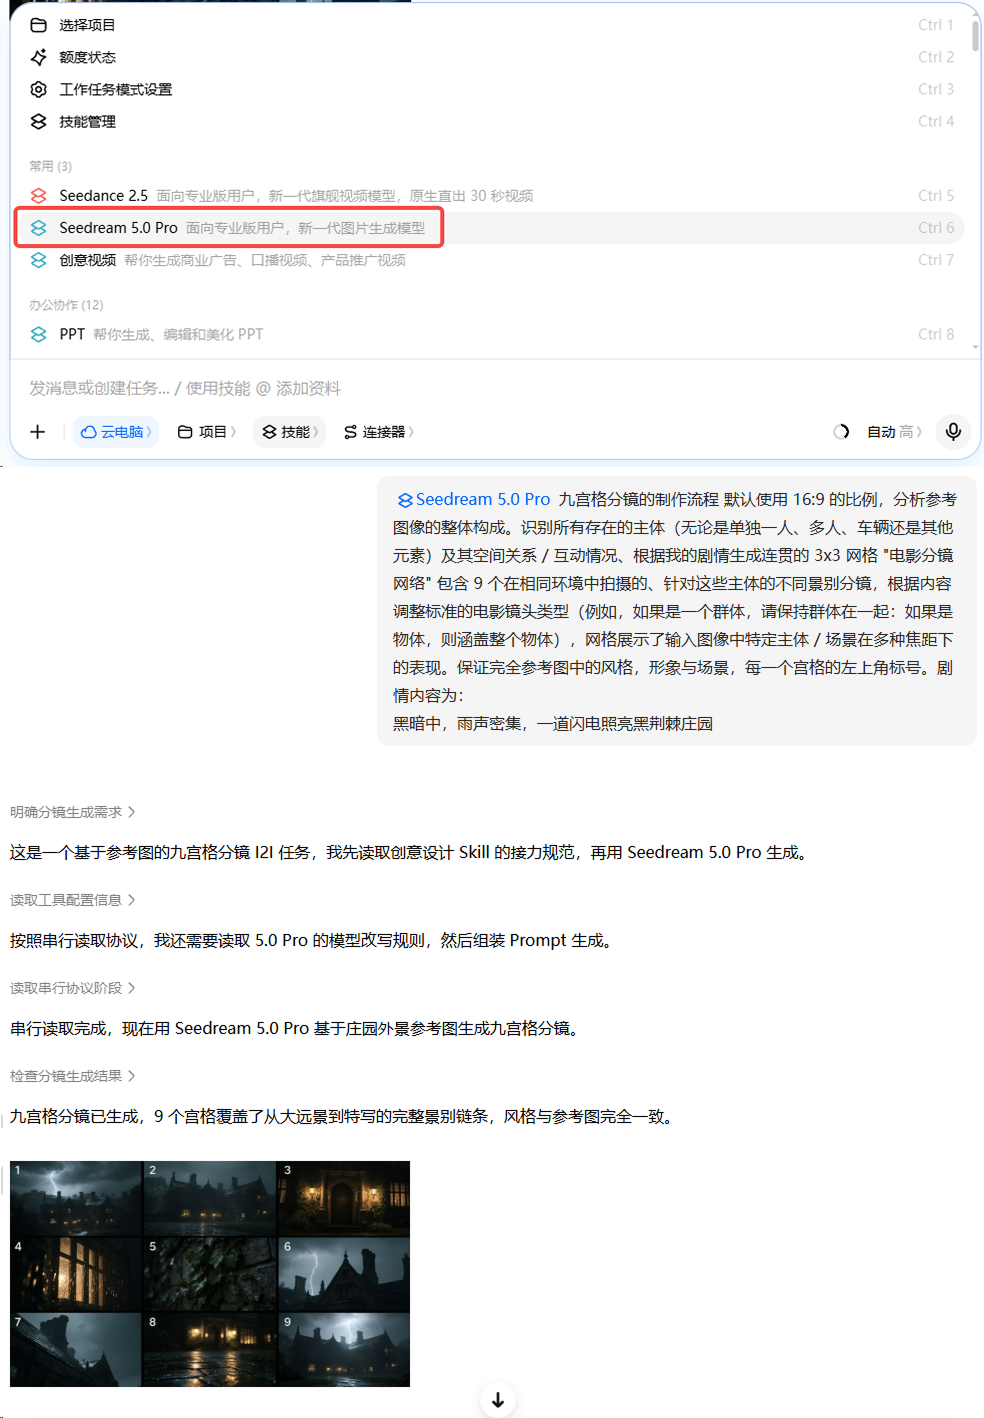
豆包生成界面
如果画面中有人物,比如这一段:
伊芙琳坐在长桌右侧。她面前的餐盘已经撤走,只剩一杯没有动过的红酒、一只泛黄的旧信封和两只戴着黑色手套的手。伊芙琳看着长桌尽头的空椅子。走廊里传来手杖敲击石面的声音。
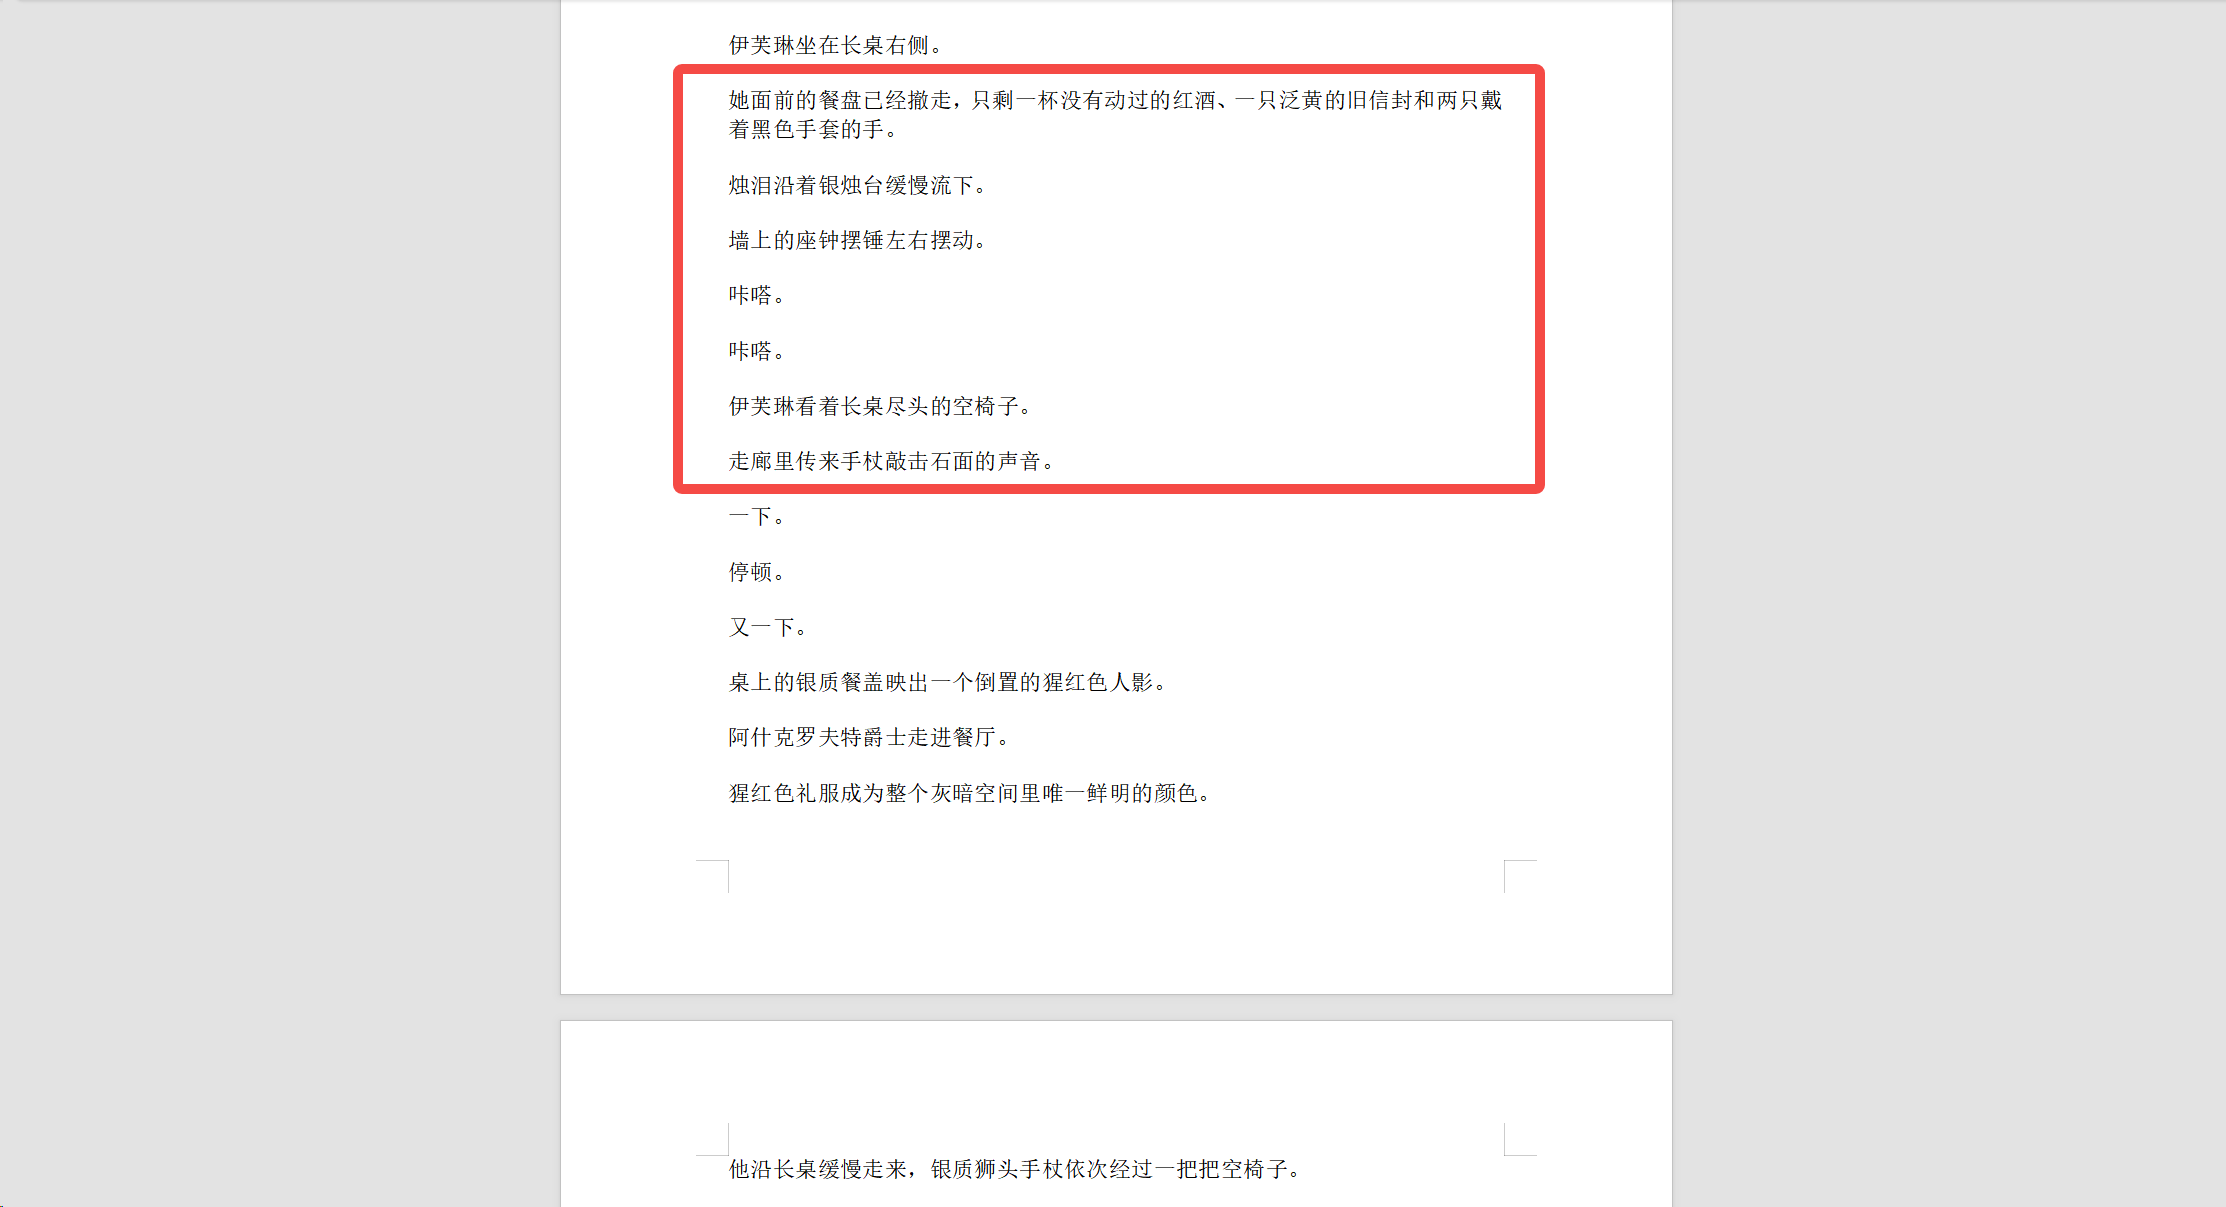
剧本内容
同时上传伊芙琳的人物图和庄园餐厅的场景图。输入提示词:
九宫格分镜的制作流程 默认使用16:9的比例,分析参考图像的整体构成。识别所有存在的主体(无论是单独一人、多人、车辆还是其他元素)及其空间关系/互动情况、根据我的剧情生成连贯的3x3网格"电影分镜网络"包含9个在相同环境中拍摄的、针对这些主体的不同景别分镜,根据内容调整标准的电影镜头类型(例如,如果是一个群体,请保持群体在一起:如果是物体,则涵盖整个物体),网格展示了输入图像中特定主体/场景在多种焦距下的表现。保证完全参考图中的风格,形象与场景,每一个宫格的左上角标号。剧情内容为:伊芙琳坐在长桌右侧。她面前的餐盘已经撤走,只剩一杯没有动过的红酒、一只泛黄的旧信封和两只戴着黑色手套的手。伊芙琳看着长桌尽头的空椅子。走廊里传来手杖敲击石面的声音。
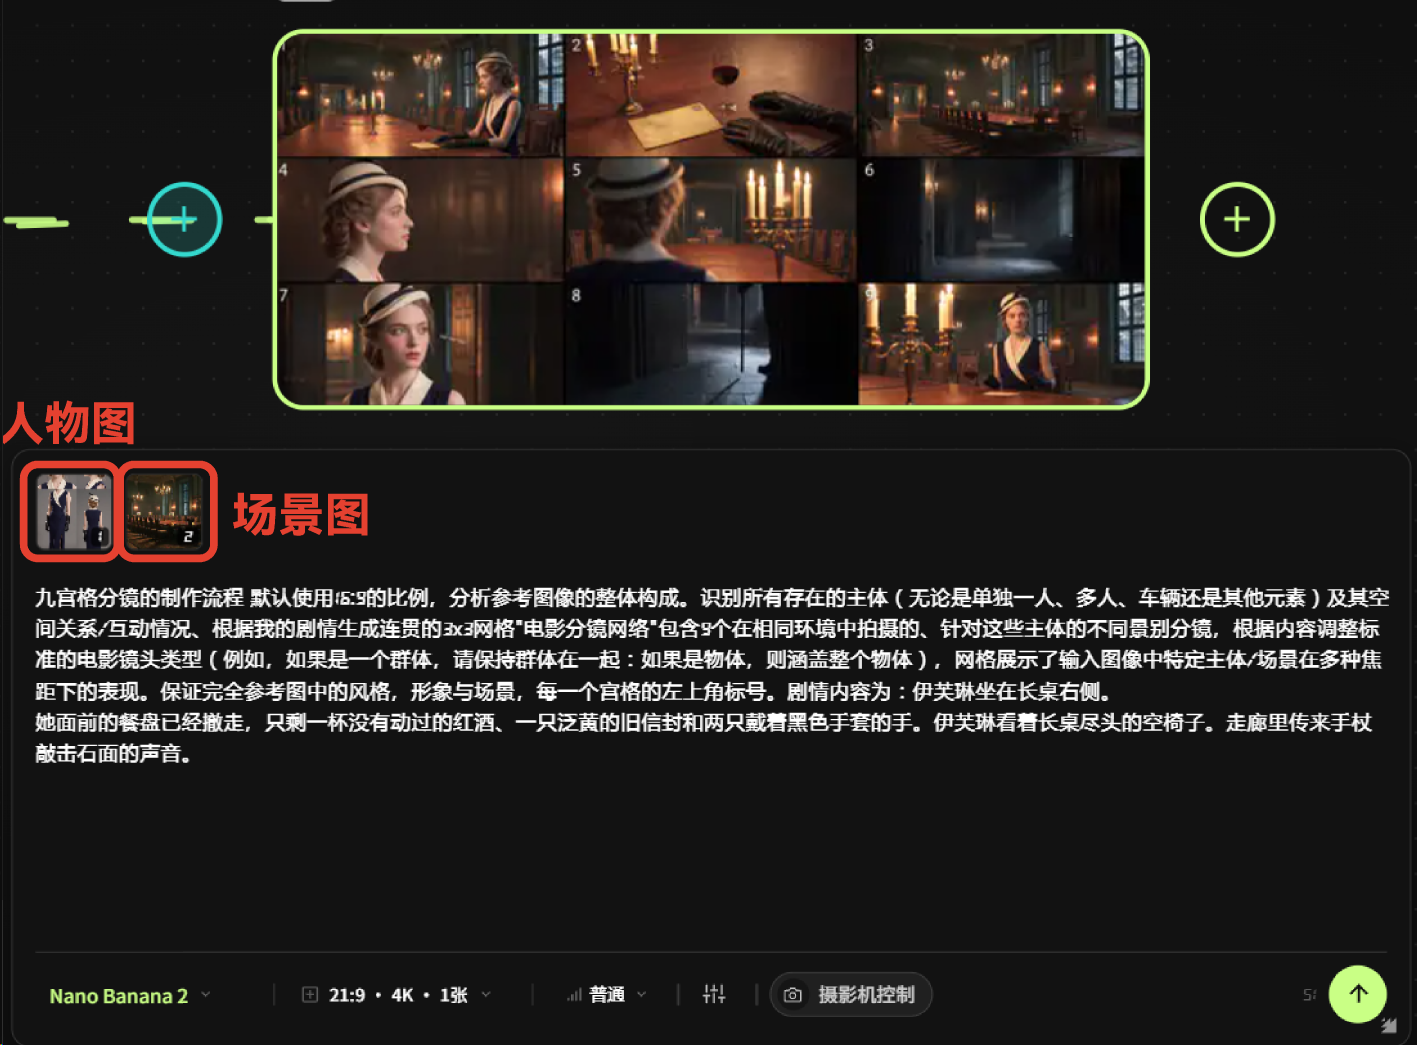
这里可以使用 Nano Banana Pro/2,也可以使用 Image 2.0/seedream5.0pro去生成。
需要注意的是,九宫格中的9张图片不是9个必须依次播放的连续镜头。
它们是在相同人物、场景和剧情条件下,由AI提供的不同景别、焦距和构图方案。它们的作用是帮助我们挑选镜头,而不是自动完成整段分镜。
一张9宫格里可能有多张图片可以使用
第三步:提取并修整选中的分镜
从九宫格中选出最合适的构图后,将对应的单张图片提取出来。
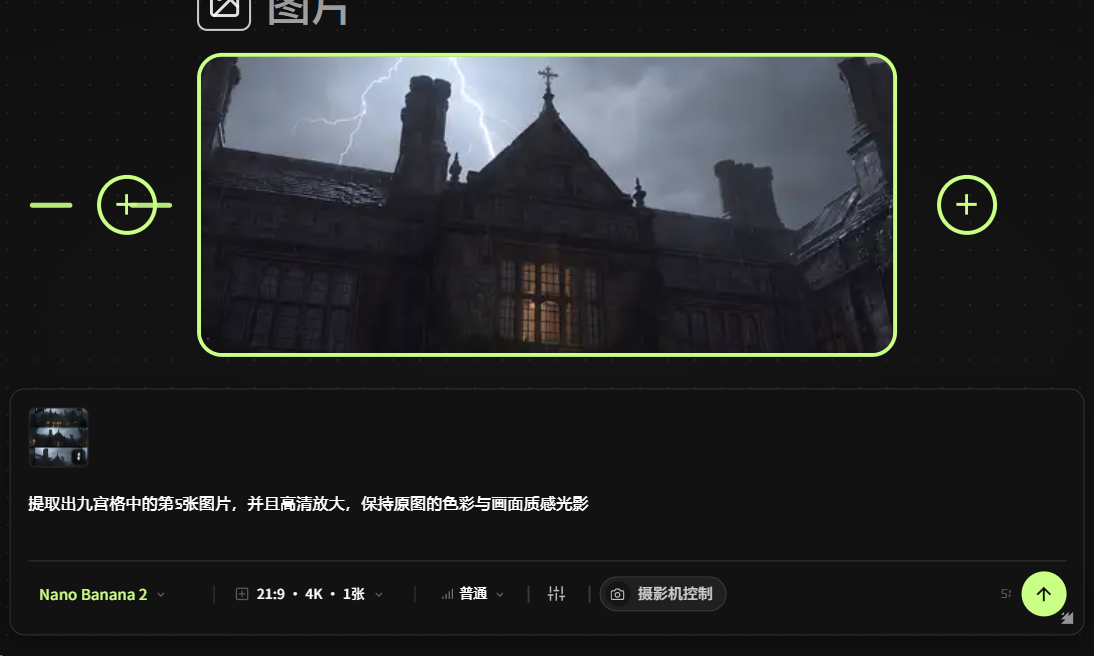
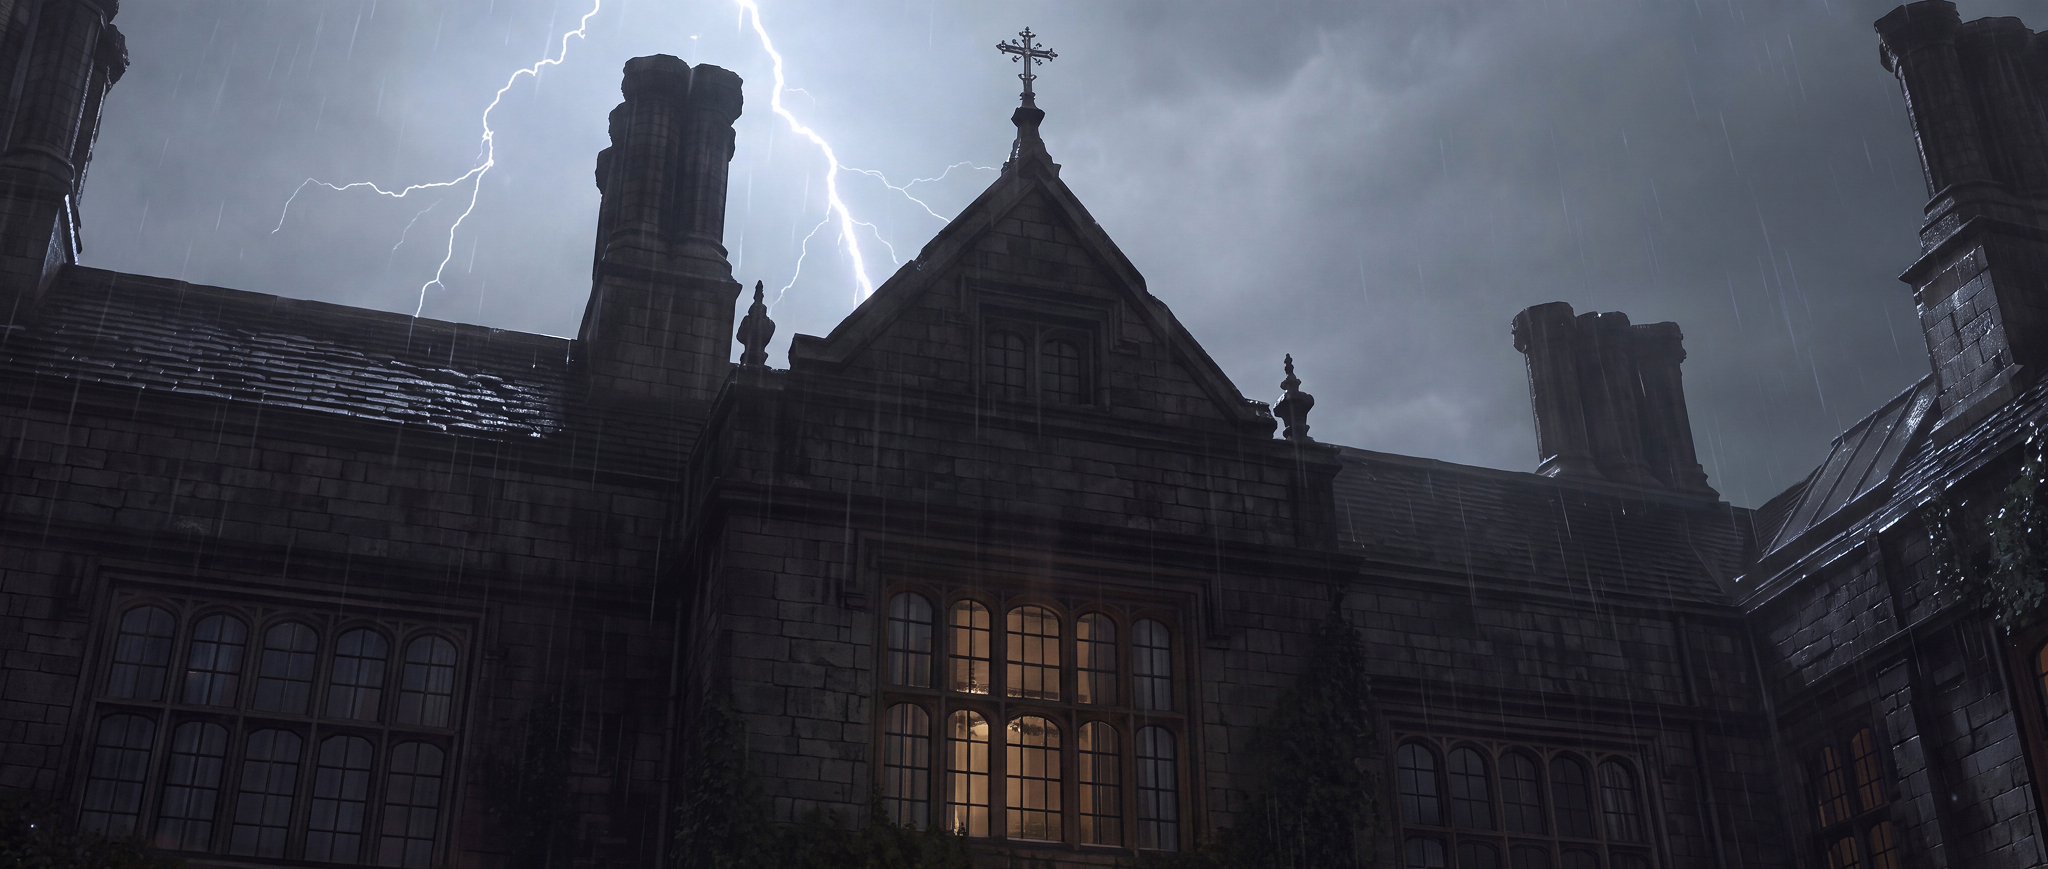
无人物画面可以使用(使用nanobanan pro /nanobanan 2/image2.0去生成):
“提取出九宫格中的第5张图片,并且高清化,保持与第5张图片的色彩、画面质感、光影以及构图完全一致。”
如果画面中有人物,可以补充人物一致性要求,并且上传你的人物资产去提取图片(使用nanobanan pro /nanobanan 2/image2.0去生成):
“提取出九宫格中的第9张图片,并且高清化,保持与第9张图片的色彩、画面质感、光影、构图以及人物动作完全一致。保证生成的人物与图2的人物完全一致。”
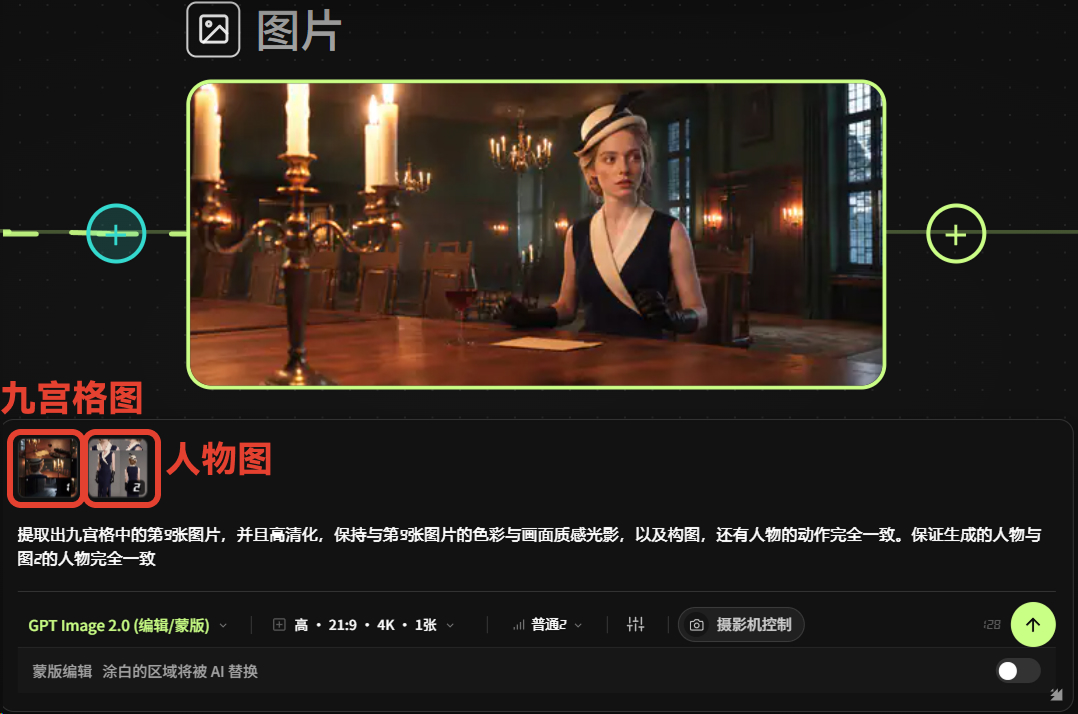
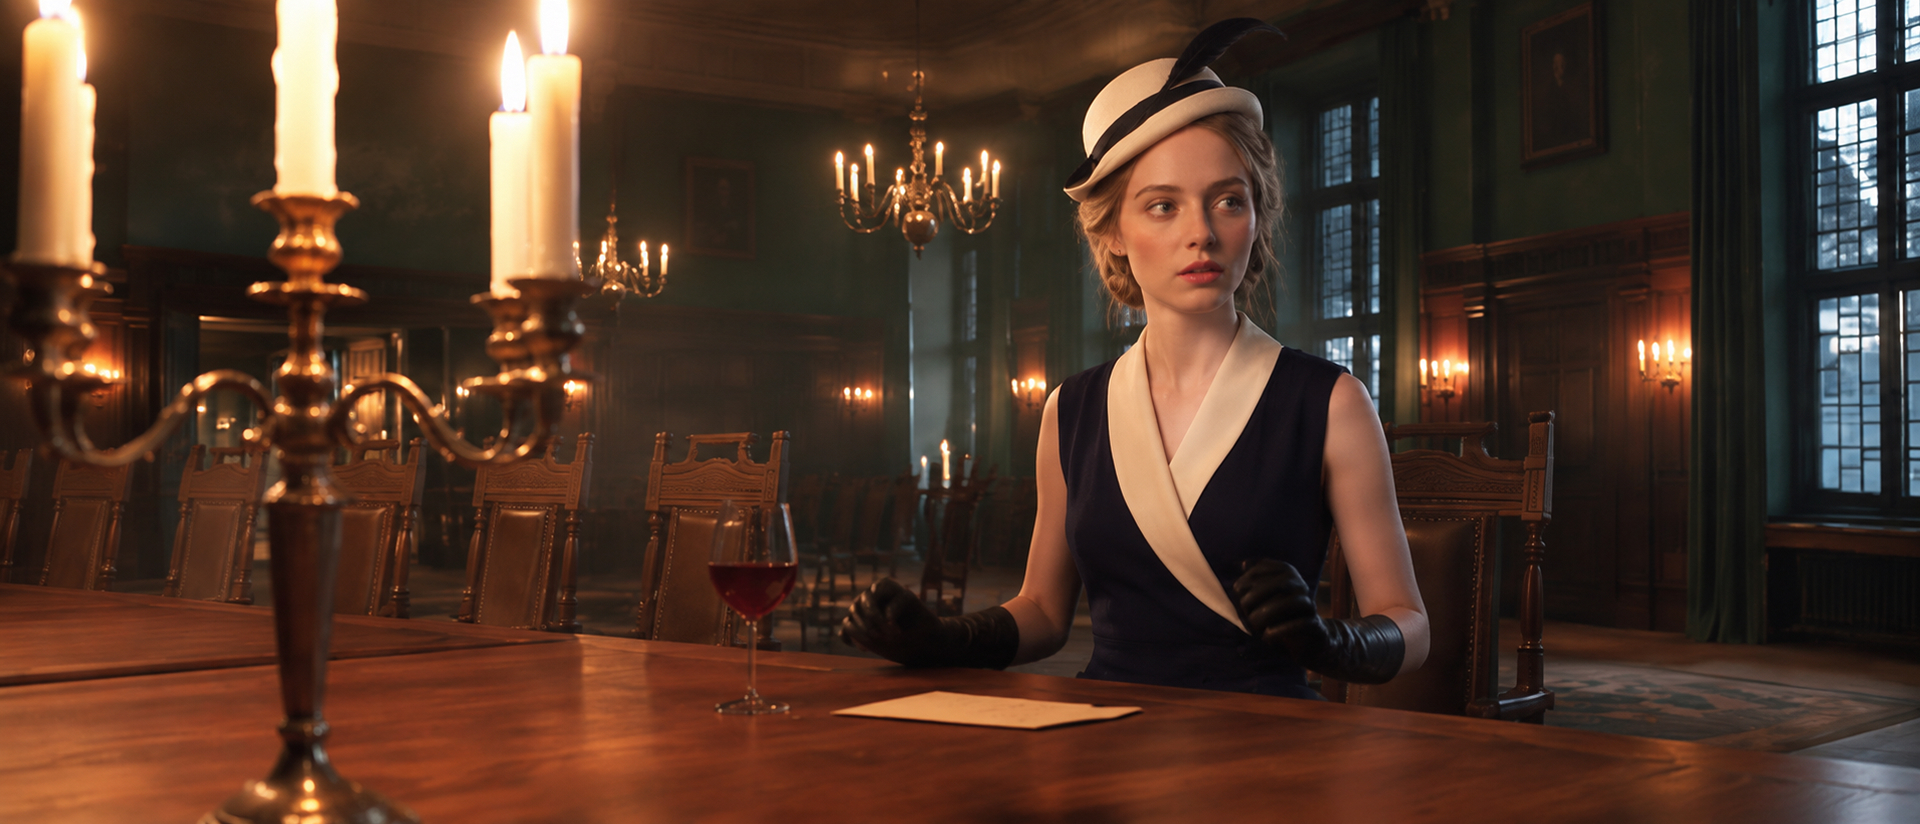
使用 Image 2.0 提取和高清化图片时,有时会出现锐化过强、人物皮肤僵硬、物体边缘发白,以及暗部噪点明显等问题。
遇到这种情况,可以先使用像素蛋糕(点击跳转官网)对图片进行二次修整,再把处理后的图片用于视频生成。
修图时主要处理:
1.祛油光
2.噪点消除
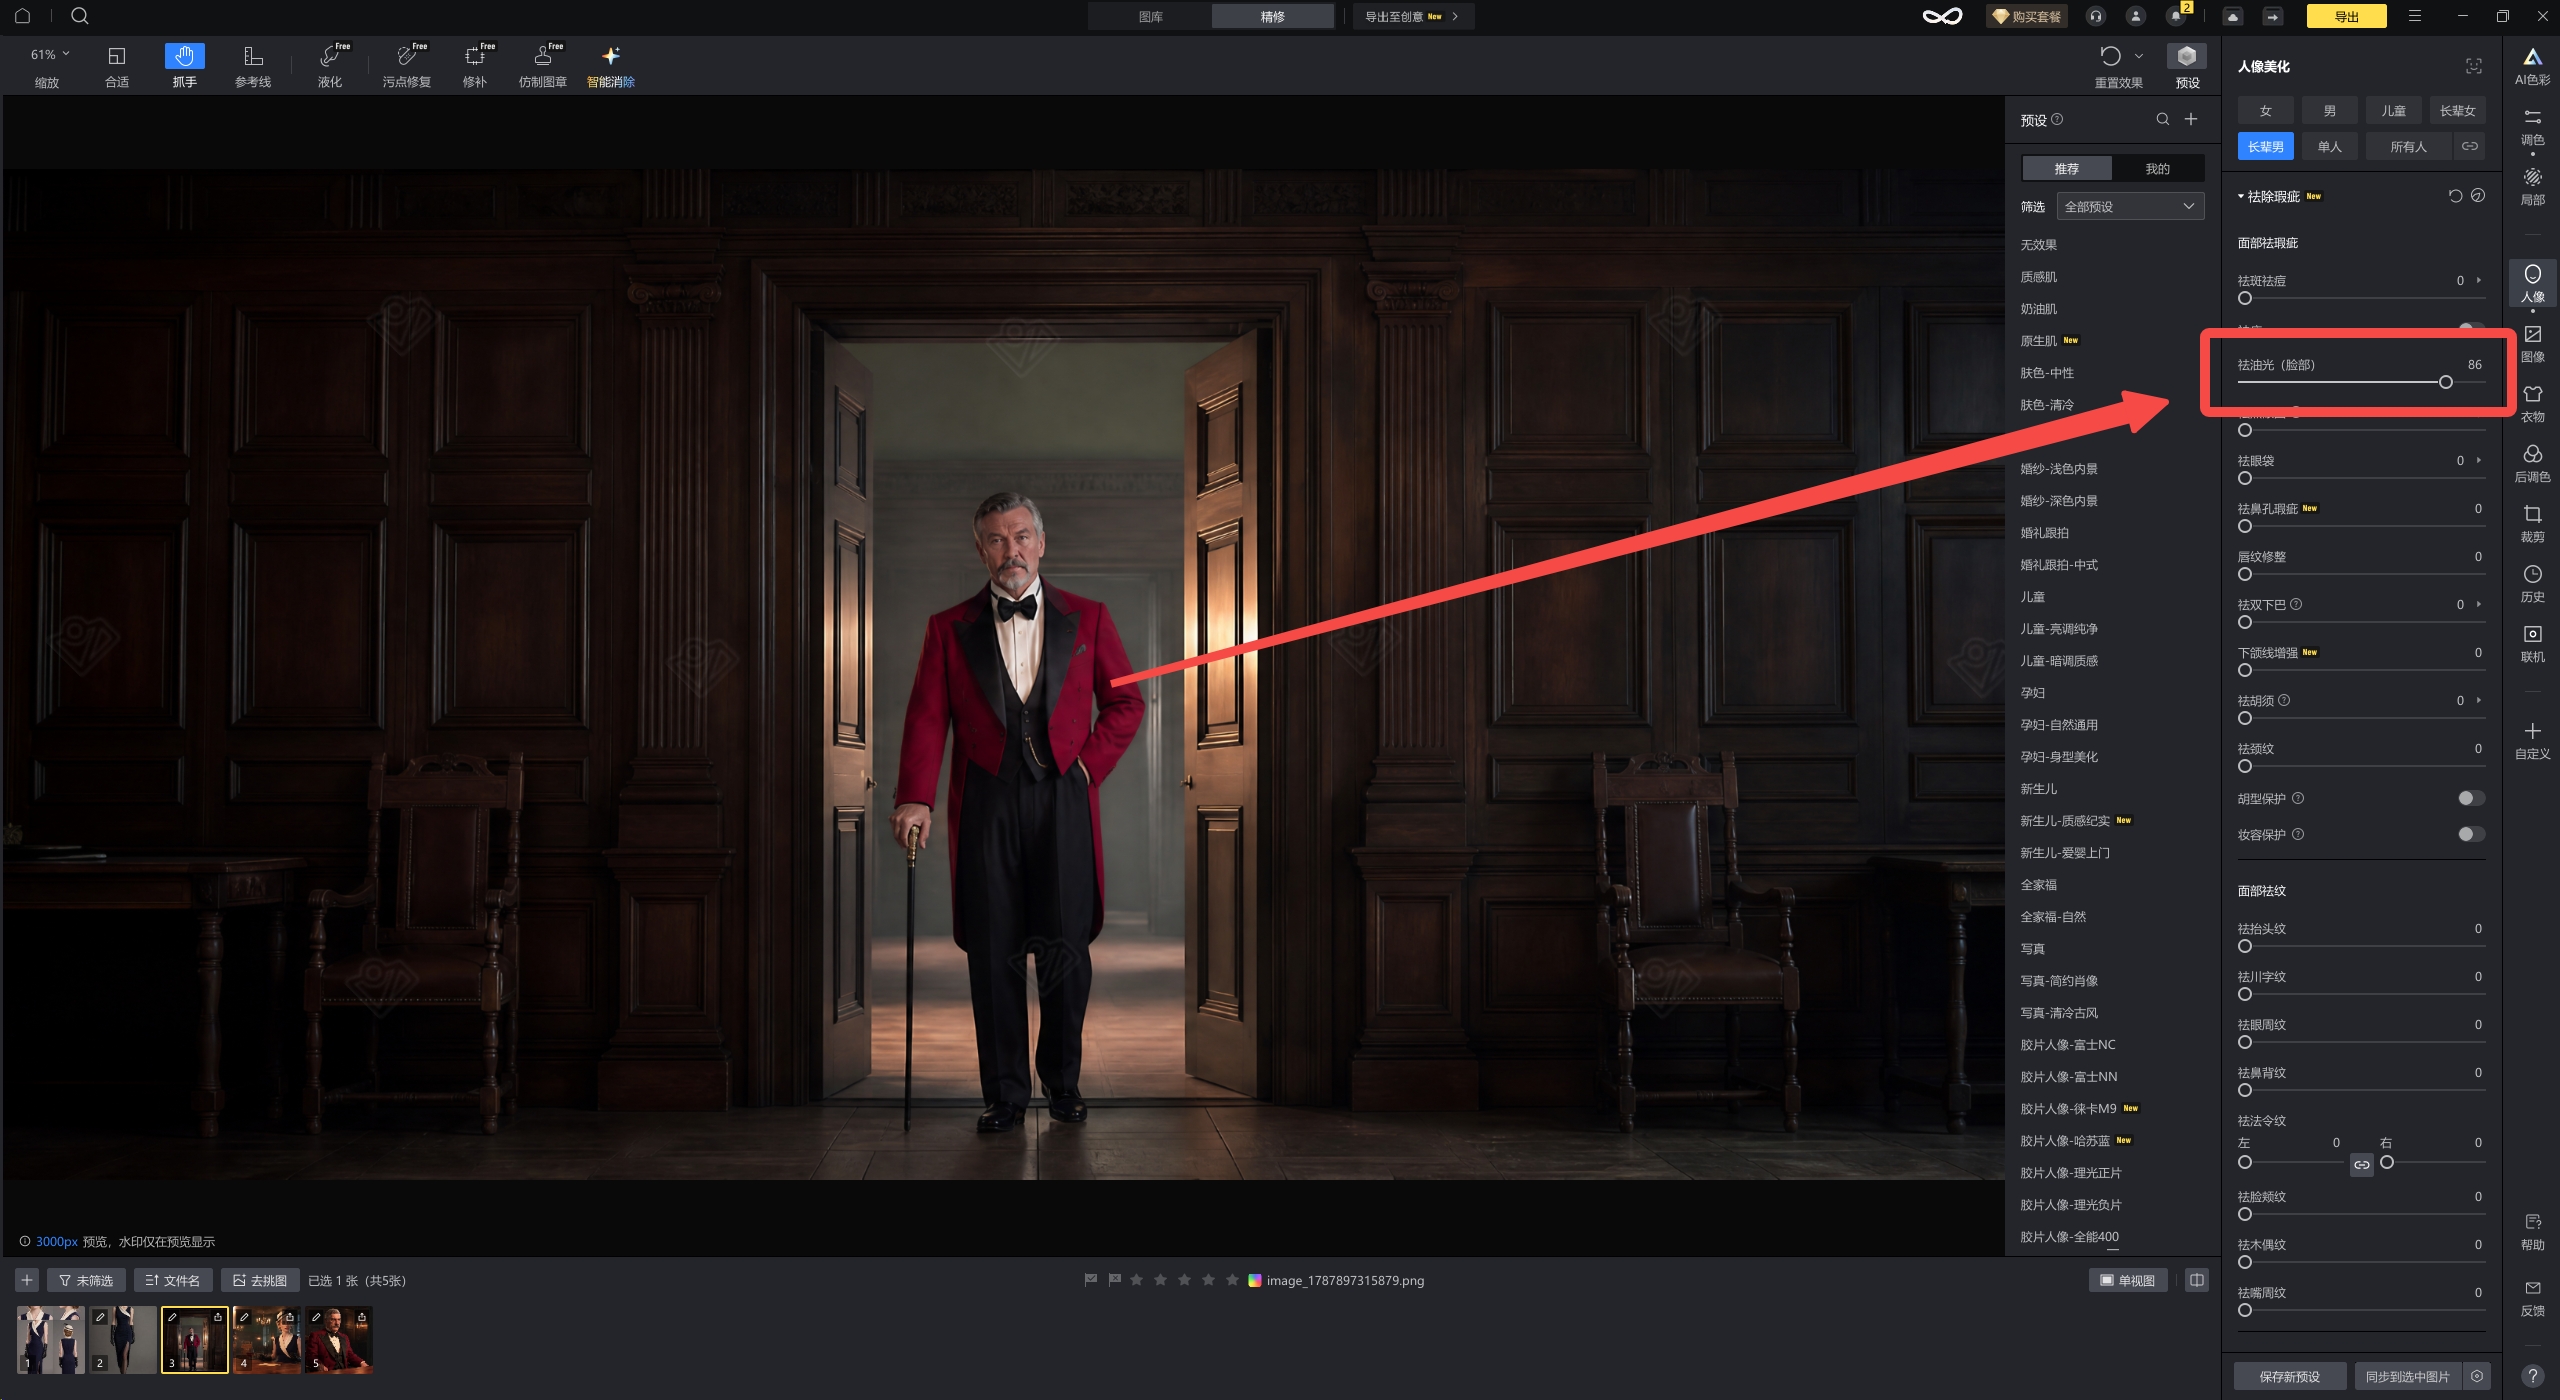
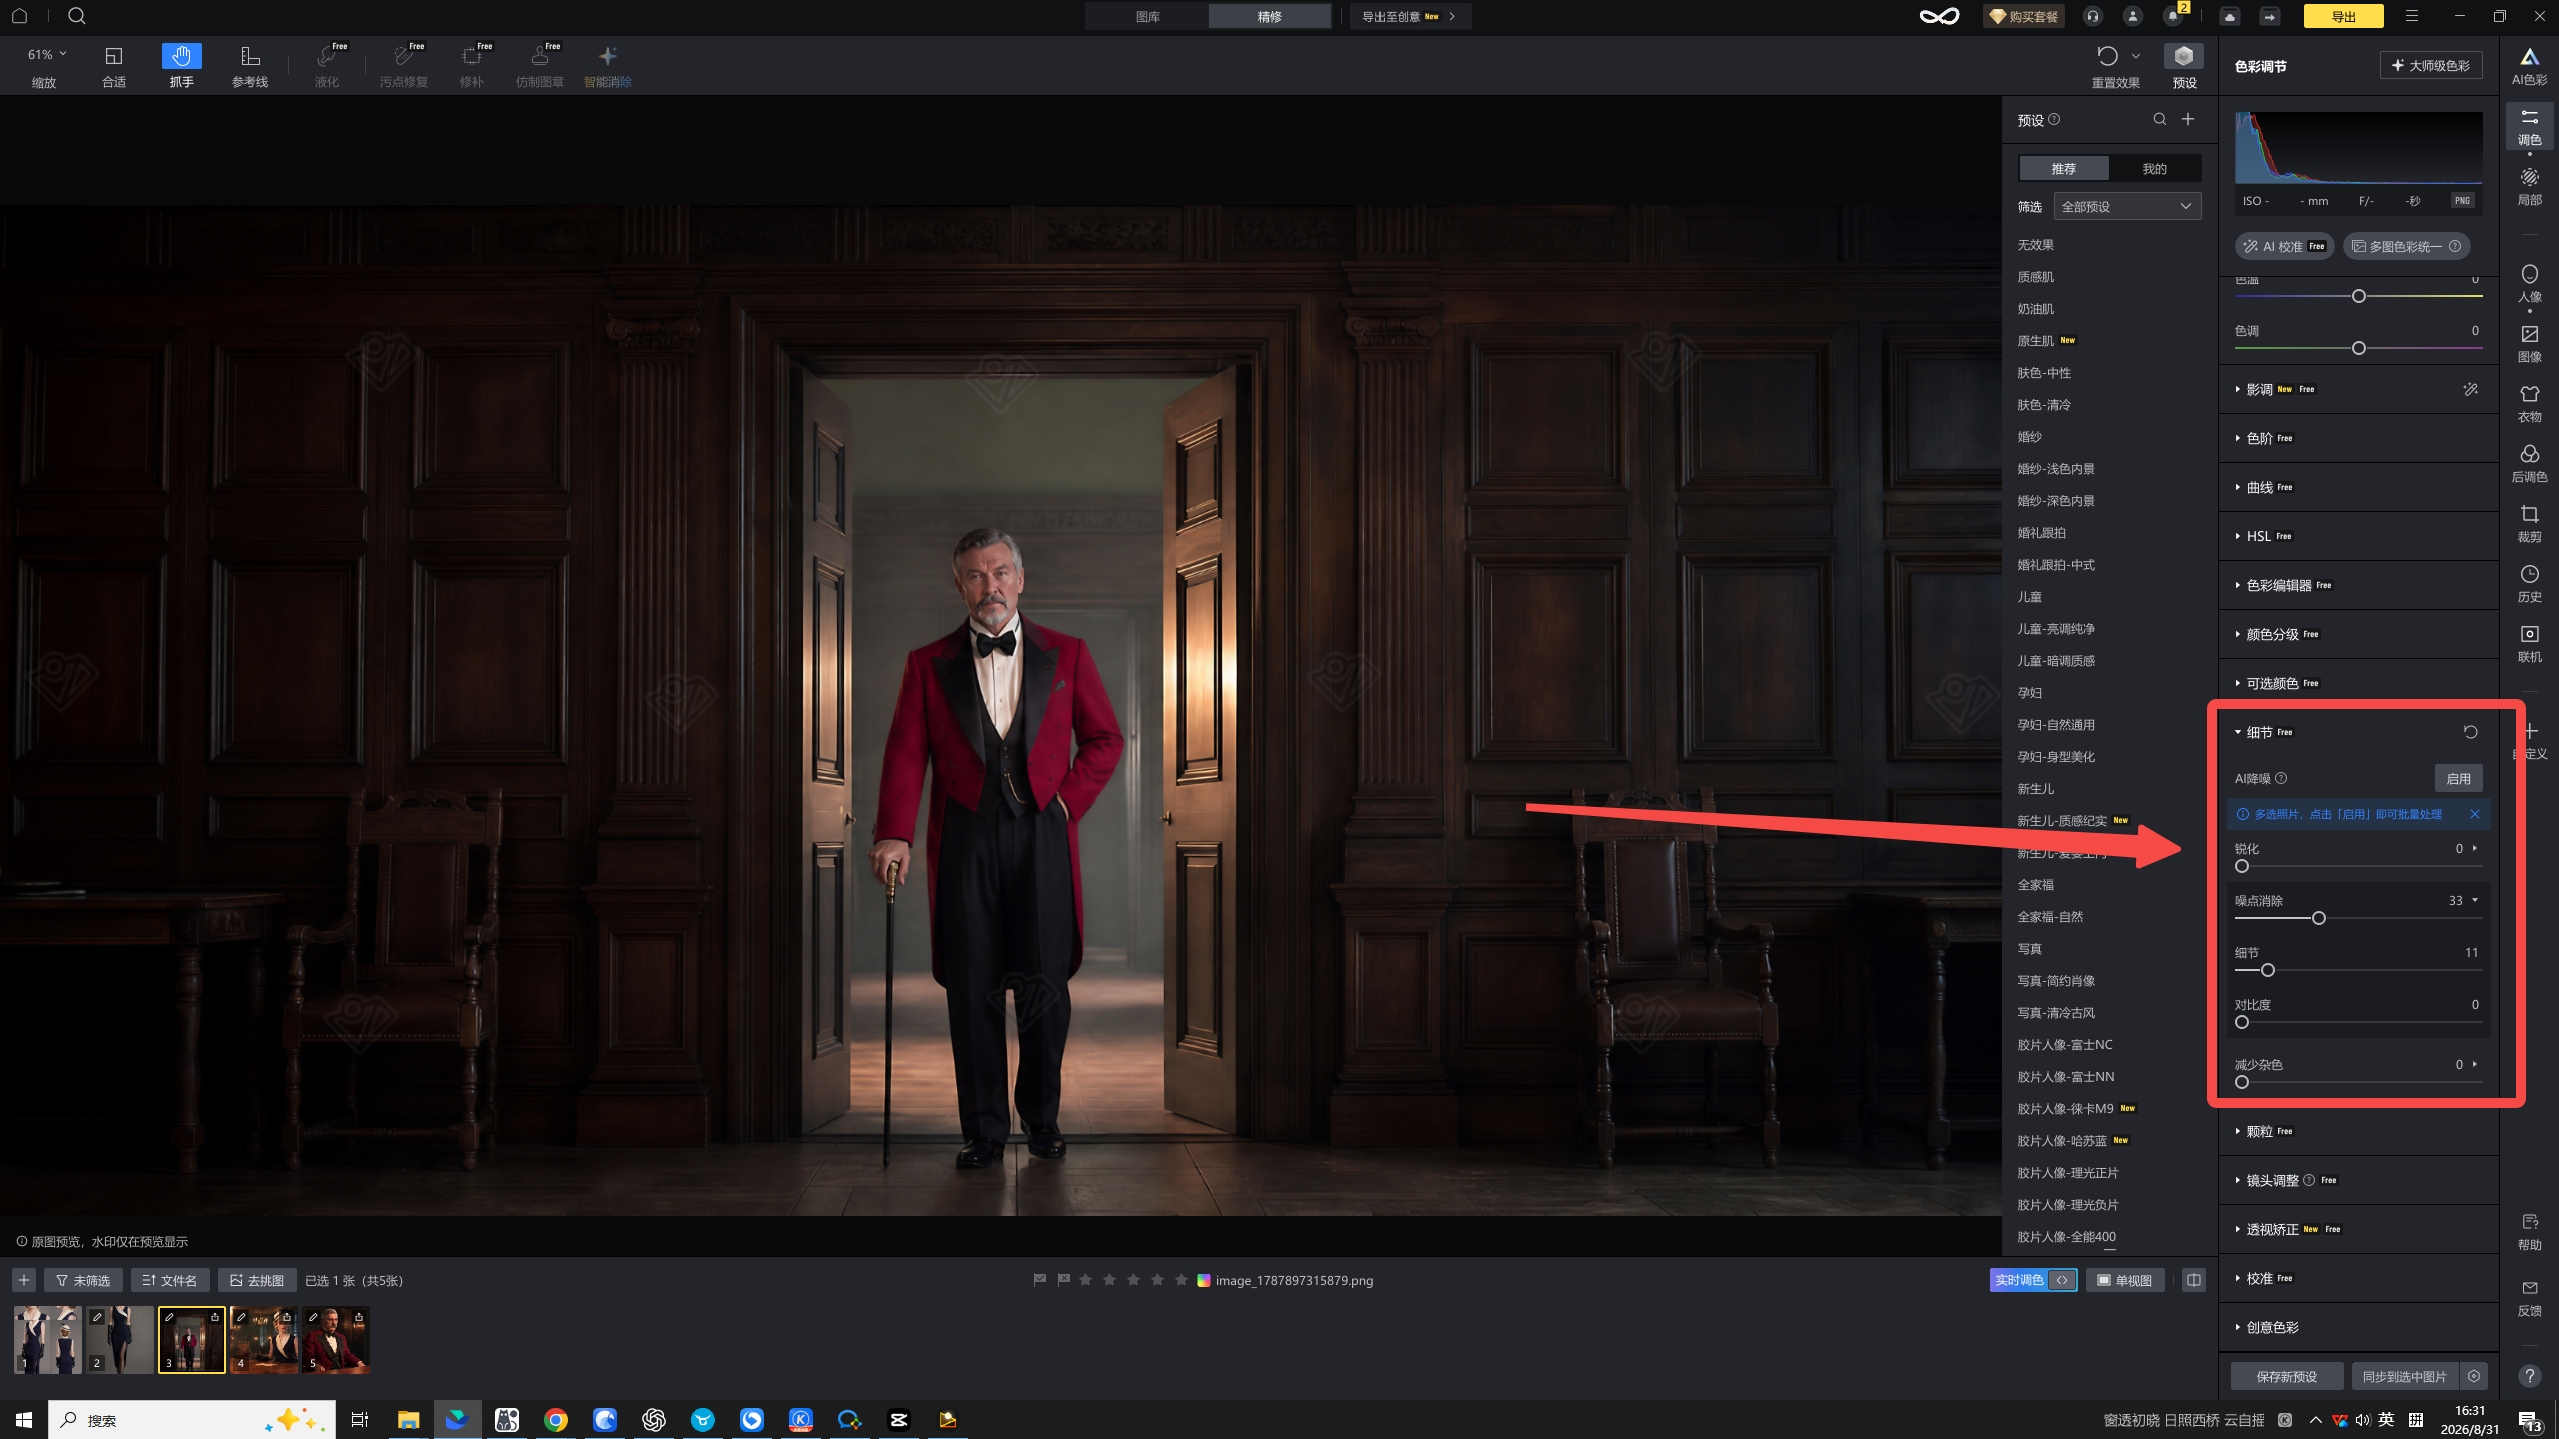
这一步的目的不是把图片处理得越光滑越好,而是消除可能在视频中被放大的瑕疵。
第四步:根据分镜生成视频
分镜确定后,就可以使用选中的图片生成视频。
在豆包中就可以选择seedance2.5
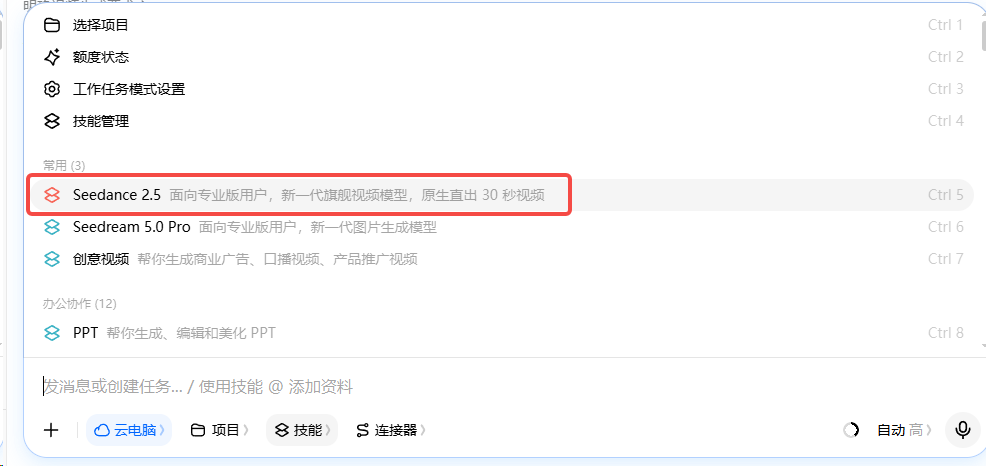
视频提示词需要根据当前分镜的画面内容来写。
如果镜头内容比较简单,可以直接使用剧本中的描述。
例如第一镜:
“黑暗中,雨声密集。一道闪电照亮黑棘庄园。石墙、尖顶、湿透的常春藤一闪而过。”
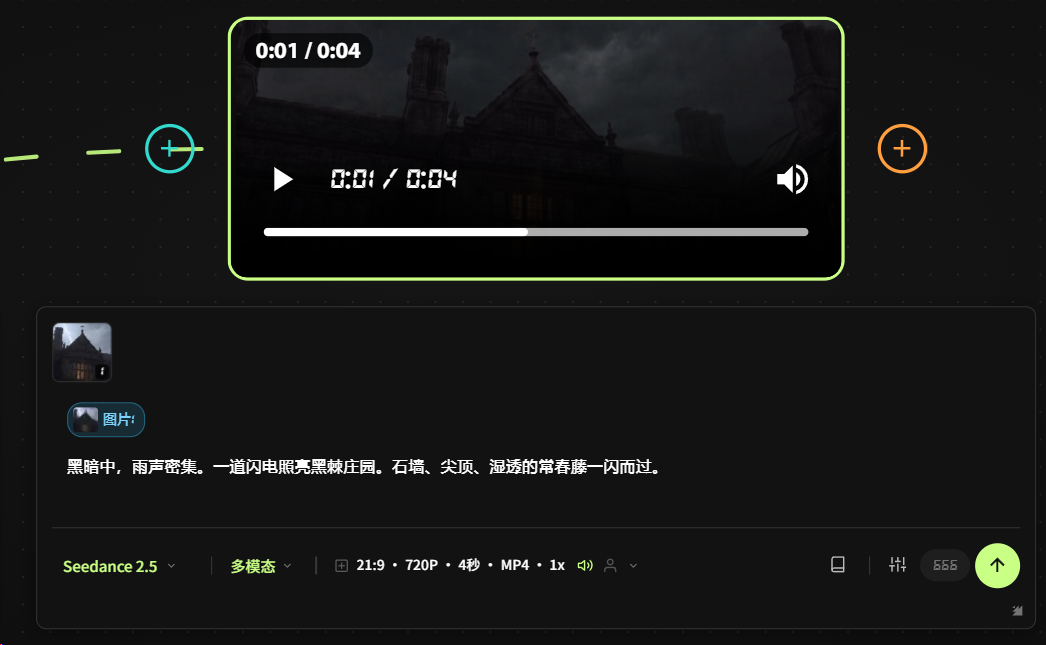
seedance2.5的效果最好,也可以使用minimax h3节省成本
如果画面中有人物,就需要结合分镜里的初始动作,继续设计人物接下来发生的动作、镜头变化和声音。
例如:
“不要生成任何背景音乐。人物形象参考图2。手持拍摄,画面微微晃动。人物原来右手放在信封上,随后听到一阵脚步声,以及拐杖落在地面的声音,缓慢抬头看向右侧。背景有雷声,以及摆钟左右摇摆的声音。不要生成任何背景音乐,只需要环境音效。”
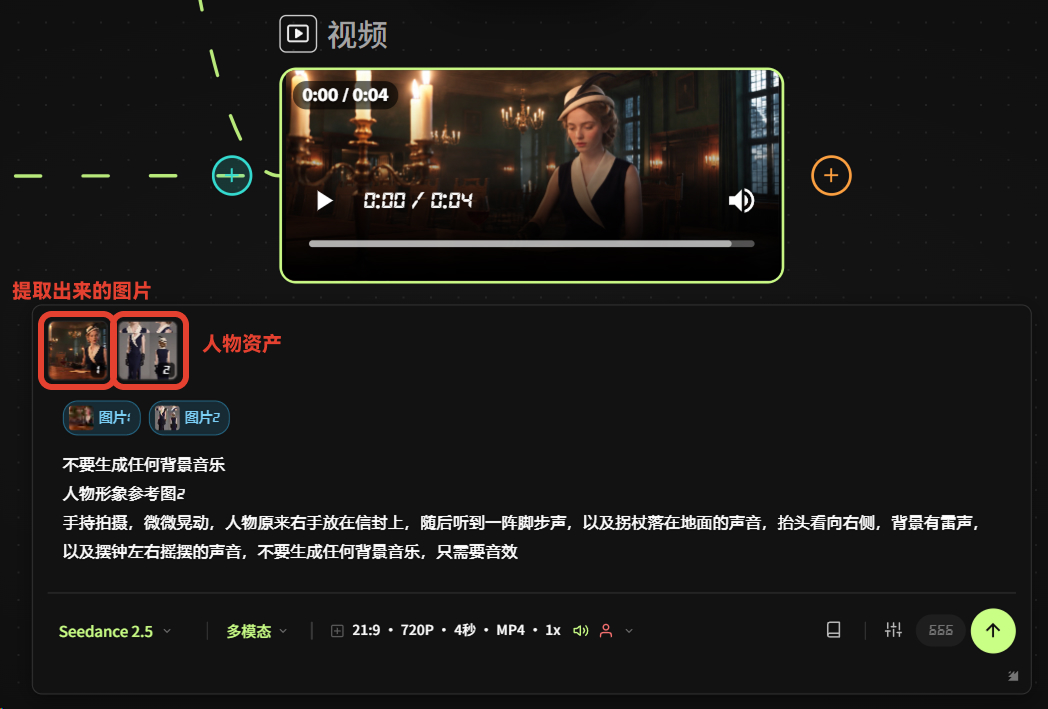
flowpix界面
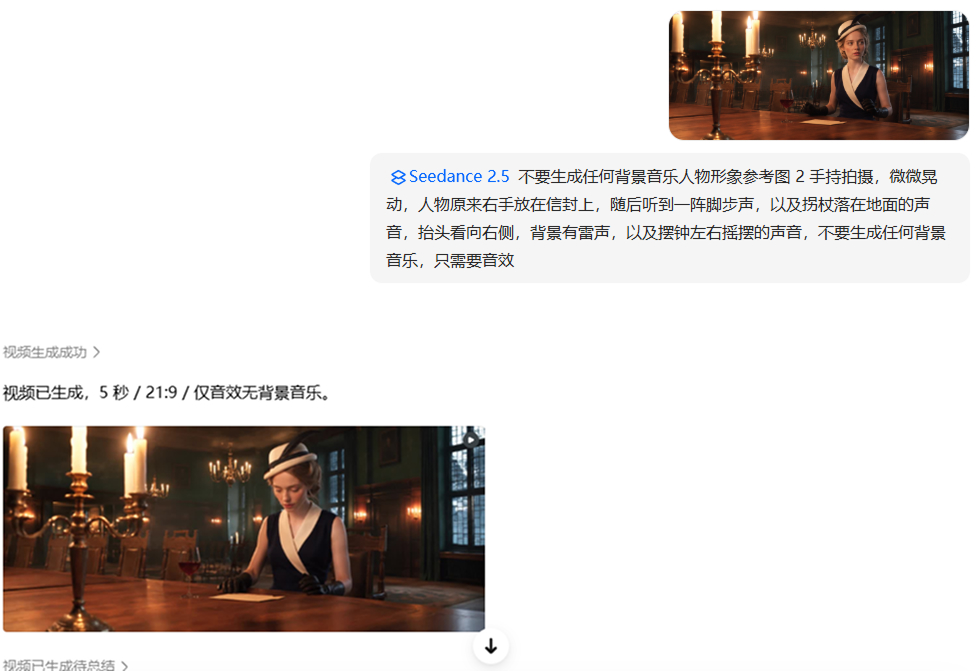
豆包界面
这里需要考虑前后内容的衔接。
如果分镜中人物的右手已经放在信封上,视频就应该从这个状态开始,而不是重新伸手去拿信封。
如果人物听见声音后看向画面右侧,那么接下来出现的人物或者声音来源也应该与这个方向对应。
第五步:在剪映中完成拼接
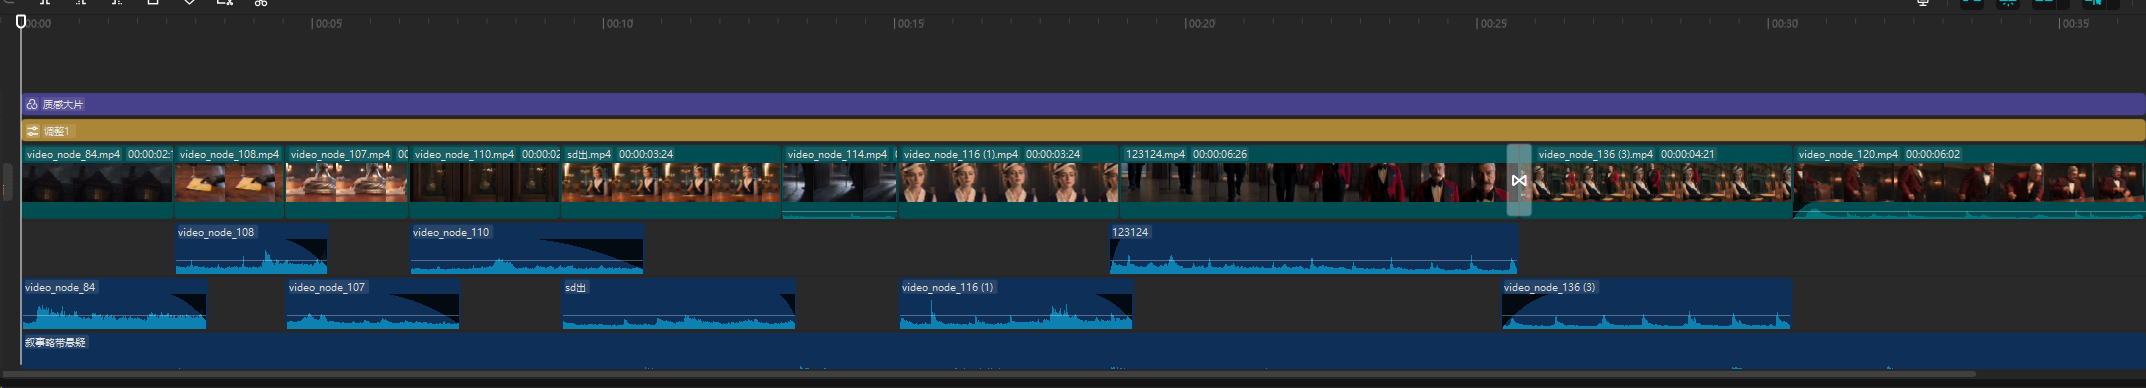
我在这次演示中一共制作了10段视频。
生成完成后,将所有视频导入剪映,按照剧情发生的顺序放入时间线。
如果两个片段之间略显生硬,可以在部分视频的开头或结尾加入轻微的渐入渐出,让衔接更加自然。
但不需要给每一个镜头都添加转场。人物动作、视线和声音能够顺利衔接时,直接切换通常会更加自然。
最后可以统一调整滤镜、对比度、饱和度和胶片颗粒,让不同时间生成的画面保持相近的视觉质感。
总结
Seedance 2.5的“论文式提示词”适合镜头设计已经非常明确,并且具备一定编剧和导演经验的创作者。
如果暂时无法稳定写出完整的长视频提示词,或者不希望因为局部错误反复生成整段视频,可以使用这套方法:
准备剧本与资产 → 生成九宫格分镜 → 筛选、提取并修图 → 分段生成视频 → 剪辑统一成片
这套流程没有把所有判断都交给AI。
AI先提供不同的镜头方案,人再决定使用哪个构图、如何继续动作,以及怎样连接前后的画面。
相比直接生成整段视频,这种方法更容易发现问题、调整镜头和控制成本,也更适合需要保持人物、场景与叙事连贯性的AI短片。