很多人做AI人物视频时,会把重点放在脸上:五官要真实,皮肤要细腻,眼神要自然,光影要电影感。可是视频生成出来以后,还是很容易让人一眼看出是AI。
原因很简单:视频不是静态图片。图片只要一瞬间好看就够了,但视频需要人物在几秒钟里持续保持真实。只要人物站得太稳、表情不变、动作没有原因,画面就会显得僵硬。
真实的人不会一直像雕塑一样停在那里。人在等车时会看手机,在咖啡店会转杯子,在电梯里会看楼层,在走路时会被风吹乱头发。正是这些细微动作和生活反应,让人物像是正在经历一个真实瞬间。
这一节,我们就来讲AI视频人物提示词的核心技巧:不要只写人物长什么样,而要写人物正在做什么、为什么这样做,以及动作如何自然持续。
一、AI视频人物为什么容易假?
先看这张图。
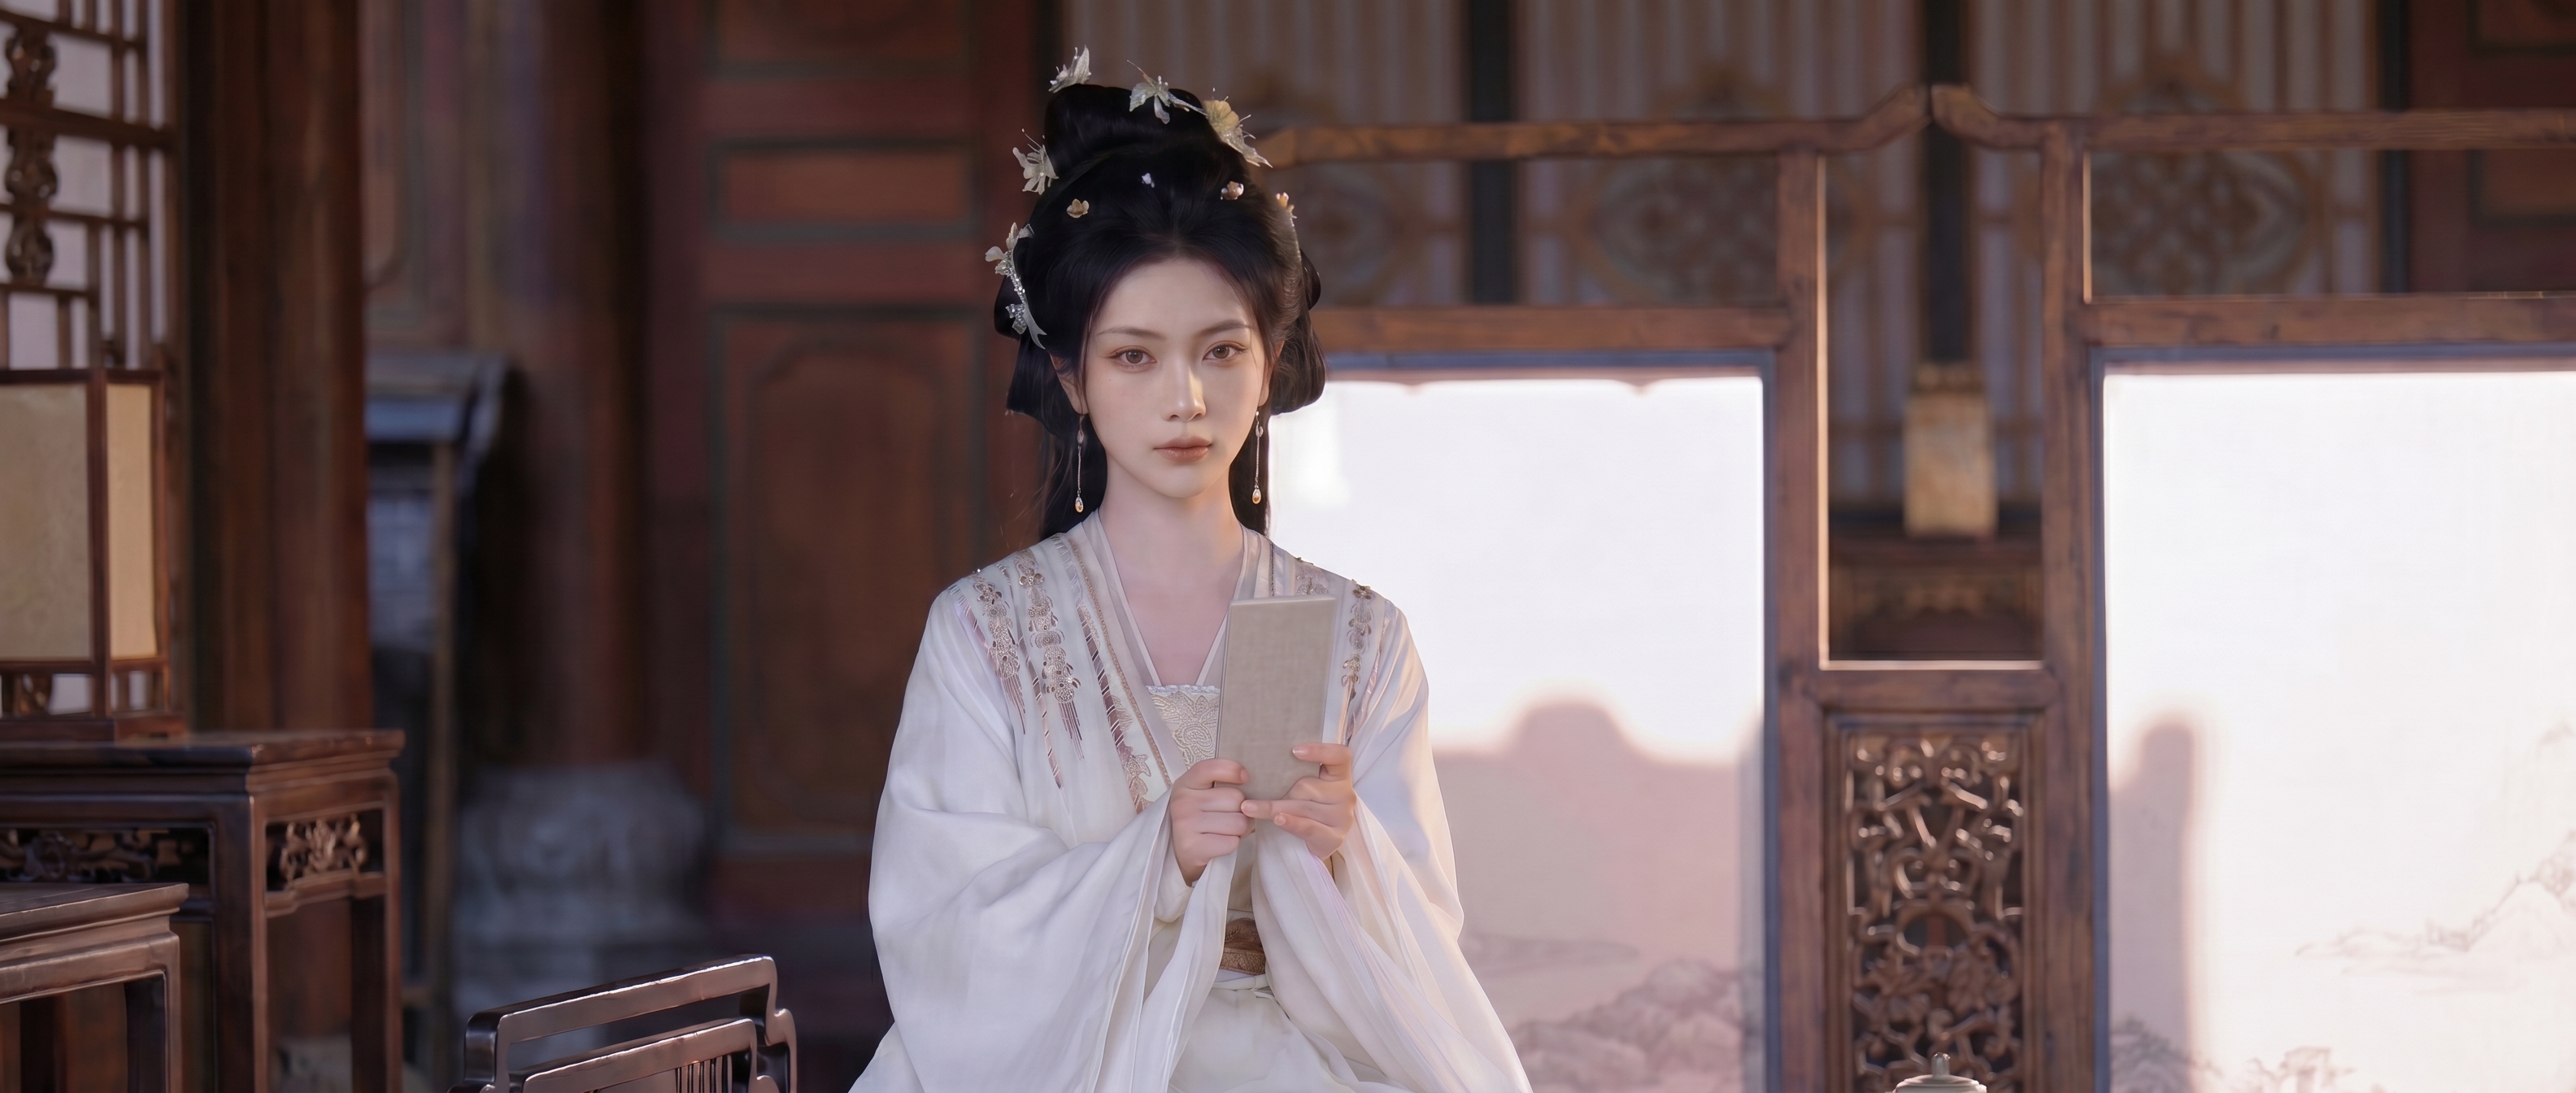
画面里的人物、服装、场景都很精致,但如果把它直接做成视频,只写:
古风女子站在房间里,手里拿着书信,缓慢看向镜头,衣袖轻轻飘动。
这样虽然有动态,但还是容易像AI。因为人物为什么拿着书信?为什么看向镜头?她此刻是在等消息,还是刚读到重要内容?如果没有原因,动作就只是表演。
AI视频真正要写的,不只是“人物怎么动”,而是人物为什么这样动。
比如可以改成:
古风女子站在安静的房间里,双手拿着一封刚收到的书信。她原本低头看信,像是读到一半突然停住,手指下意识捏紧纸张,随后缓慢抬眼看向前方,表情从平静变成轻微不安。衣袖随着呼吸有细微起伏,发饰轻轻晃动,镜头缓慢推进,画面安静克制,古风电影感。
这样写,人物就不是单纯“拿着信站着”,而是正在经历一个瞬间:她读到了某个消息,所以停住、捏紧纸张、抬头、情绪变化。
所以,AI视频提示词的重点不是简单描述动态,而是写清楚:
人物在哪里,正在做什么,为什么这样动,以及动作后有什么细微反应。
同样一张图,静态看的是画面美感;做成视频时,看的就是人物有没有真实的处境和情绪。
二、视频提示词的核心:动作要有行为动机
很多人写视频提示词,会直接描述动作:
女子抬头。
女孩回头。
男生喝咖啡。
人物慢慢走路。
头发随风飘动。
这些写法都没有错,但它们只是“动作表面”。如果动作没有原因,视频就容易变成摆拍。
案例
再看这张图。
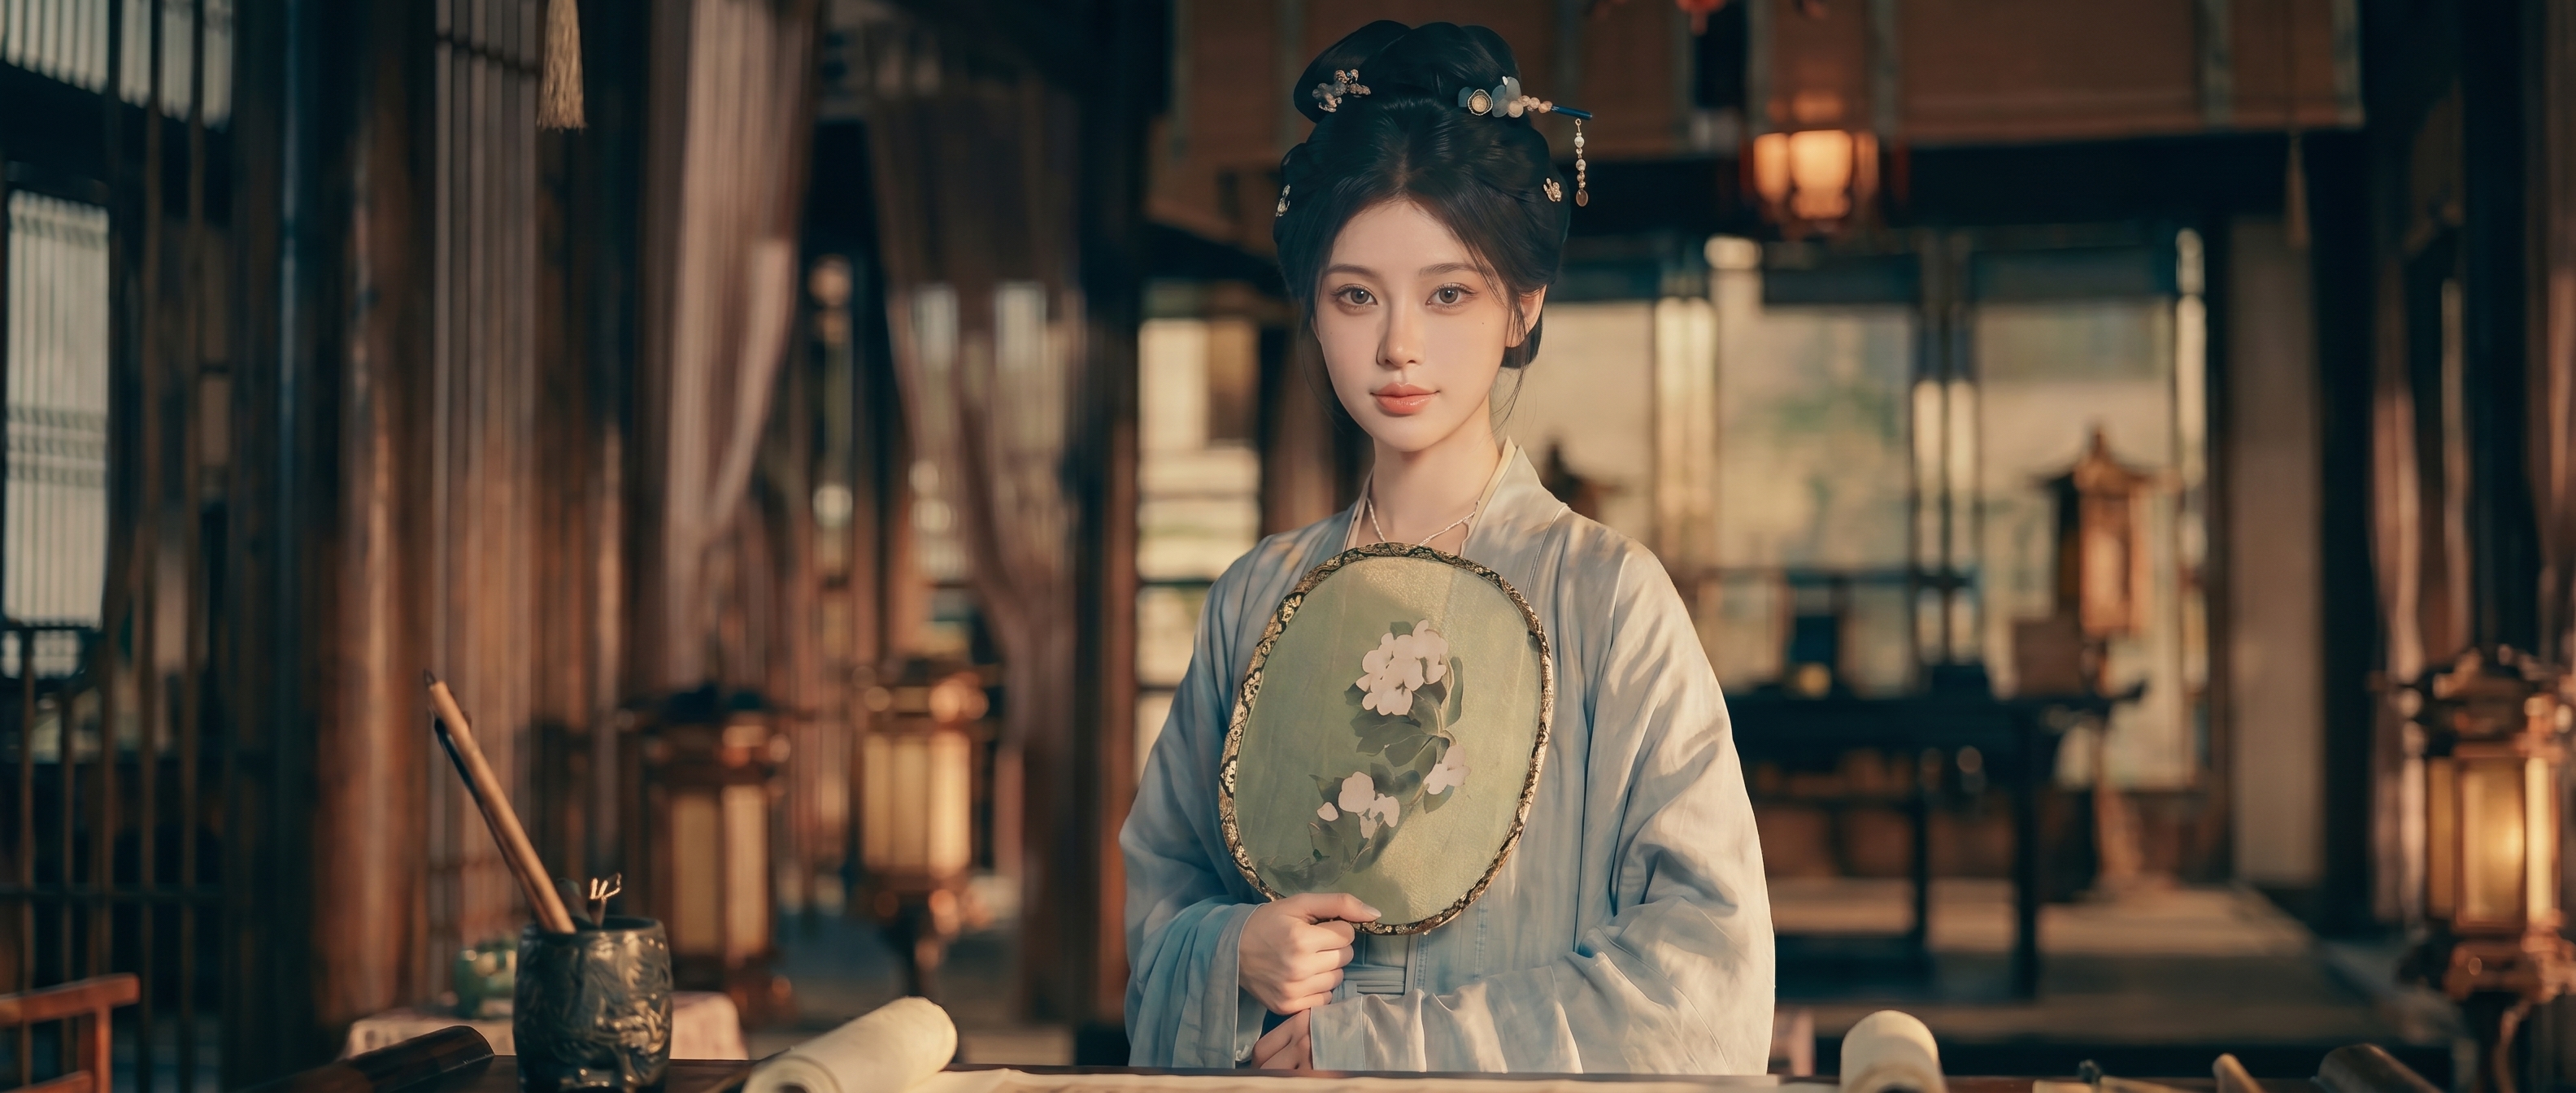
画面里的人物站在古风房间中,手里拿着团扇,服装、灯光和场景都很完整。静态图已经很好看,但如果做成视频,只写:
古风女子站在房间里,手持团扇,缓慢微笑,轻轻摇扇,镜头缓慢推进。
这段提示词不是没有动态。人物会笑,团扇会动,镜头也会推进。但问题是:她为什么摇扇?为什么看向前方?她是在等人,还是刚听到门外有声音?
如果没有原因,动作就容易变成表演。
AI视频提示词真正要写的,不只是“她做了什么动作”,而是这个动作为什么发生。
比如可以改成:
古风女子站在安静的书房里,手里握着一把团扇,像是在等待门外的人进来。她原本低头看着桌上的书卷,听到门外传来轻微脚步声后,才慢慢抬眼看向前方。手中的团扇原本轻轻摇动,随后动作慢慢停住,表情从平静变成一丝克制的期待。发饰轻轻晃动,衣袖有细微起伏,镜头缓慢推进,古风电影感,画面安静自然。
这样写,人物就不是单纯“拿着团扇站着”,而是有了一个明确处境:她在等人。
所以她会抬眼,会停下摇扇,表情也会有细微变化。
同样是“手持团扇”,普通写法只是让人物动起来;更好的写法,是让人物因为听到声音、等待来人、察觉变化而自然动起来。
写视频提示词时,可以多问一句:
这个动作是被什么事情触发的?
人物摇扇,是因为在安静等待。
人物停住,是因为听到门外声音。
人物抬眼,是因为有人靠近。
人物表情变化,是因为情绪被打断。
当动作有了行为动机,视频里的角色就不再像是在摆姿势,而像是正在经历一个真实瞬间。
三、单人物视频提示词公式
做单人物视频时,很多人只会写一个动作,比如“低头”“抬眼”“转身”“发呆”,但这样写出来的人物,往往还是像在摆拍。
更好的方法是,把提示词拆成一个完整过程。
单人物视频可以套用这个公式:
人物身份 + 具体场景 + 当前状态 + 动作原因 + 连续动作 + 细微反应 + 镜头语言
我们就用这张图做案例。
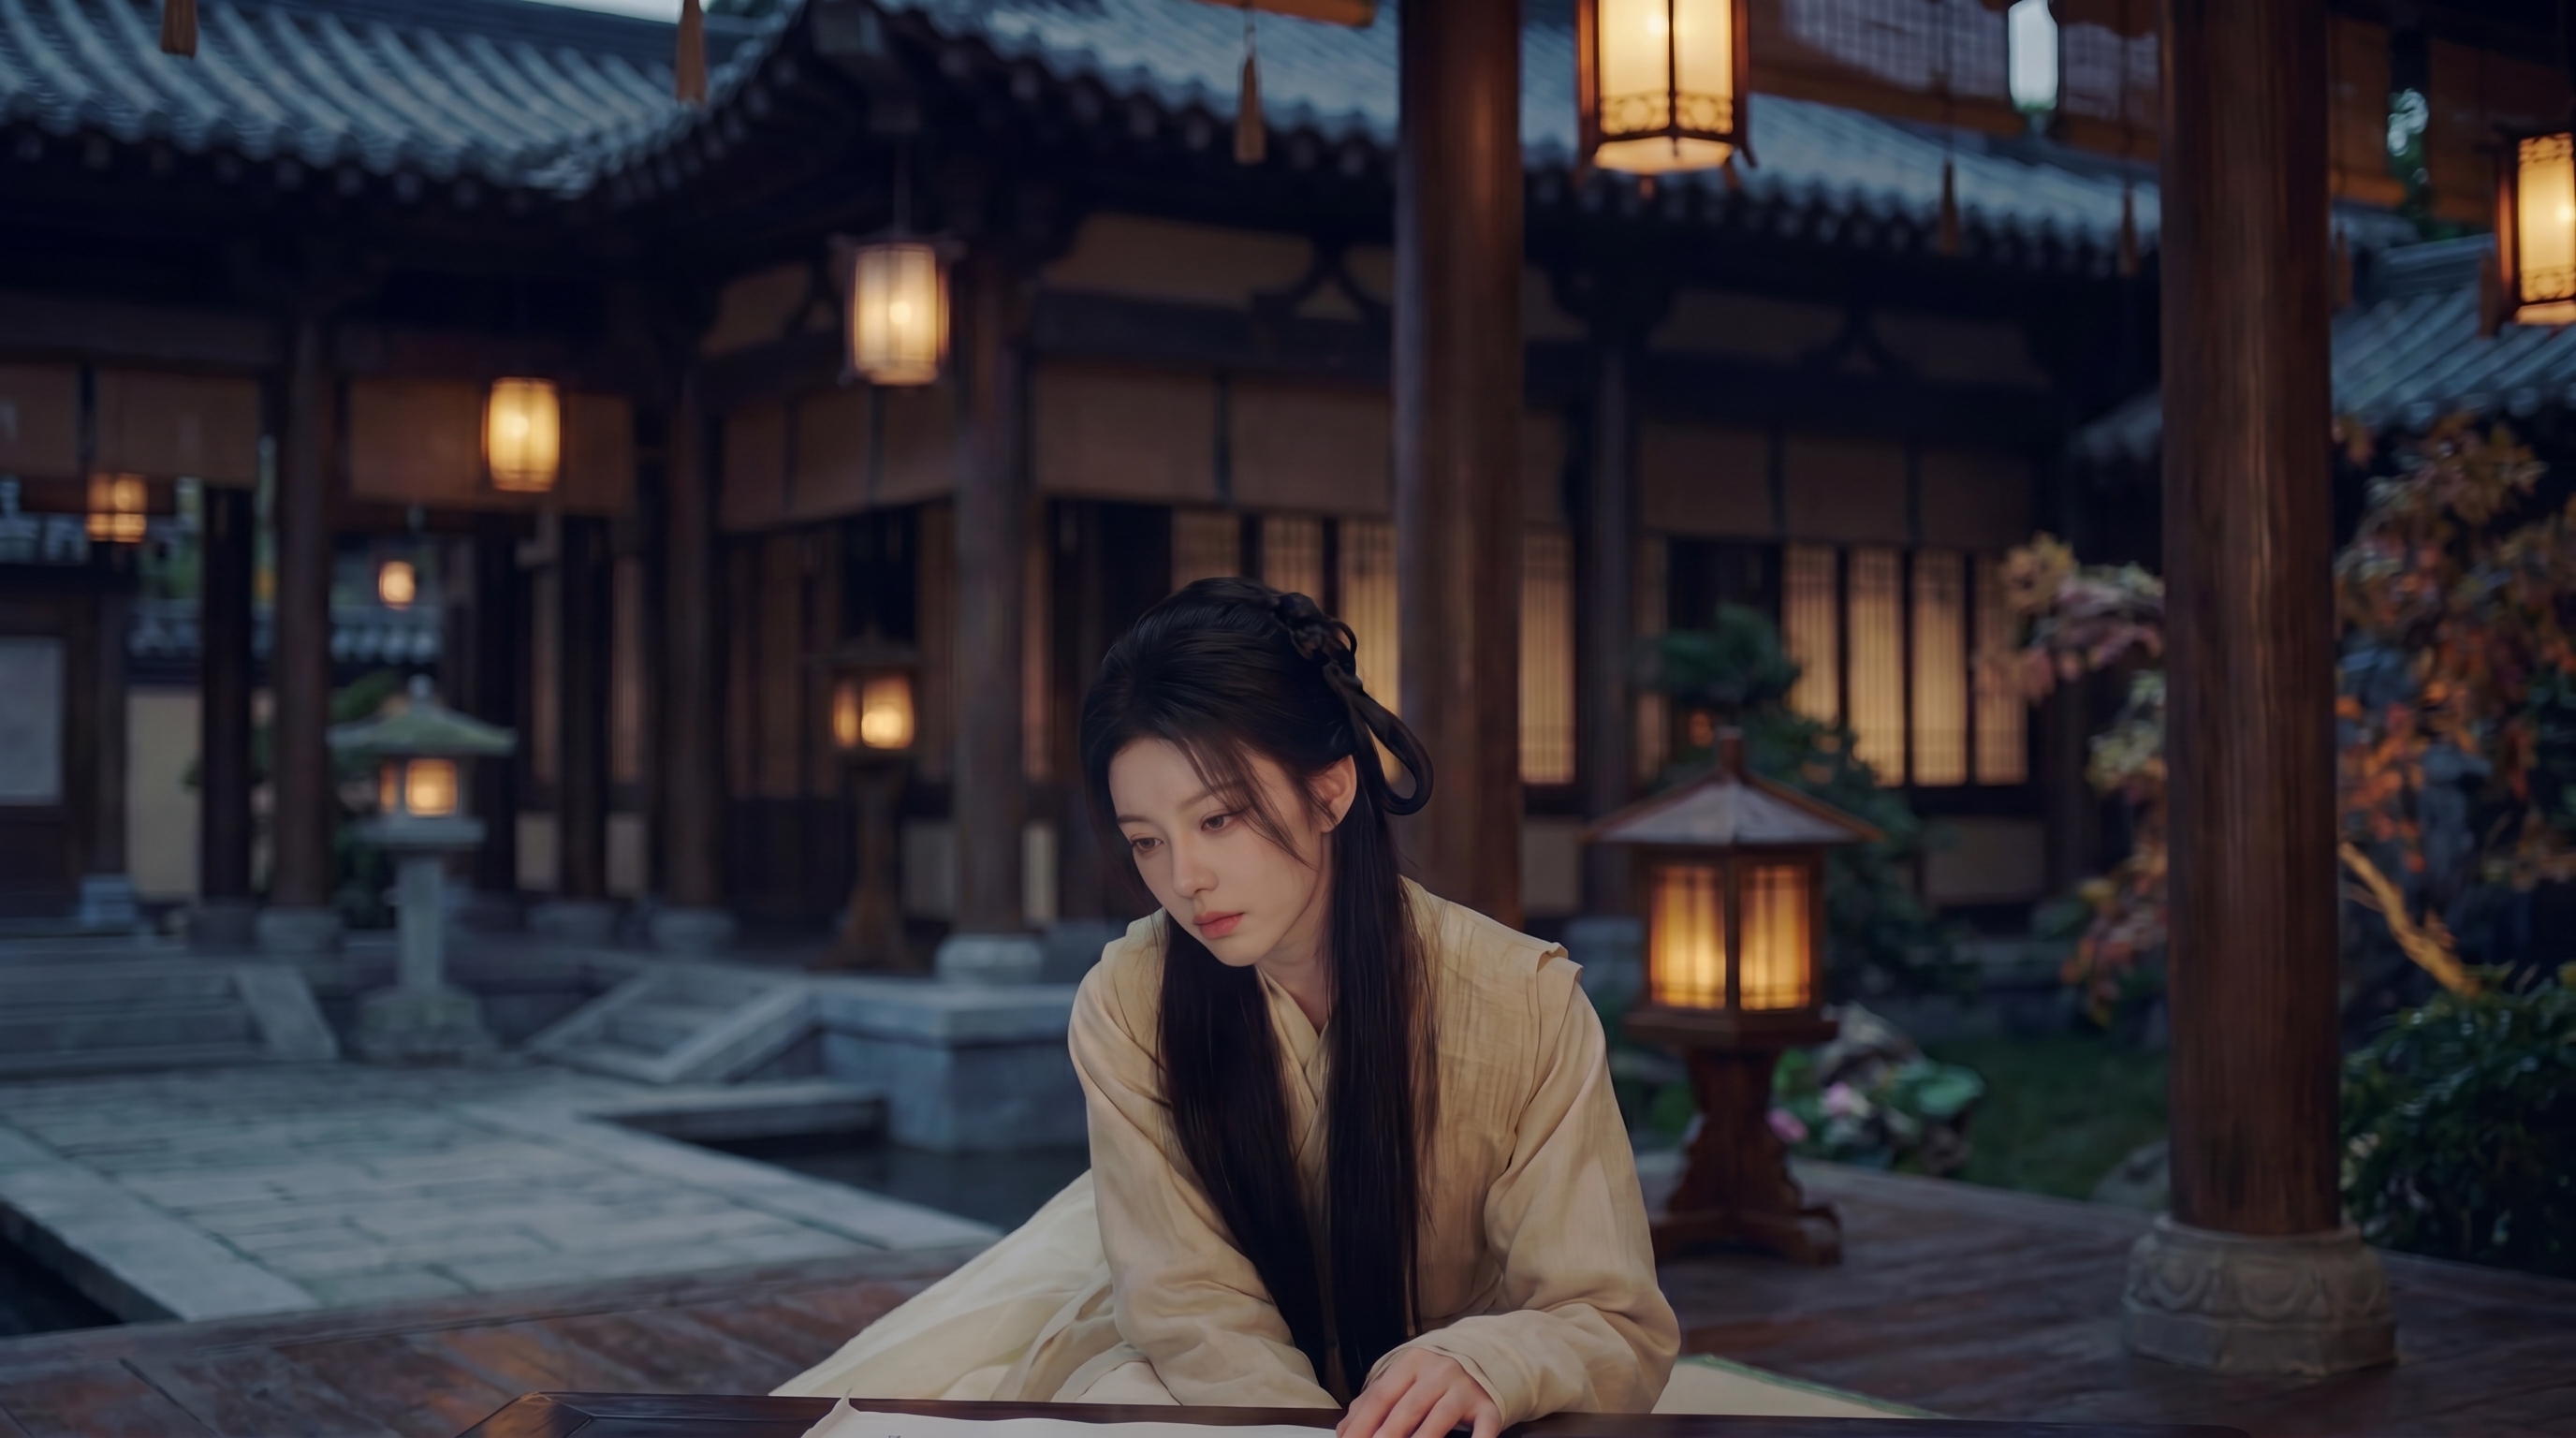
画面里是一位古风女子,夜色庭院,灯笼亮着,她独自坐在廊下案前,身体微微前倾,眼神下垂,整个人有一种安静又低落的情绪。这个画面很适合做成“人物正在出神”这一类视频。
如果只写:
古风女子坐在庭院里,低头沉思,镜头缓慢推进,古风电影感。
这段虽然有画面,但还是太空。因为它只写了结果,没有写过程。人物为什么沉思?她是刚看完什么,还是在等什么?她低头之后,有没有细微反应?这些都没有交代。
按照公式拆开,就会更清楚:
人物身份:古风女子
具体场景:夜晚庭院廊下,灯笼微亮
当前状态:独自坐在案前出神
动作原因:像是想起一件心事,情绪有些低落
连续动作:先低头发呆,手指轻轻搭在桌边,随后目光缓慢移向一侧
细微反应:眼神停顿,呼吸轻,发丝微垂,神情安静克制
镜头语言:缓慢推进,浅景深,夜色古风氛围
组合成完整提示词,可以写成:
一位古风女子独自坐在夜晚的庭院廊下,案前灯火微亮。她像是想起了一件心事,安静地低头出神,手指轻轻搭在桌边,身体微微前倾。停顿片刻后,她的目光缓慢移向一侧,神情里带着一点淡淡的失落。人物有自然眨眼和轻微呼吸,发丝轻垂,动作克制细微。镜头缓慢推进,浅景深,古风电影感,画面安静自然。
这样写的好处是,人物不是只有一个“低头”的动作,而是有完整的变化过程:
先出神,
再停顿,
再缓慢移开目光,
最后带出情绪。
这就是单人物视频提示词最重要的地方:
不要只写一个动作,要写出人物当下的状态、动作变化和细微反应。
同样一张图,
如果只写“女子低头沉思”,画面会比较空;
如果写清楚“她为什么出神、动作怎么变化、情绪怎么流动”,视频就会更自然。
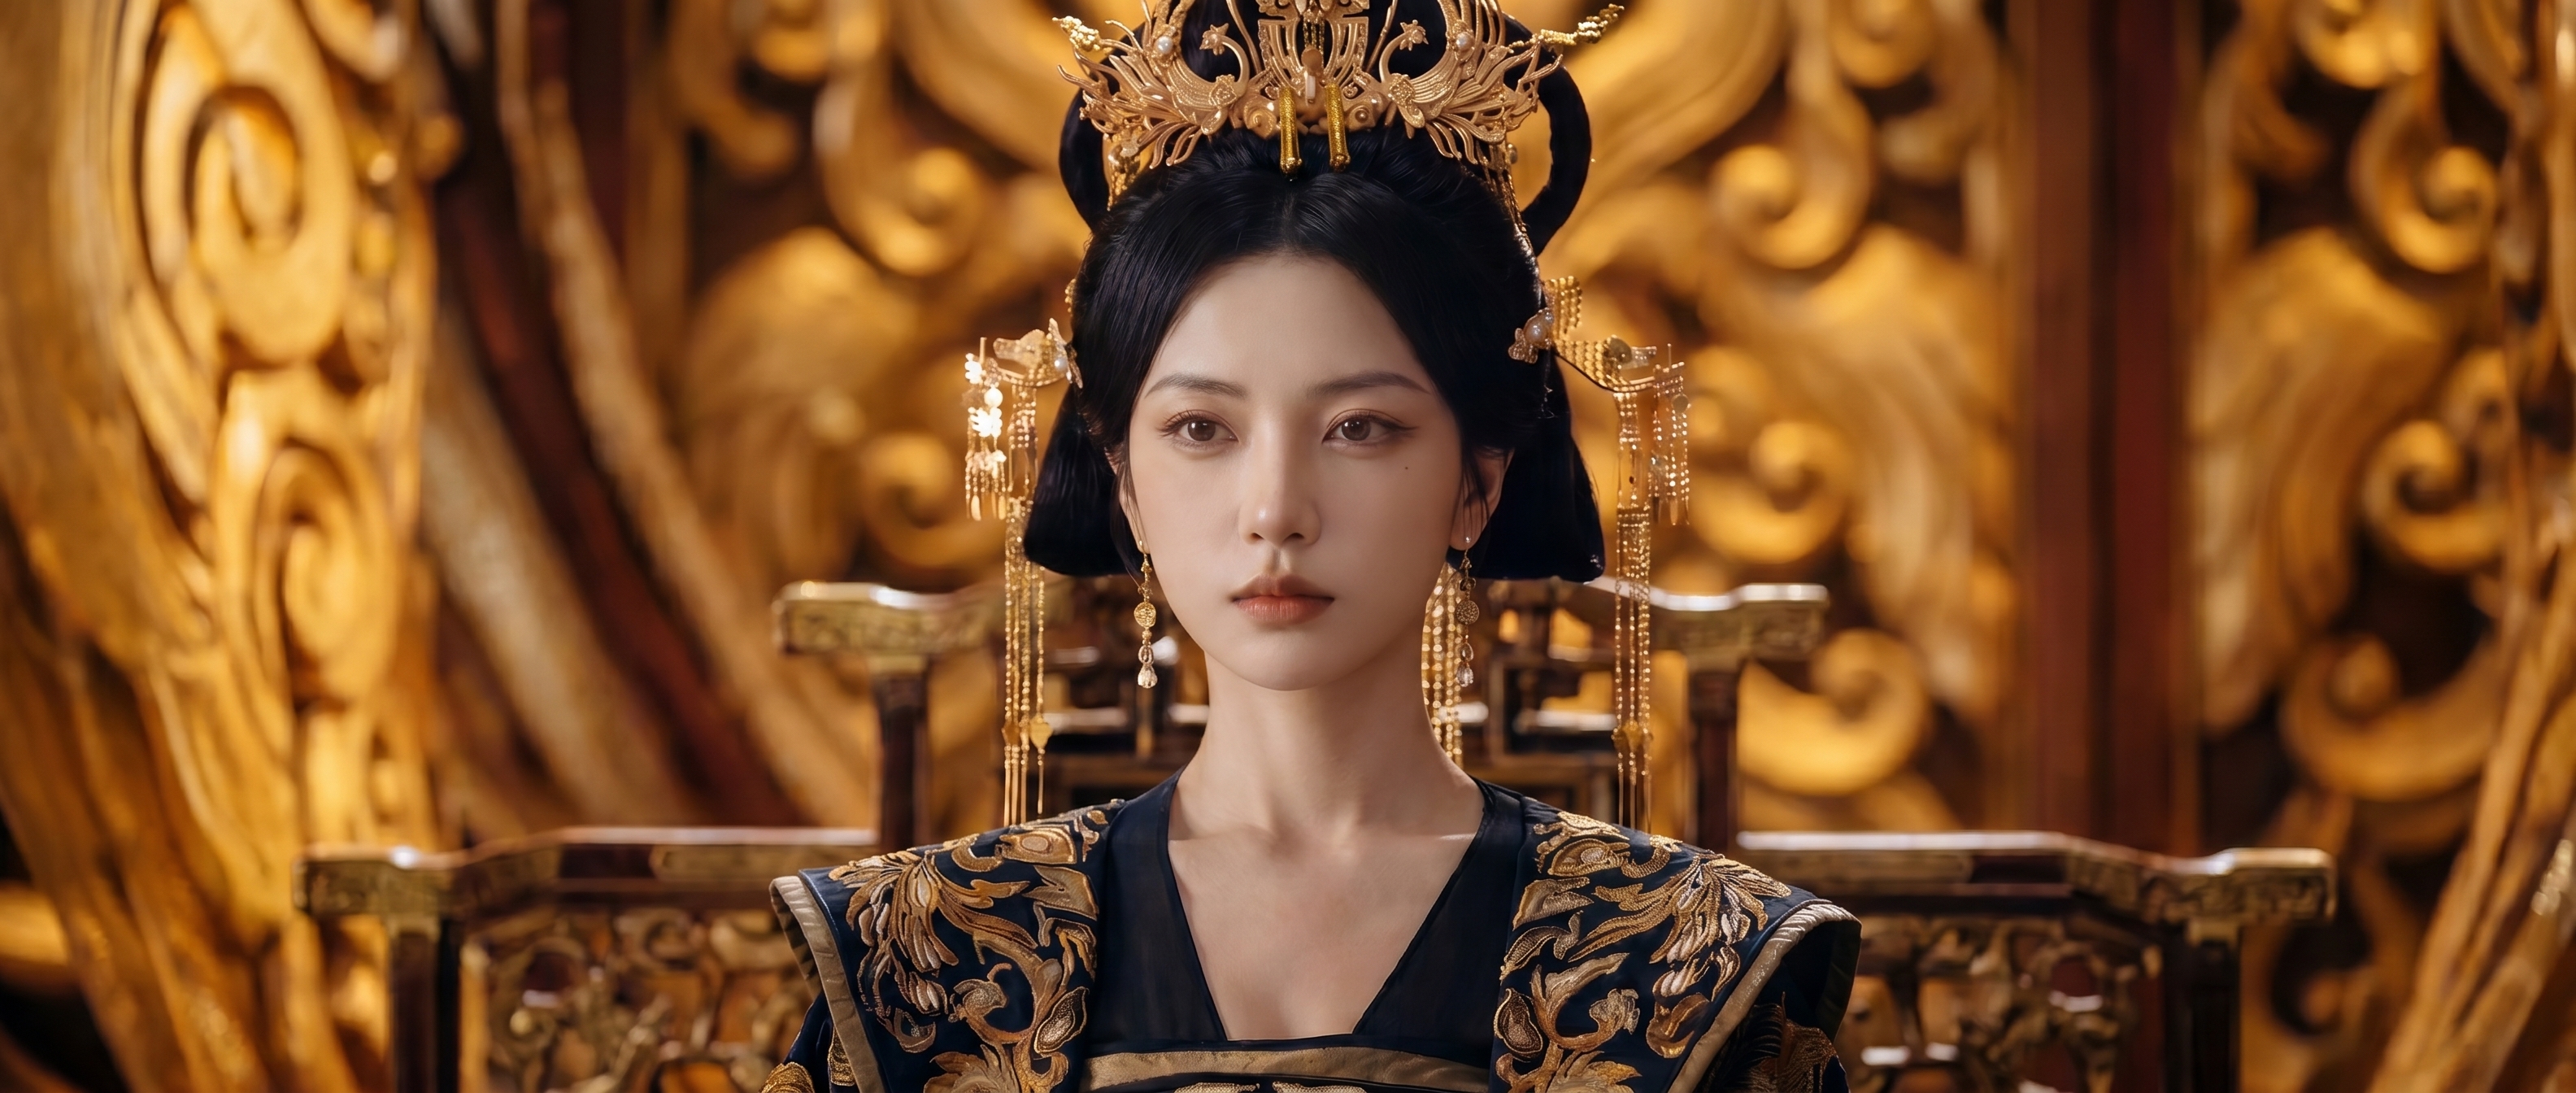
四、让人物像真人:加入微弱生命反应
这张图里的古风女子站在宫殿中,服装华丽,场景庄重,人物本身并不适合做太夸张的动作。
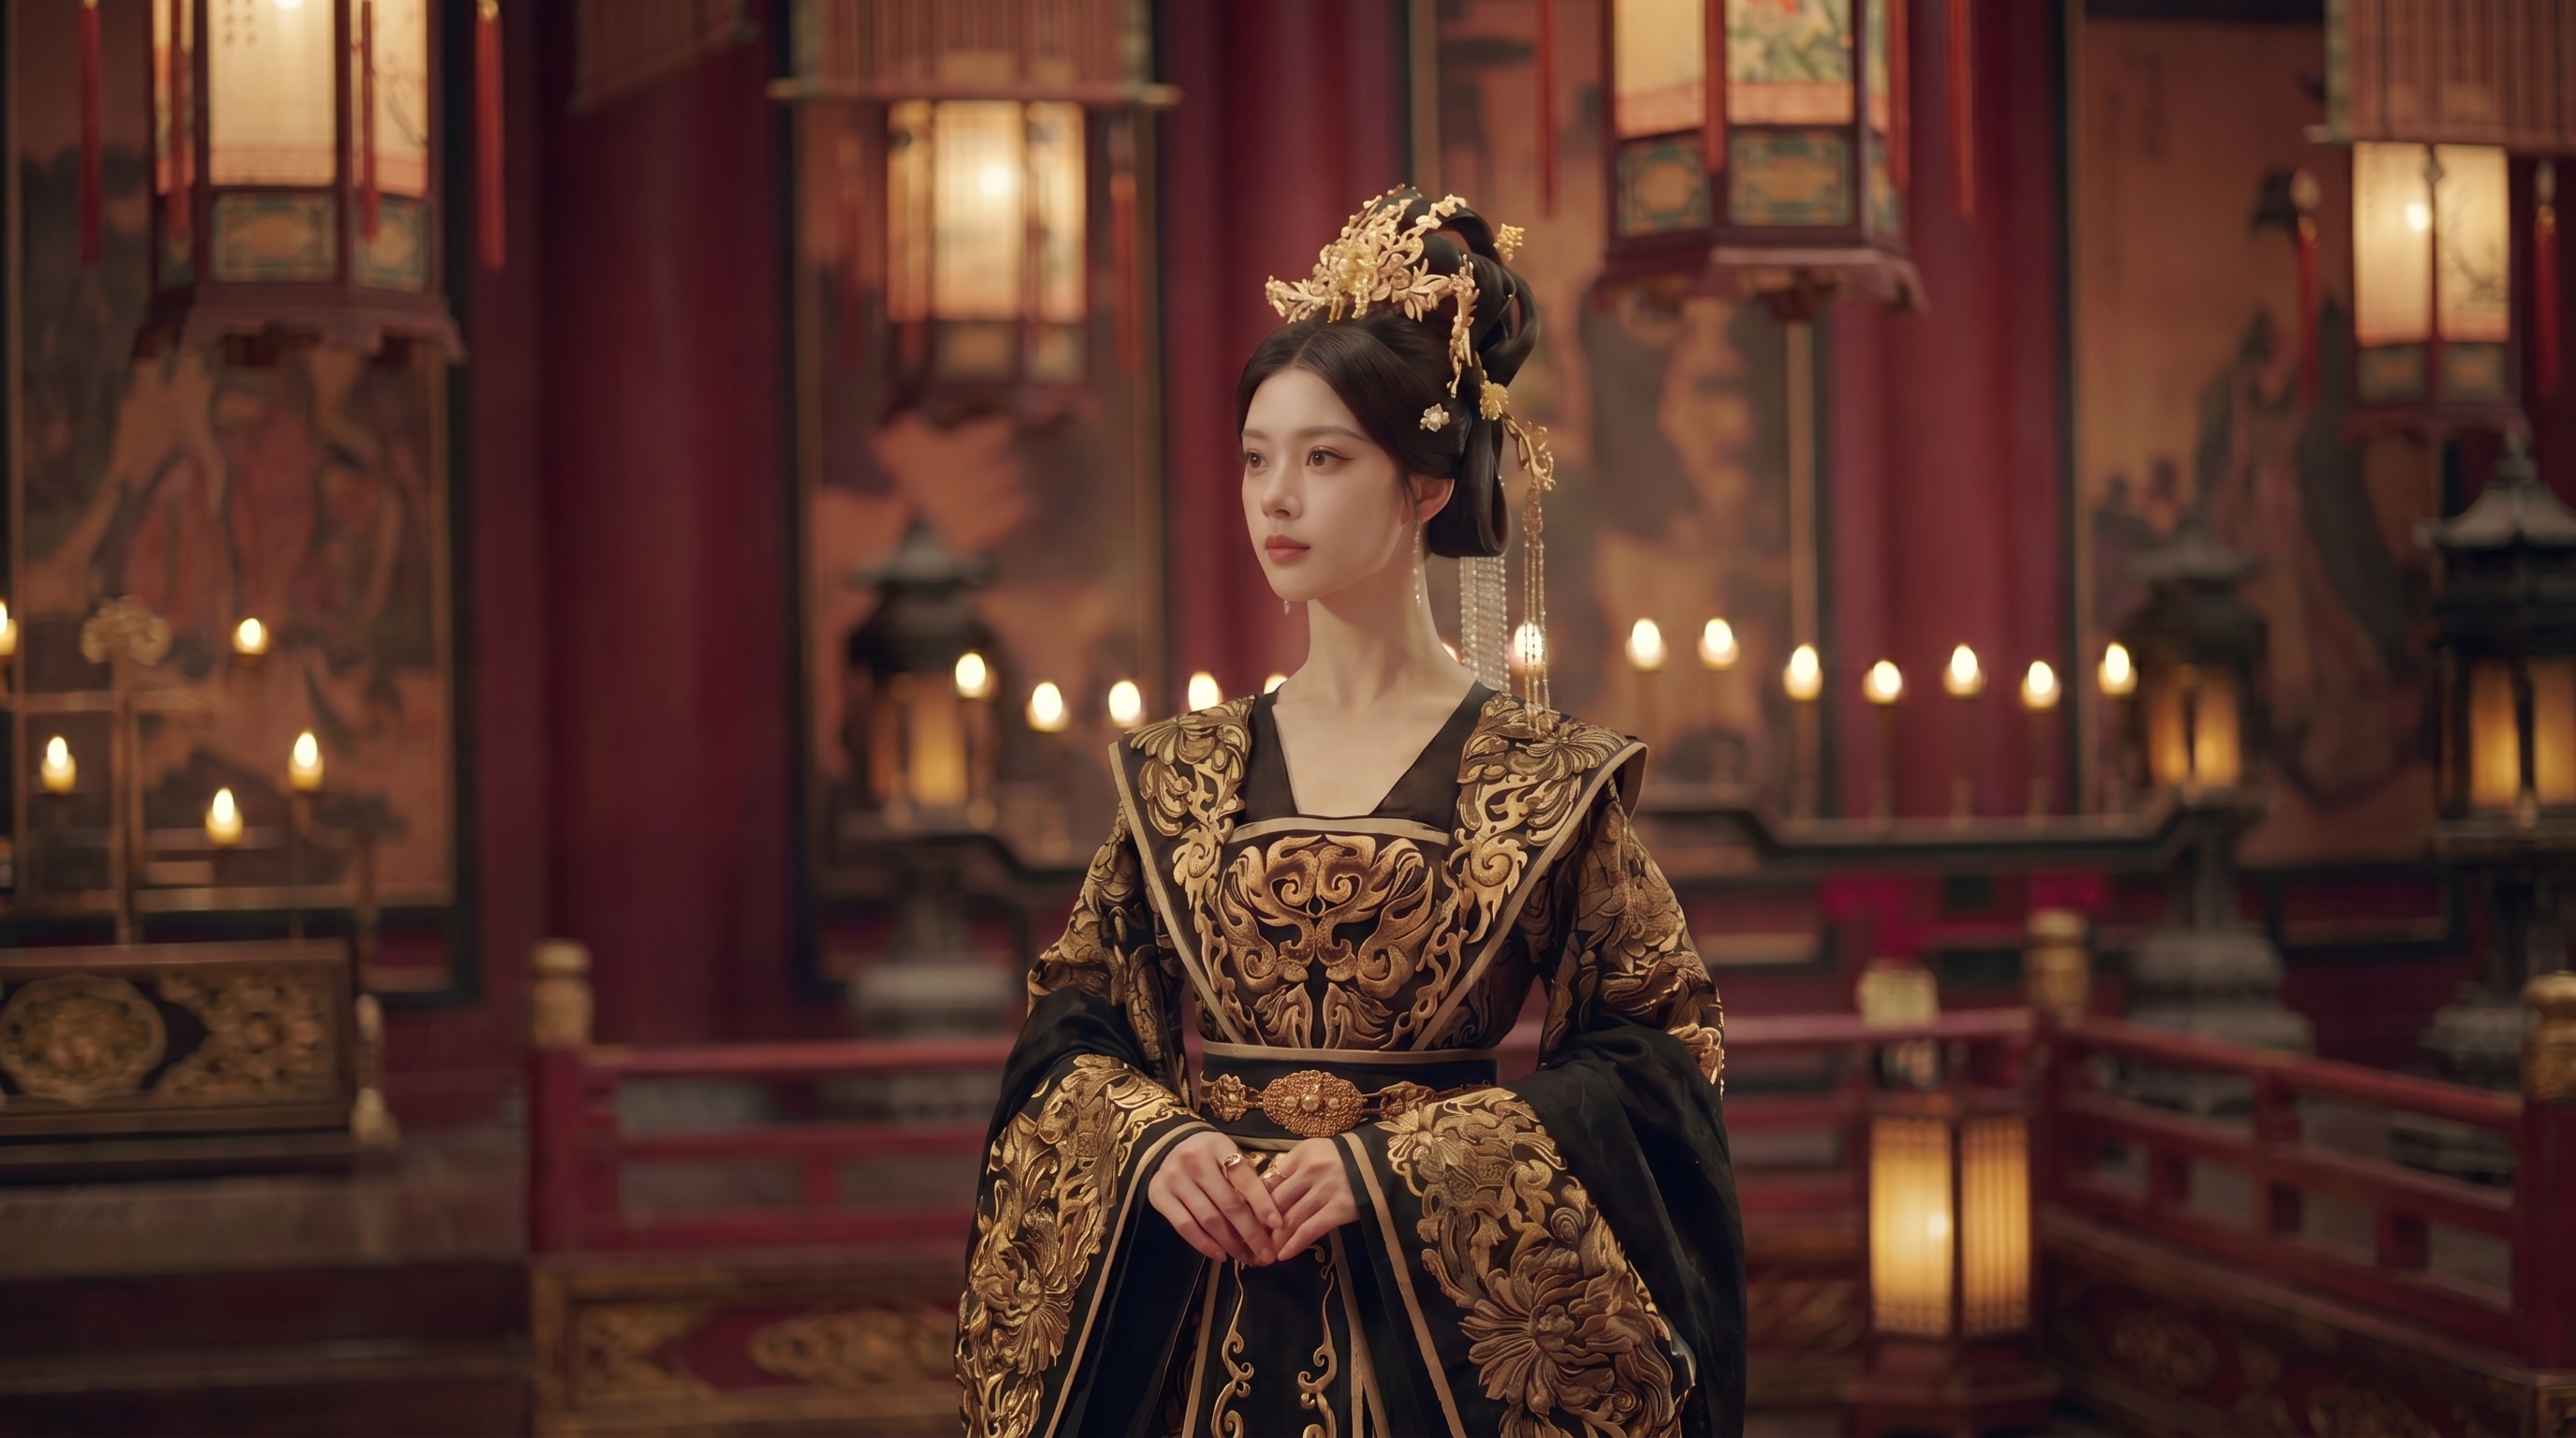
如果只写:
古风女子站在宫殿中,缓慢转头,衣袖飘动,镜头推进,古风电影感。
这段虽然有动态,但还是容易假。因为人物只是按照提示词在动,并没有真实的身体反应。
这种庄重场景里,人物不需要大动作,反而要靠很轻的生命反应来变真实。
比如:
她安静站在宫殿中,像是在等待宣召。她的目光原本看向一侧,停顿片刻后轻轻垂下,手指在袖口处微微收紧。烛光轻晃,发饰有细微摆动,衣袖随着呼吸轻轻起伏。她没有明显表演,神情克制,像是在压住心里的情绪。镜头缓慢推进,画面庄重安静,古风电影感。
这段提示词里的动作并不多,但会更像真人。
因为真实的人即使站着不动,也不会完全静止。她会有呼吸,会有眼神停顿,会有手指细微用力,也会因为情绪变化出现很轻的表情反应。
这一章要强调的是:
视频里的真实感,不一定来自大动作,而是来自小反应。
尤其是这种宫殿、朝堂、等待、对峙类画面,人物越克制,越要写细节:
眼神短暂停顿
手指轻轻收紧
呼吸带动衣袖起伏
发饰轻微晃动
嘴唇轻轻抿住
身体重心有细小变化
表情从平静变成克制的不安
这些细节不会破坏画面的庄重感,却能让人物不像雕塑。
所以写AI视频提示词时,可以在最后加一句:
人物不是完全静止,有自然眨眼、轻微呼吸、眼神短暂停顿、手指细小动作,整体动作克制自然,不夸张表演。
这样人物即使只是站在原地,也会更像一个真实处在情境里的人。
五、多人物视频:一个人行动,另一个人反应
多人物视频最容易假,是因为很多人会让每个人都同时做动作。
比如这张图,
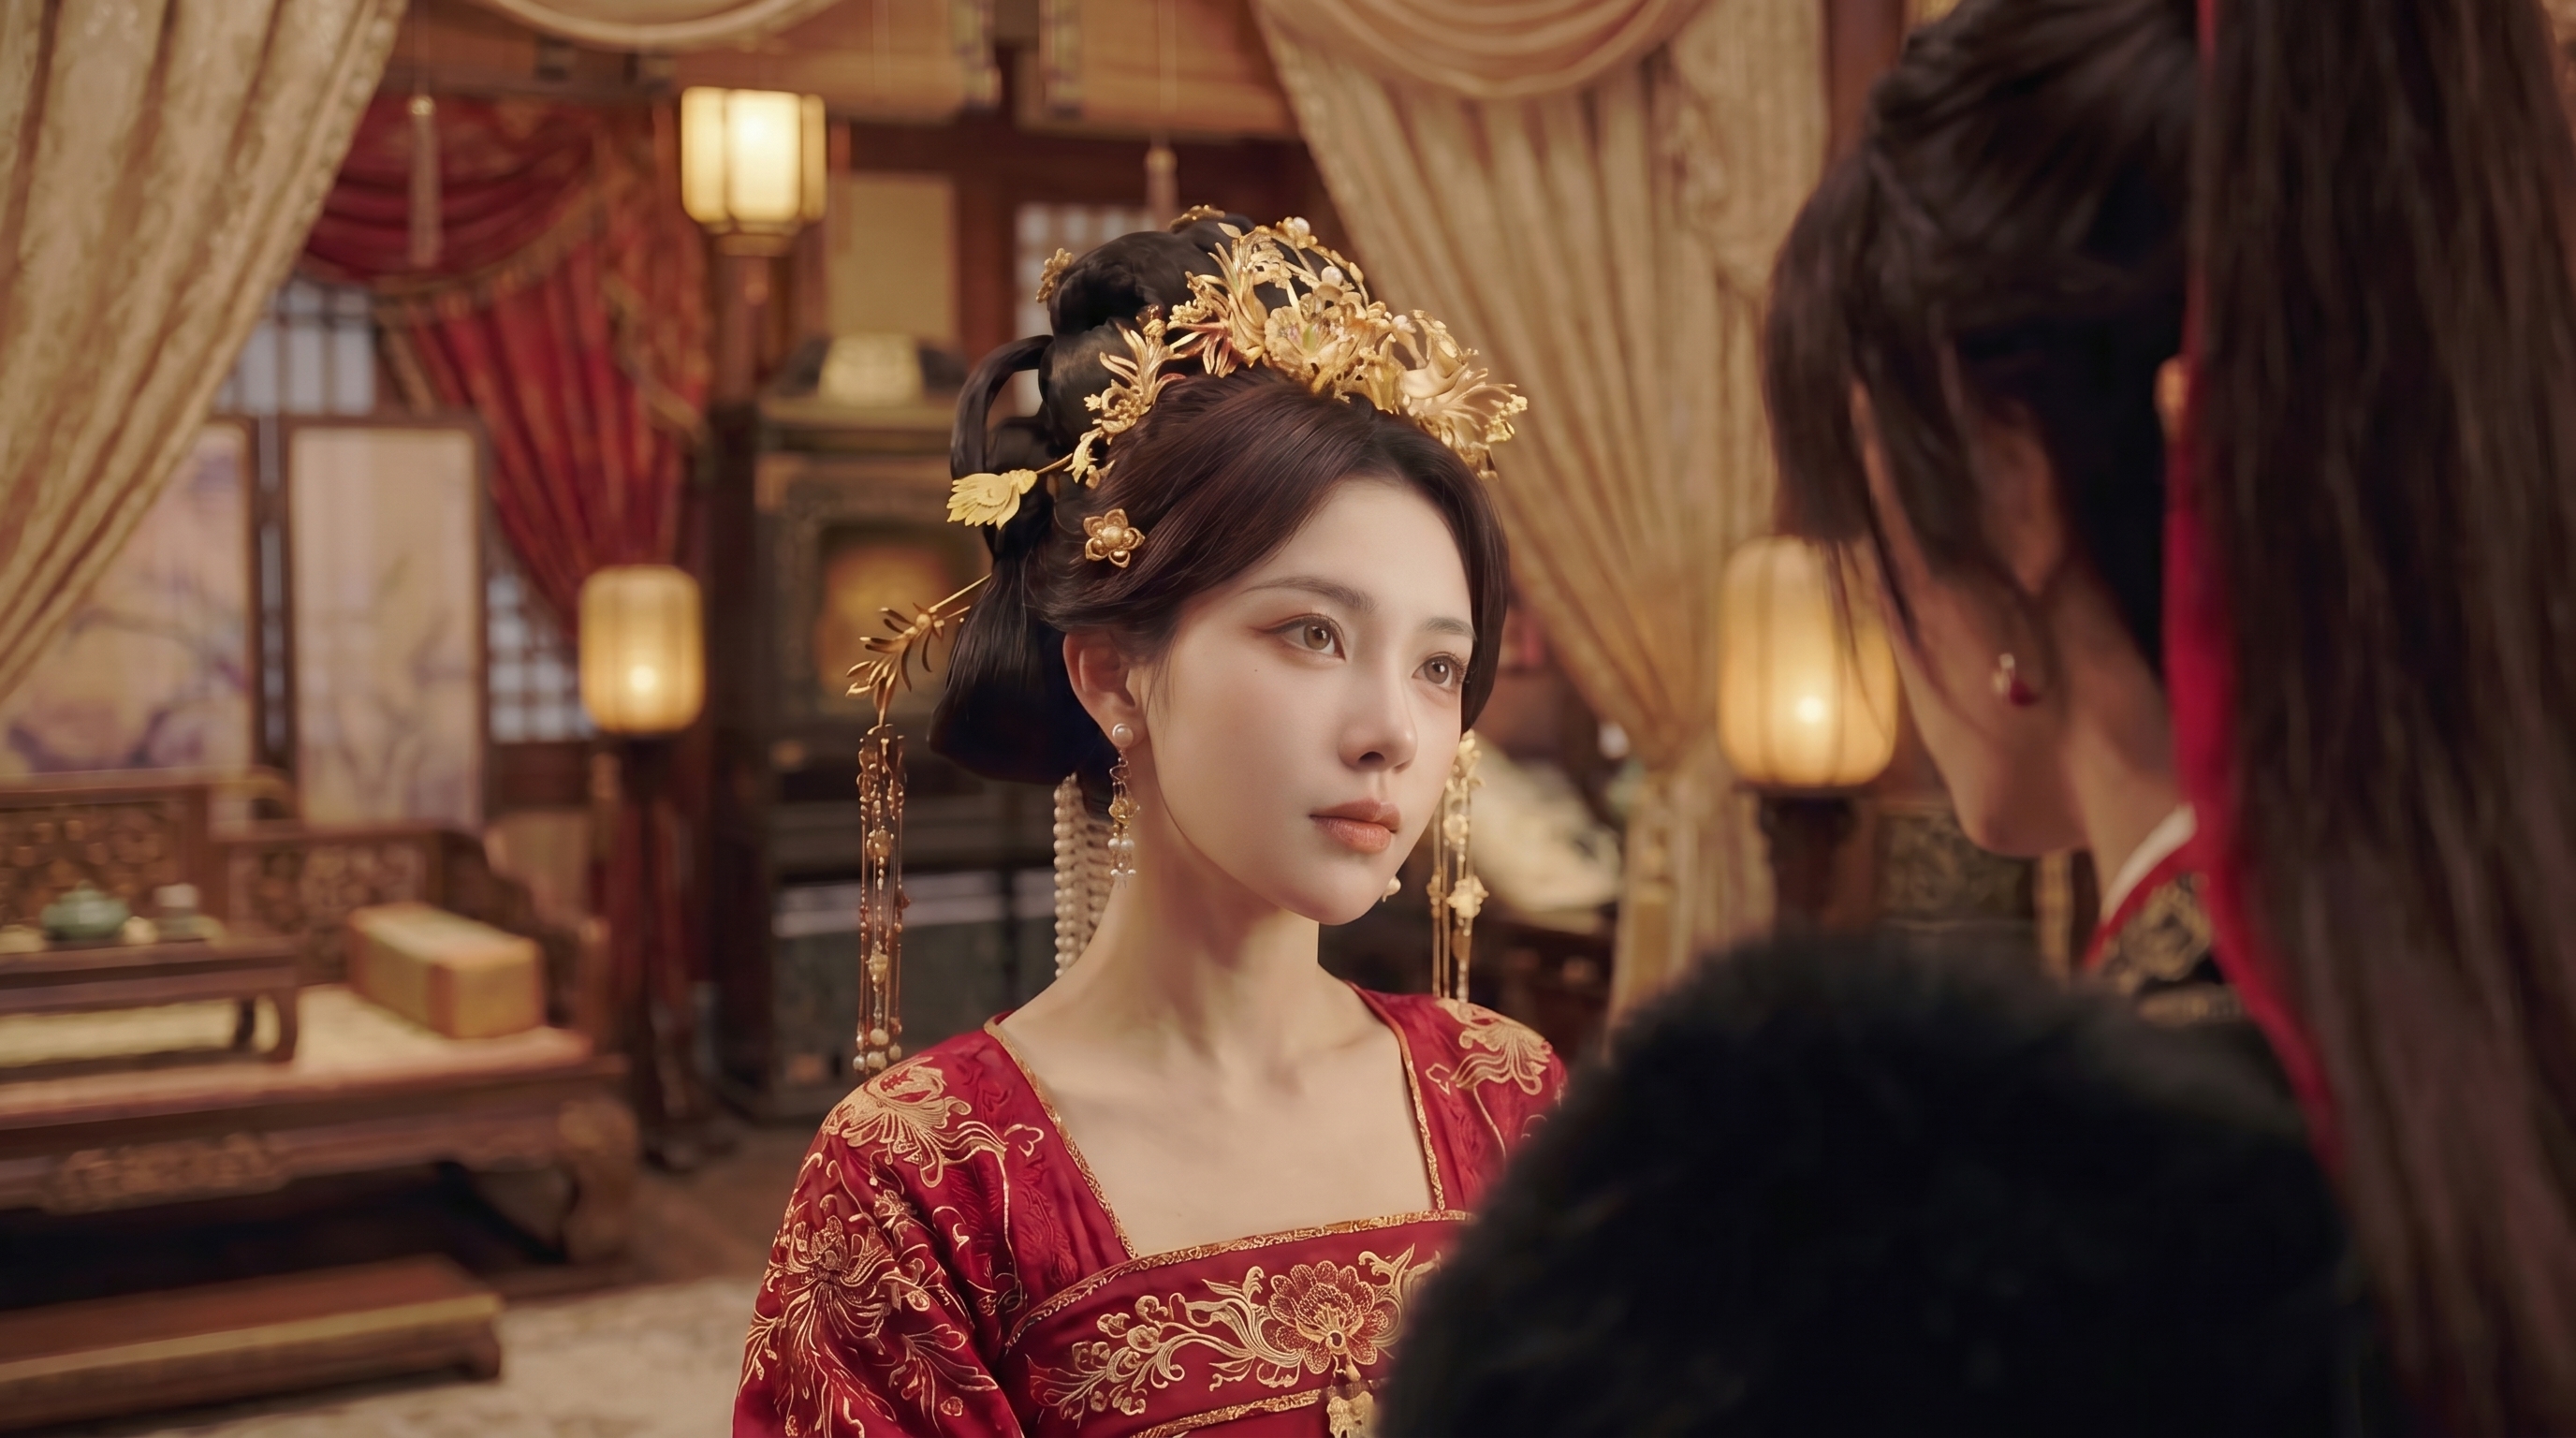
如果只写:
古风女子和男子站在房间里对视,女子缓慢抬头,男子靠近她,镜头缓慢推进,古风电影感。
这段虽然有互动,但还是比较表面。因为两个人为什么靠近?为什么对视?女子是紧张、犹豫,还是在压住情绪?如果这些没有写清楚,画面就容易像摆拍。
多人物视频的关键,不是动作越多越好,而是要有一方行动,另一方反应。
可以改成:
华丽的古风房间里,女子穿着红色华服,站在男子面前。男子低声说了一句话后,身体微微靠近她。女子没有立刻回答,只是抬眼看着他,眼神短暂停顿,嘴唇轻轻抿住,像是在压住情绪。她的发饰随着呼吸轻轻晃动,男子停在她面前,没有继续逼近。镜头缓慢推进,浅景深,画面安静紧张,古风电影感。
这样写,人物之间就有了关系:
男子先靠近、说话,
女子听到后停顿、抬眼、克制反应,
男子再停住,形成一种安静的拉扯感。
这比“两个人对视”更像真实视频。
多人物提示词可以记住一句话:
不要让所有人都表演,要让一个人触发事件,另一个人产生反应。
比如:
一个人靠近,另一个人后退半步。
一个人说话,另一个人沉默片刻。
一个人伸手,另一个人眼神躲开。
一个人停住,另一个人察觉到情绪变化。
一个人看向对方,另一个人先避开视线,再慢慢看回来。
这一类互动,会让人物之间产生真实关系,而不是各自站在那里摆姿势。
所以写多人物视频时,不要只写“他们在做什么”,还要写清楚:
谁先行动,谁在反应,反应有多轻,气氛发生了什么变化。
结尾
视频生成执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课不是先追求炫技成片,而是围绕「让AI人物更像真人的关键,不是脸,而是“有事可做”」先把主体、动作、镜头和节奏稳住。
按原文节奏走最稳:先吃透「AI视频人物为什么容易假?」,再把「视频提示词的核心:动作要有行为动机」定住,接着处理「单人物视频提示词公式」;最后用「让人物像真人:加入微弱生命反应」收口。
- 先把「AI视频人物为什么容易假?」里的主体和动作定死。
- 把「视频提示词的核心:动作要有行为动机」这一点先定准,再往下走。
- 把「单人物视频提示词公式」整理成可复制版本,后面直接复用。
- 先把「让人物像真人:加入微弱生命反应」里的主体和动作定死。
- 这一段重点看镜头和节奏,别急着炫技。
- 做完「结尾」后,先查连贯性和穿帮。
不要一上来就生成最终片;先拆镜头、定主体和运动,再逐段生成,否则容易跳轴、穿帮、节奏混乱。
检查主体是否稳定;镜头运动是否明确;前后画面是否连贯;节奏是否服务主题;是否有明显变形或穿帮。
请围绕「让AI人物更像真人的关键,不是脸,而是“有事可做”」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:核心创意、分镜表、每个镜头的画面描述、视频生成提示词、剪辑顺序和成片自检清单。要求主体稳定、动作明确、镜头连贯。