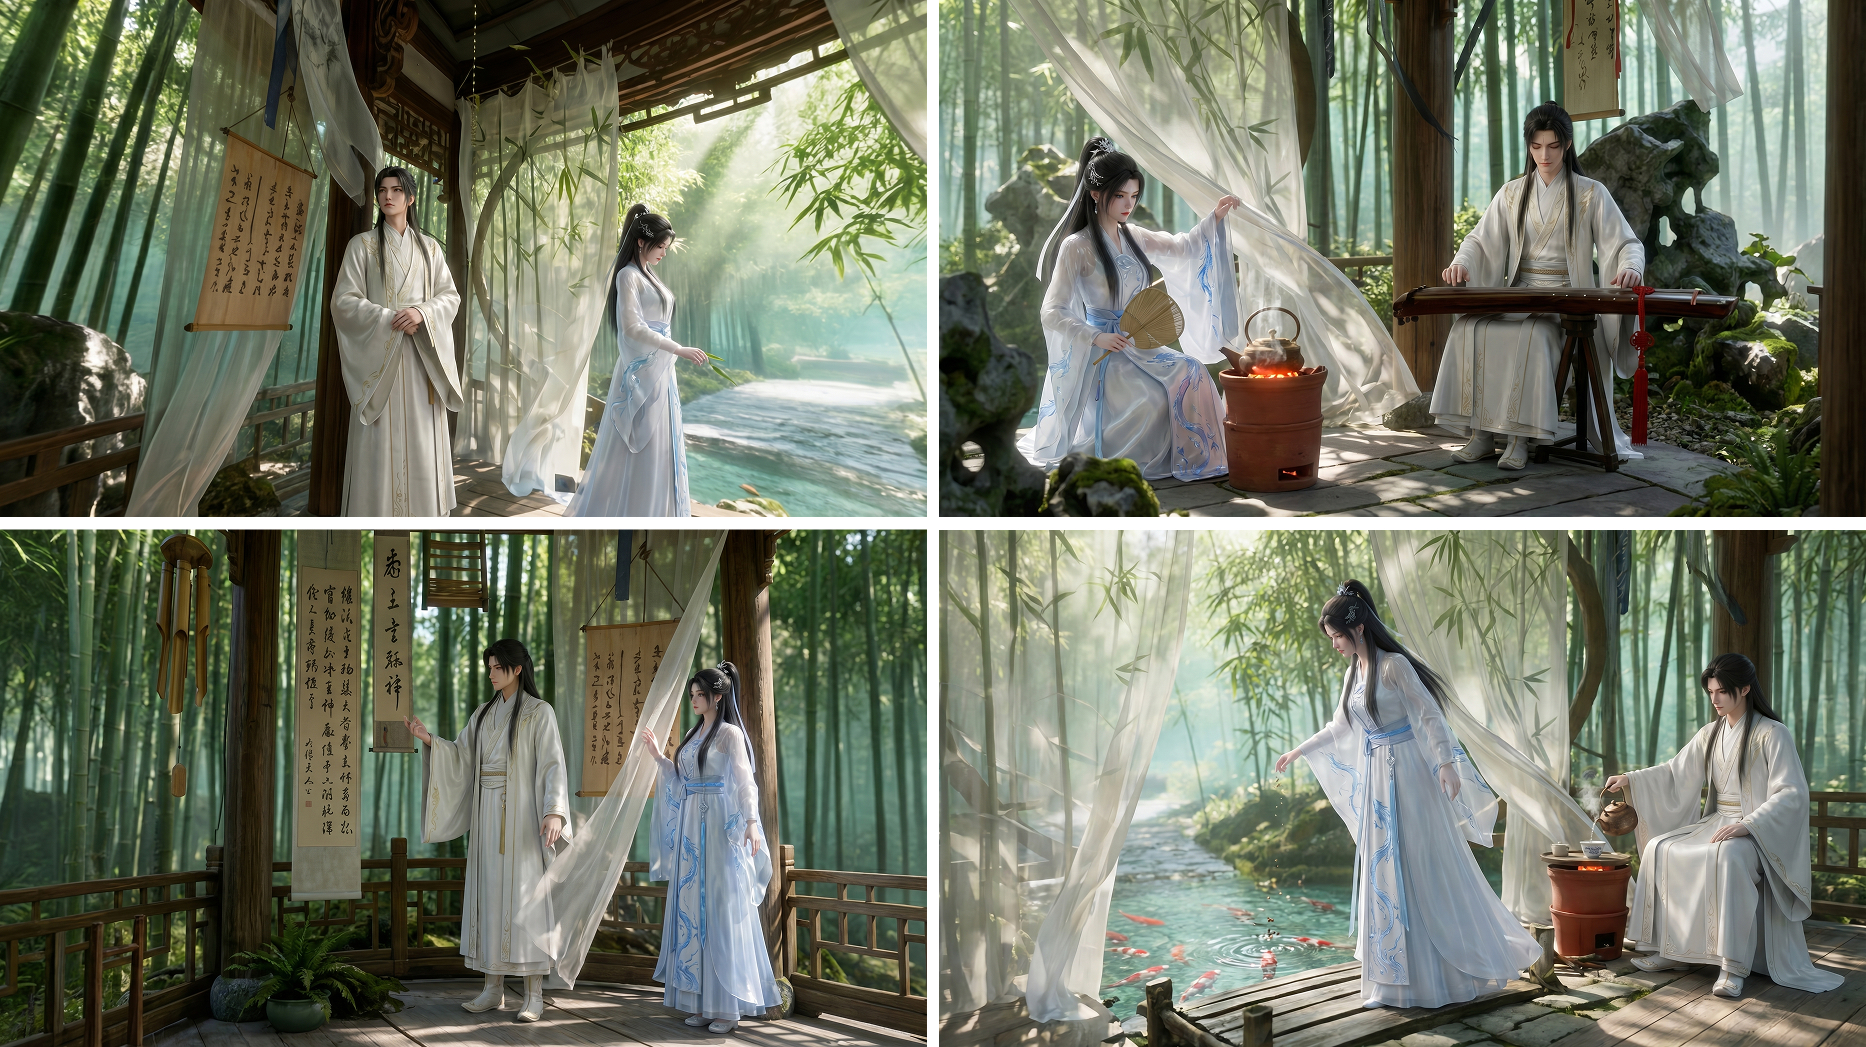
一起来看一下成品:
准备工具
nano banana 2 (https://app.tapnow.ai)tapnow中的nano banana2可以通过提示词自定义画面比例,我们制作全景图必须要2:1的图片
Gemini /或者豆包 https://gemini.google.com/app
Pinterest/小红书 https://www.pinterest.com
步骤一:准备统一的基础素材
要保证最终画面的一致性,前期的素材准备非常重要。
角色准备:提前通过我之前的3D国漫人物工作流,制作出2个风格统一的3D国漫角色。
课程链接如下:
【3D漫剧】告别“开盲盒”!AI 3D漫剧角色极速资产化工作流
环境参考:前往Pinterest、小红书等平台寻找一张理想的环境素材图(或直接用AI生成一张)。这张图将是我们搭建“固定虚拟影棚”的基石。
依据你的风格需搜寻需要的场景
例如我这边需要的是修仙场景,那么则搜索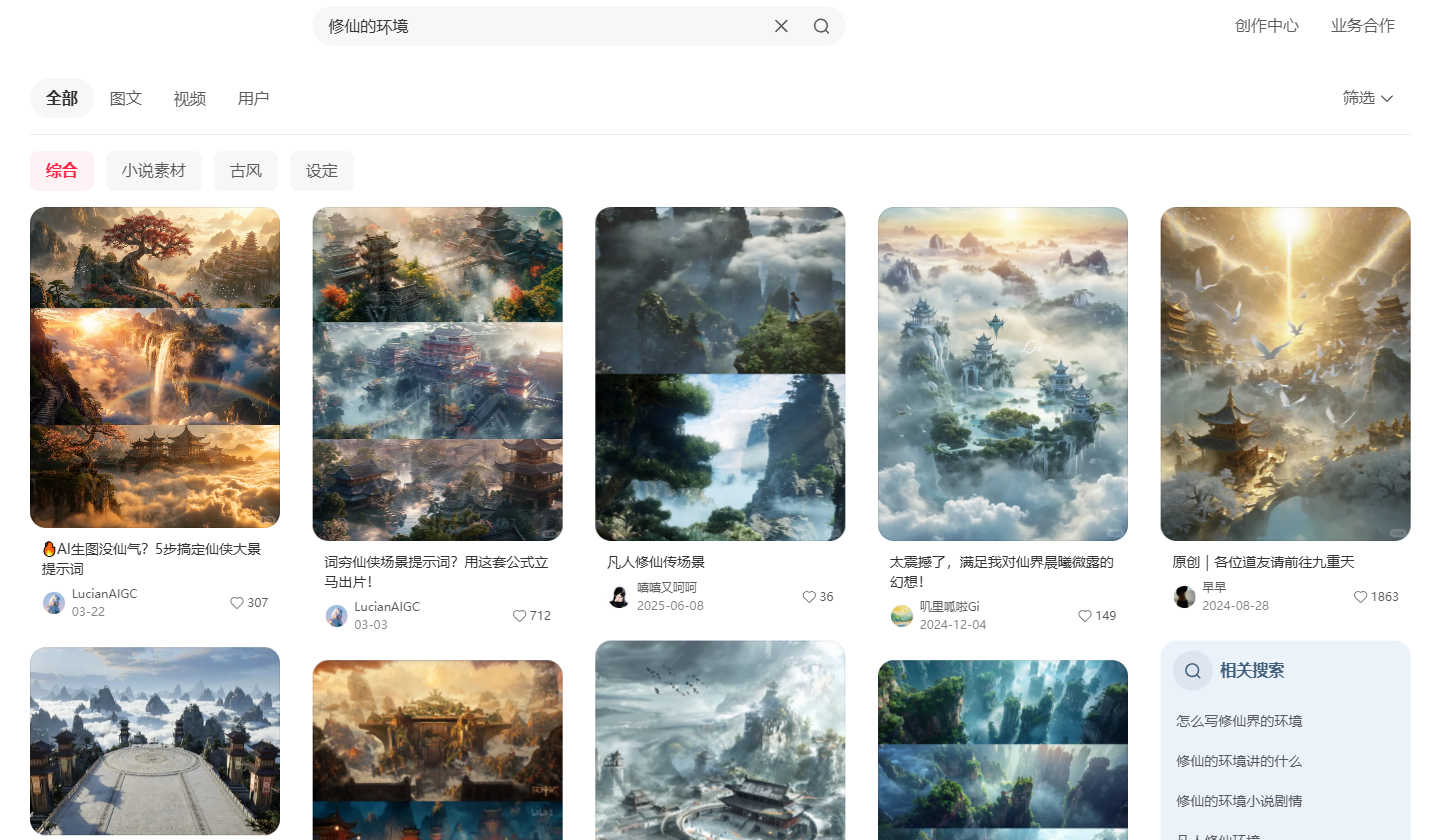
找一张自己所需的场景。我这边找了这一张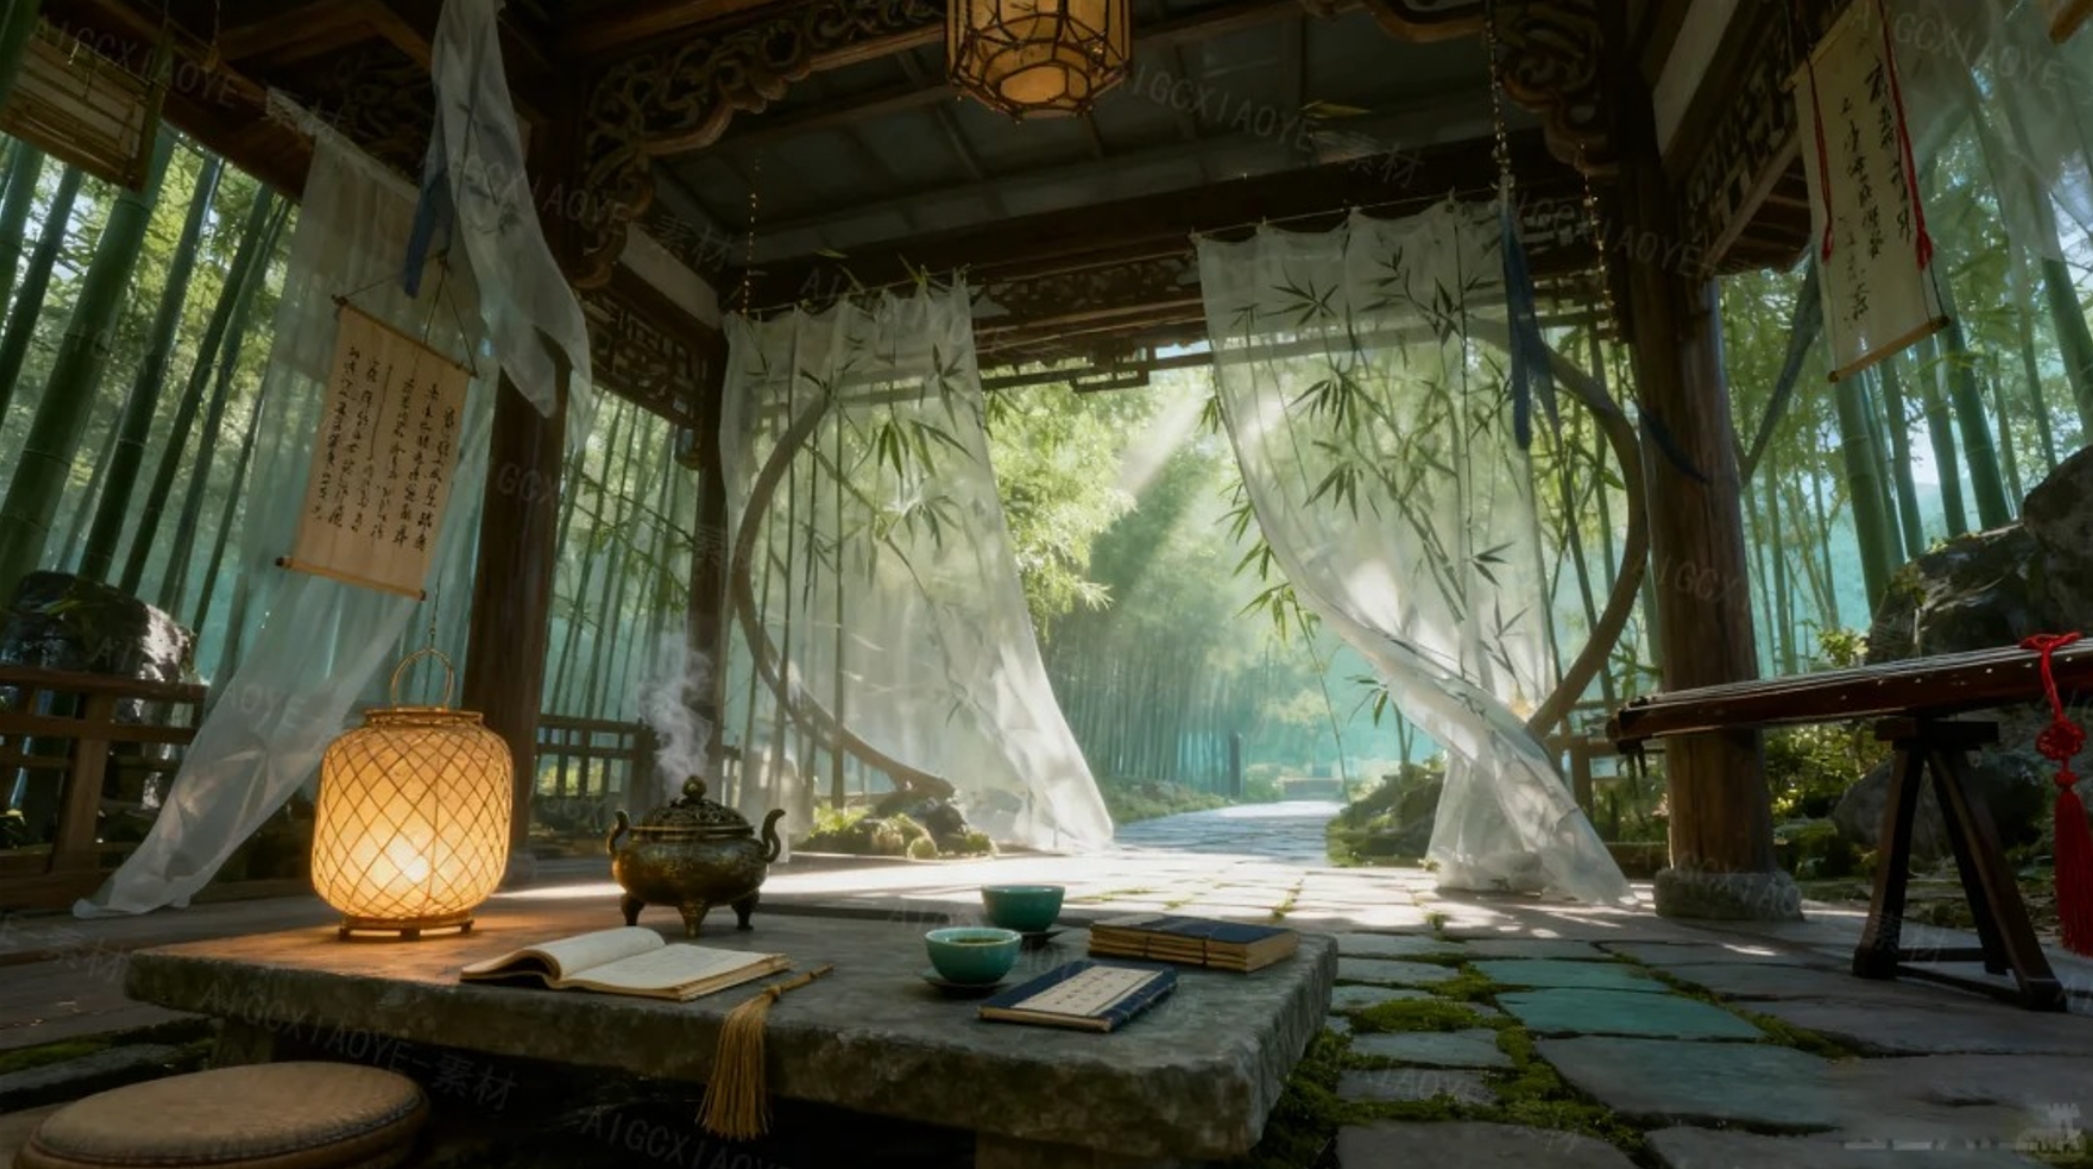
步骤二:利用大模型反推全景提示词
为了让场景不仅局限于一个角度,我们需要将单张参考图扩展为完整的360度空间。
操作方法:将环境素材图发给大语言模型(如Gemini或豆包),并输入以下指令:
“帮我想一下这个场景全景图的AI提示词,也要发散想象,想一想图片外不包含的画面。我要用于720全景图展示,并保证3d国漫的风格,不要生成图片,只要中文提示词。”
核心目的:让AI补全参考图原本没有的画面(如背后的风景、头顶的屋檐)。补全后的空间越完整,后期截图取景时的破绽就越少。
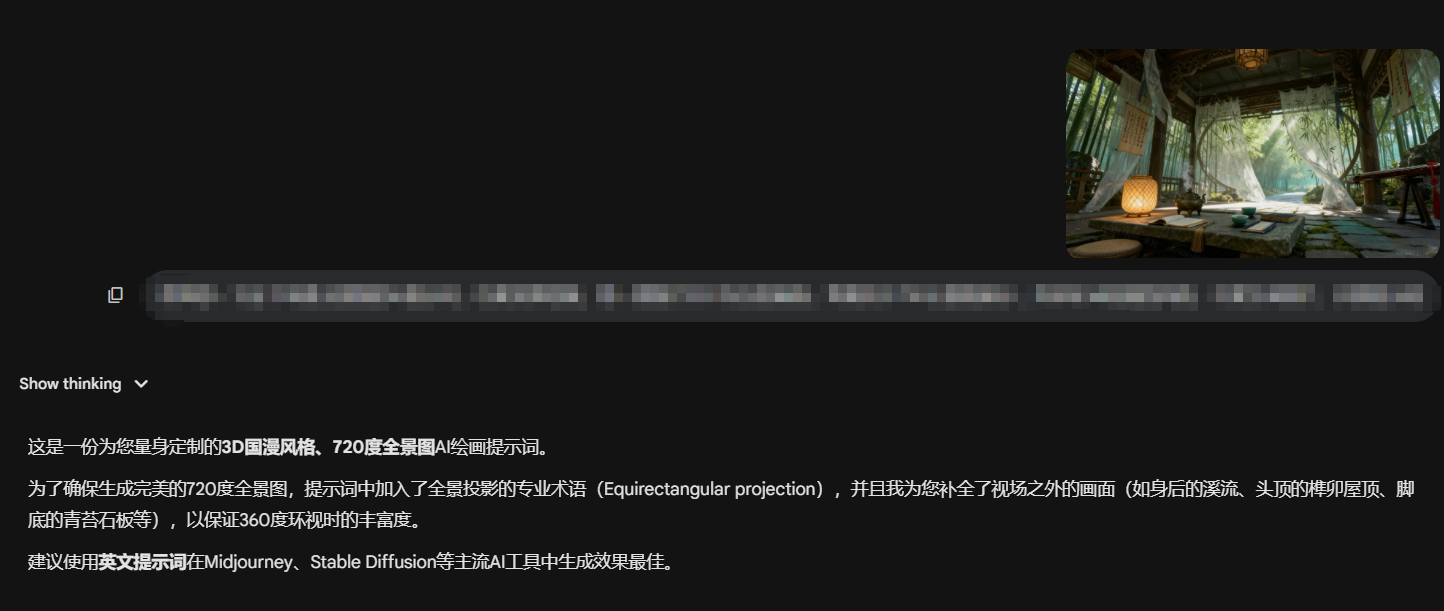
我得到了这一段提示词:
等距柱状投影,360度全景图,3D国漫风格,高质量3D动画CGI,虚幻引擎5渲染,大师级作品,极致的细节。一座隐藏在翠绿茂密竹林深处的中国古代木制凉亭。正前方是一张古朴的粗糙长方形青石茶几,一盏散发着温暖黄光的竹编灯笼,一个升腾着袅袅青烟的青铜香炉,翻开的线装古籍,两只青瓷茶盏。半透明的白色丝绸轻纱帷幔在微风中轻轻飘舞。右侧是一把放在木架上的中国传统古琴,琴上垂着红色的流苏剑穗,旁边是精美的太湖石假山。左侧是随风摇曳的书法字画卷轴,悬挂着竹制风铃。正后方是一座跨过清澈浅溪的小木桥,溪水里有几条游动的红锦鲤,一条蜿蜒的石板路通向薄雾缭绕的竹林外,还有一个古色古香的红泥煮茶小火炉。头顶是错综复杂的古代木制传统榫卯结构屋顶横梁,悬挂着精致的六角宫灯;脚底是长满青苔的石板铺地,放置着几个圆形的草编打坐蒲团。电影级光影,丁达尔效应,耶稣光穿透密集的竹叶,宁静,禅意,薄雾,空灵,仙侠修真氛围,色彩鲜艳丰富,景深。画面比例2:1。
步骤三:生成全方位场景底图
1.打开支持图生图和文本生成的AI图像工具(Nano Banana 2)。
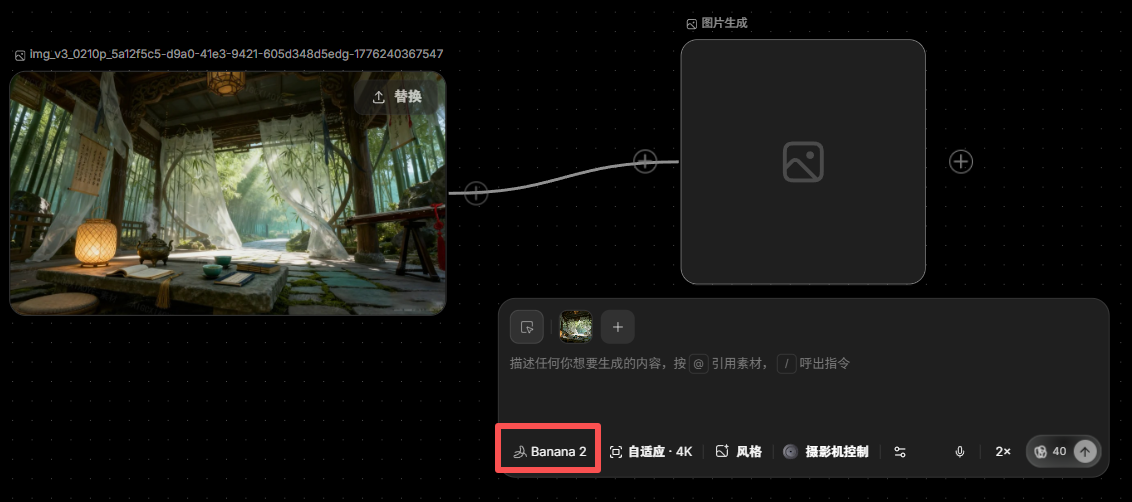
选择Nano Banana 2,自适应4k
2.将步骤一的环境素材作为参考图喂给模型,将步骤二得到的全景提示词输入进去进行生成。
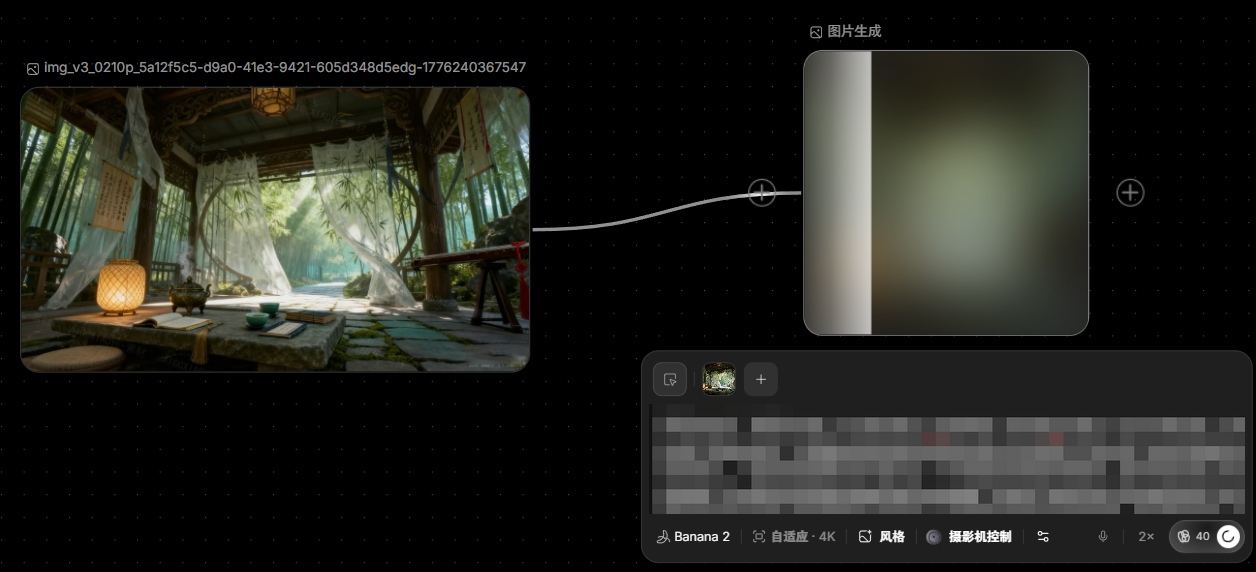
3.此时,你将得到一张视野涵盖360度的初版全景场景图。这个场景的整体氛围已经被彻底锁定。
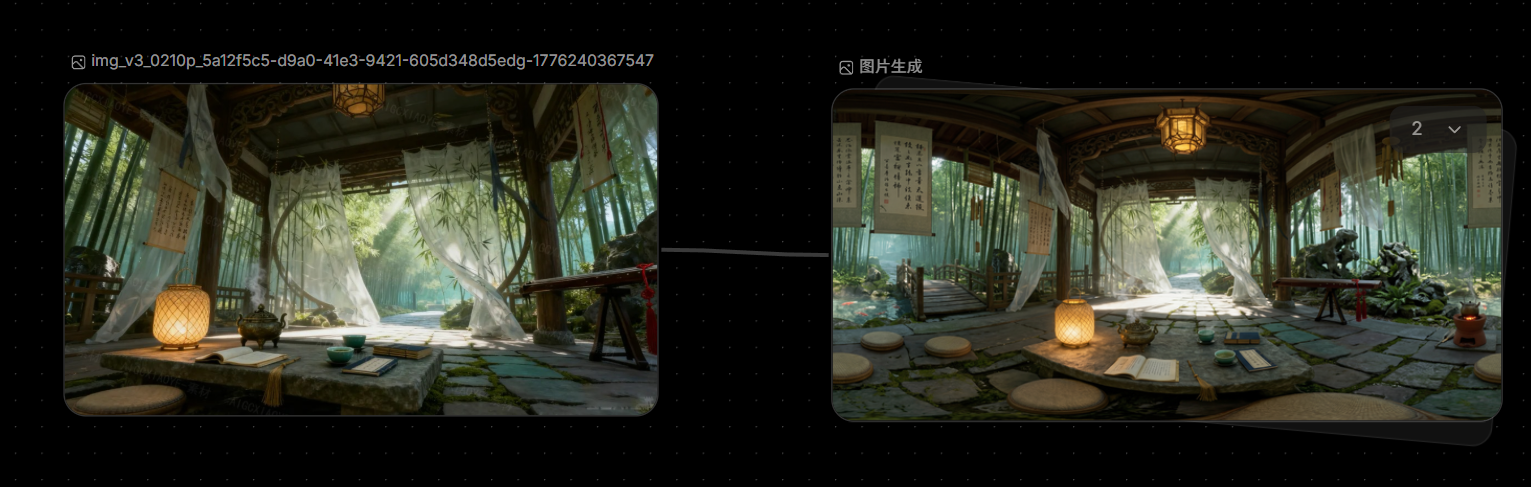
步骤四:全景取景
这是整个工作流中最关键的一步!
合成全景:打开网页中的“全景合成工具” (我这里给了链接),将生成的图片拖入。
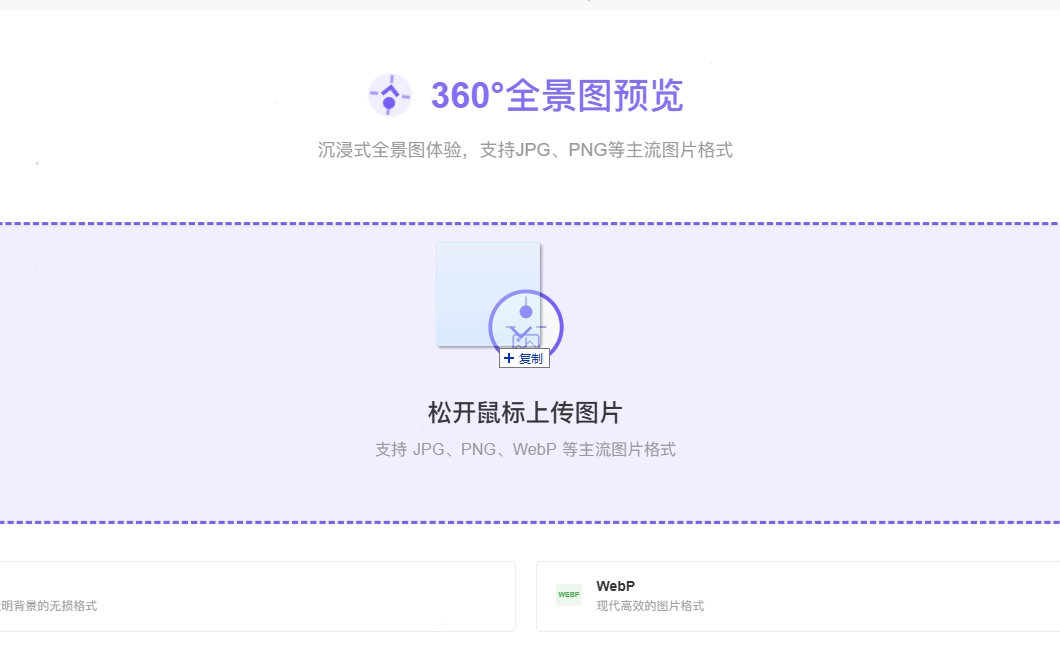
虚拟取景:此时,图片被还原成了一个真实的3D环绕空间。你可以随意拖动鼠标旋转视角。因为整个环境是固定在一张全景图上的,所以无论你怎么转,建筑结构、摆设位置、光线方向都拥有绝对的物理一致性。
截图:找到适合放置角色的完美视角,直接截图保存。你可以截取多个视图,它们的背景逻辑将完全连贯。
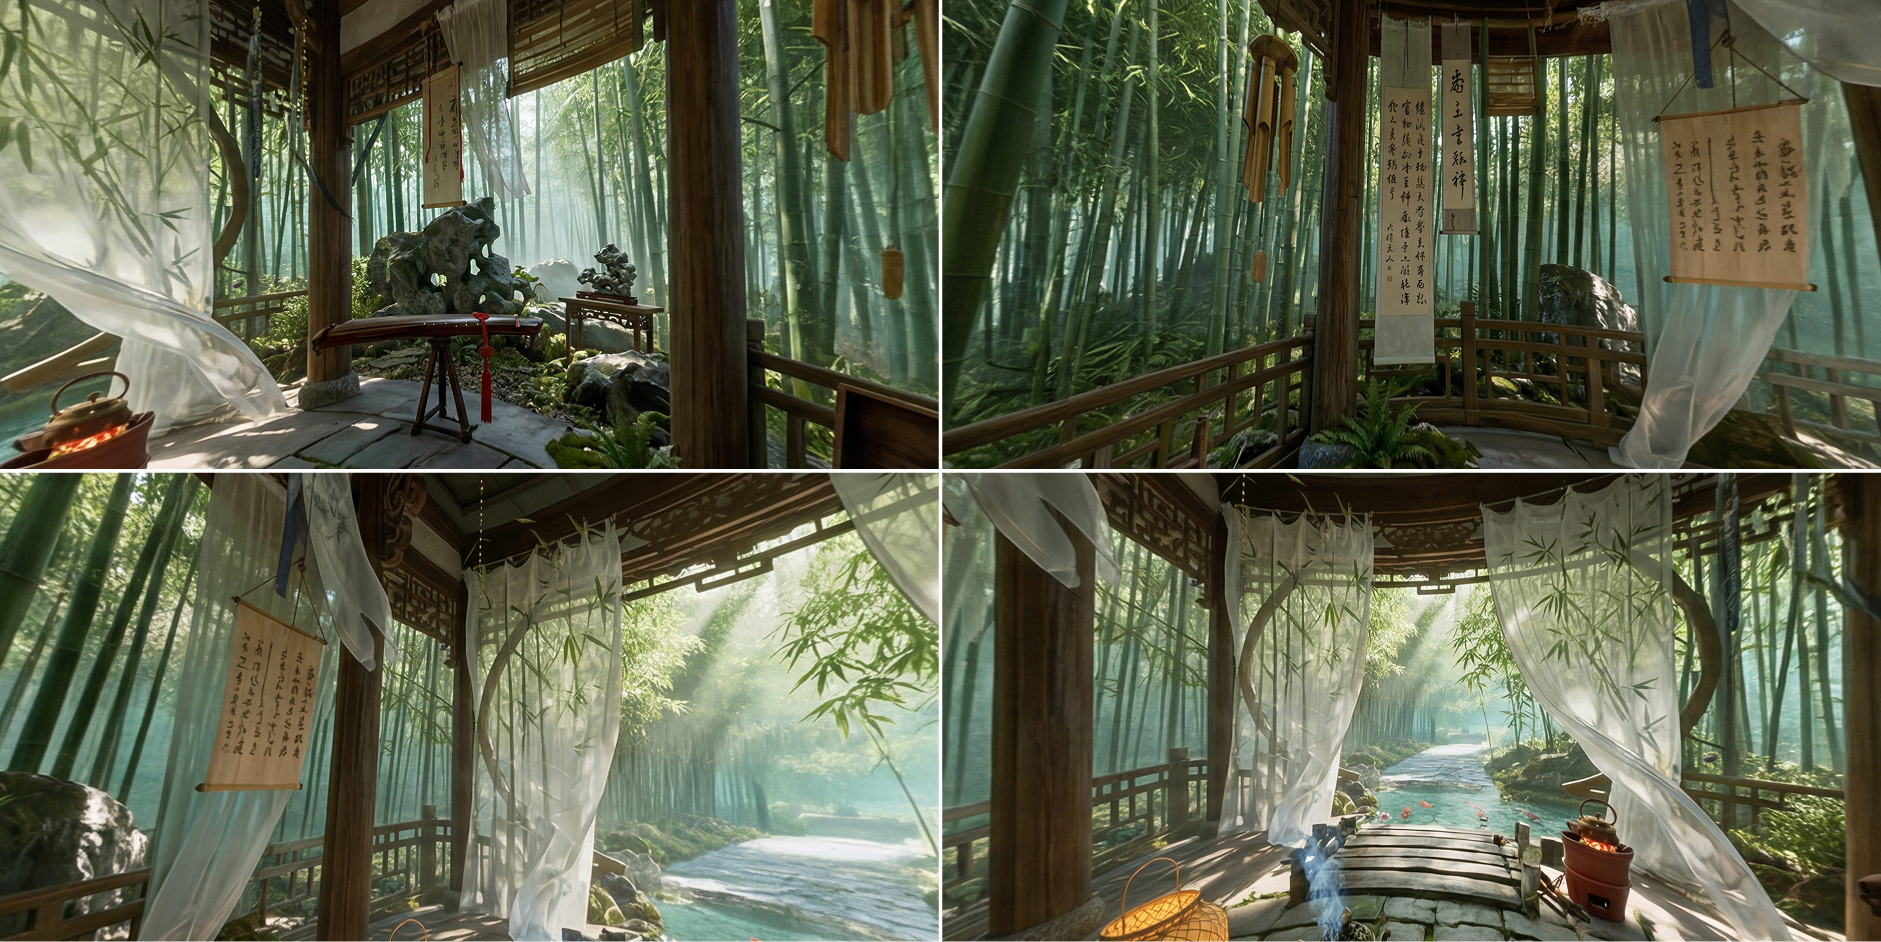
演示:角色与场景的最终融合
将准备好的2个角色,置入到刚刚截取的不同视角的场景图中。
使用nano banana pro进行融合
融合的提示词前建议加上如下prompt,其中镜头焦段可以自己调整
参考图片环境生成,保持场景一致性,直接使用环境生成。50mm镜头,近景拍摄,无透视
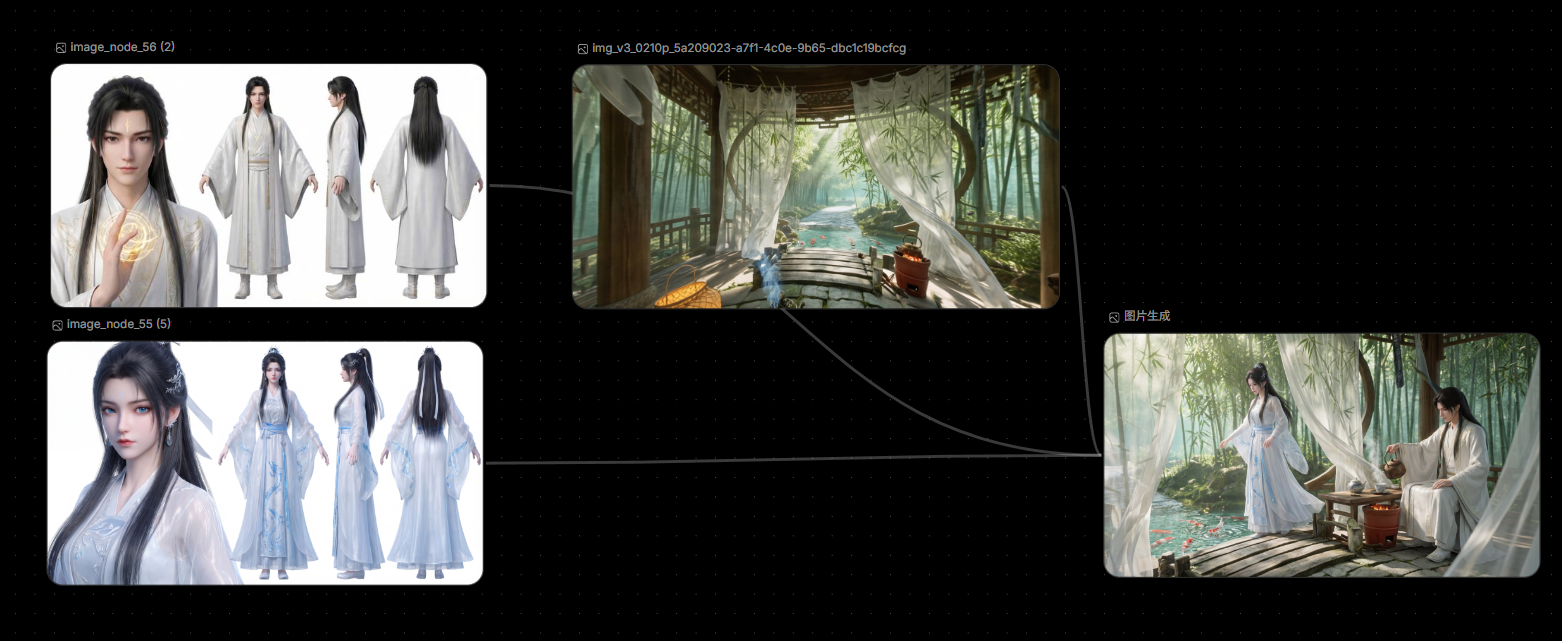
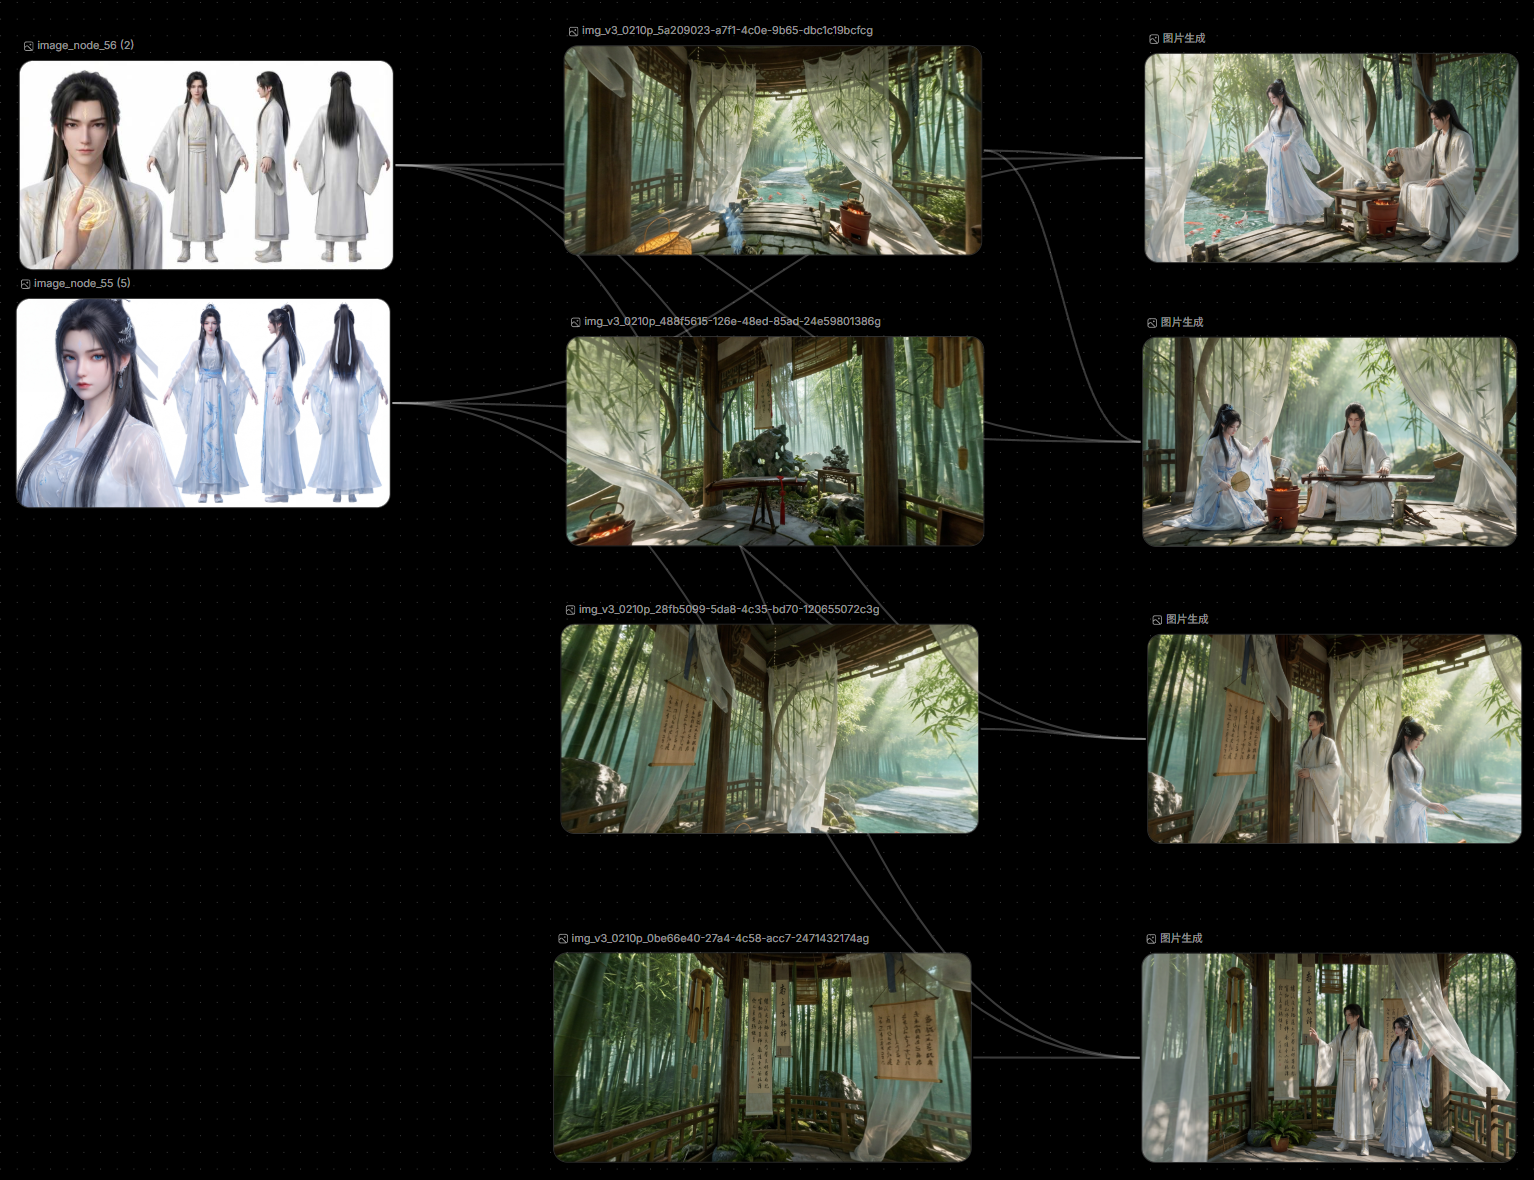
这是我的工作流链接,可以自取
https://app.tapnow.ai/tapflow/view/75429f11
角色设计执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课不是让你照着参考图抄脸,而是围绕「彻底解决AI场景一致性,720全景图“虚拟影棚”取景」把原创角色脸拆成结构、比例、五官主次和妆造记忆点。
按原文节奏走最稳:先吃透「准备工具」,再把「步骤一:准备统一的基础素材」定住,接着处理「步骤二:利用大模型反推全景提示词」;最后用「步骤三:生成全方位场景底图」收口。
- 先把「准备工具」里说的脸型或气质定住。
- 围绕「步骤一:准备统一的基础素材」收一收五官,不要让每个部位都抢戏。
- 把「步骤二:利用大模型反推全景提示词」整理成可复制版本,后面直接复用。
- 先把「步骤三:生成全方位场景底图」里说的脸型或气质定住。
- 围绕「步骤四:全景取景」收一收五官,不要让每个部位都抢戏。
- 做完「演示:角色与场景的最终融合」后,先确认角色还是原创。
不要直接套真人脸或影视角色脸;不要把所有五官都做成强特征,否则容易撞脸、割裂、不稳定。
检查角色是否有清晰记忆点;年龄感和气质是否一致;换妆造后脸是否稳定;是否不像任何明确真人或影视角色。
请围绕「彻底解决AI场景一致性,720全景图“虚拟影棚”取景」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:角色定位、脸型方向、三庭五眼比例、五官主次、妆造记忆点、完整生图提示词。要求原创、有辨识度、避免撞脸和网红脸。