一起来看一下成品:
准备素材与工具
准备工具
image 2.0 https://chatgpt.com/c/
nanobanan pro https://labs.google/fx/tools/flow/
seedance2.0/seedream 5.0pro(图片5.0pro) https://jimeng.jianying.com/ai-tool/home/(即梦AI)
倘若不知道模型怎么使用,可以参考这个教程(https://www.super-i.cn/info-2796.html),与本教程一起使用
https://www.flowpix.club/bj/32965.html?token=46d6285310cf711d951653c38357d433
准备素材
本次参考的是一条点赞超过50万的抖音视频:
视频如下:
图片素材(从网络上搜集的穿搭图):
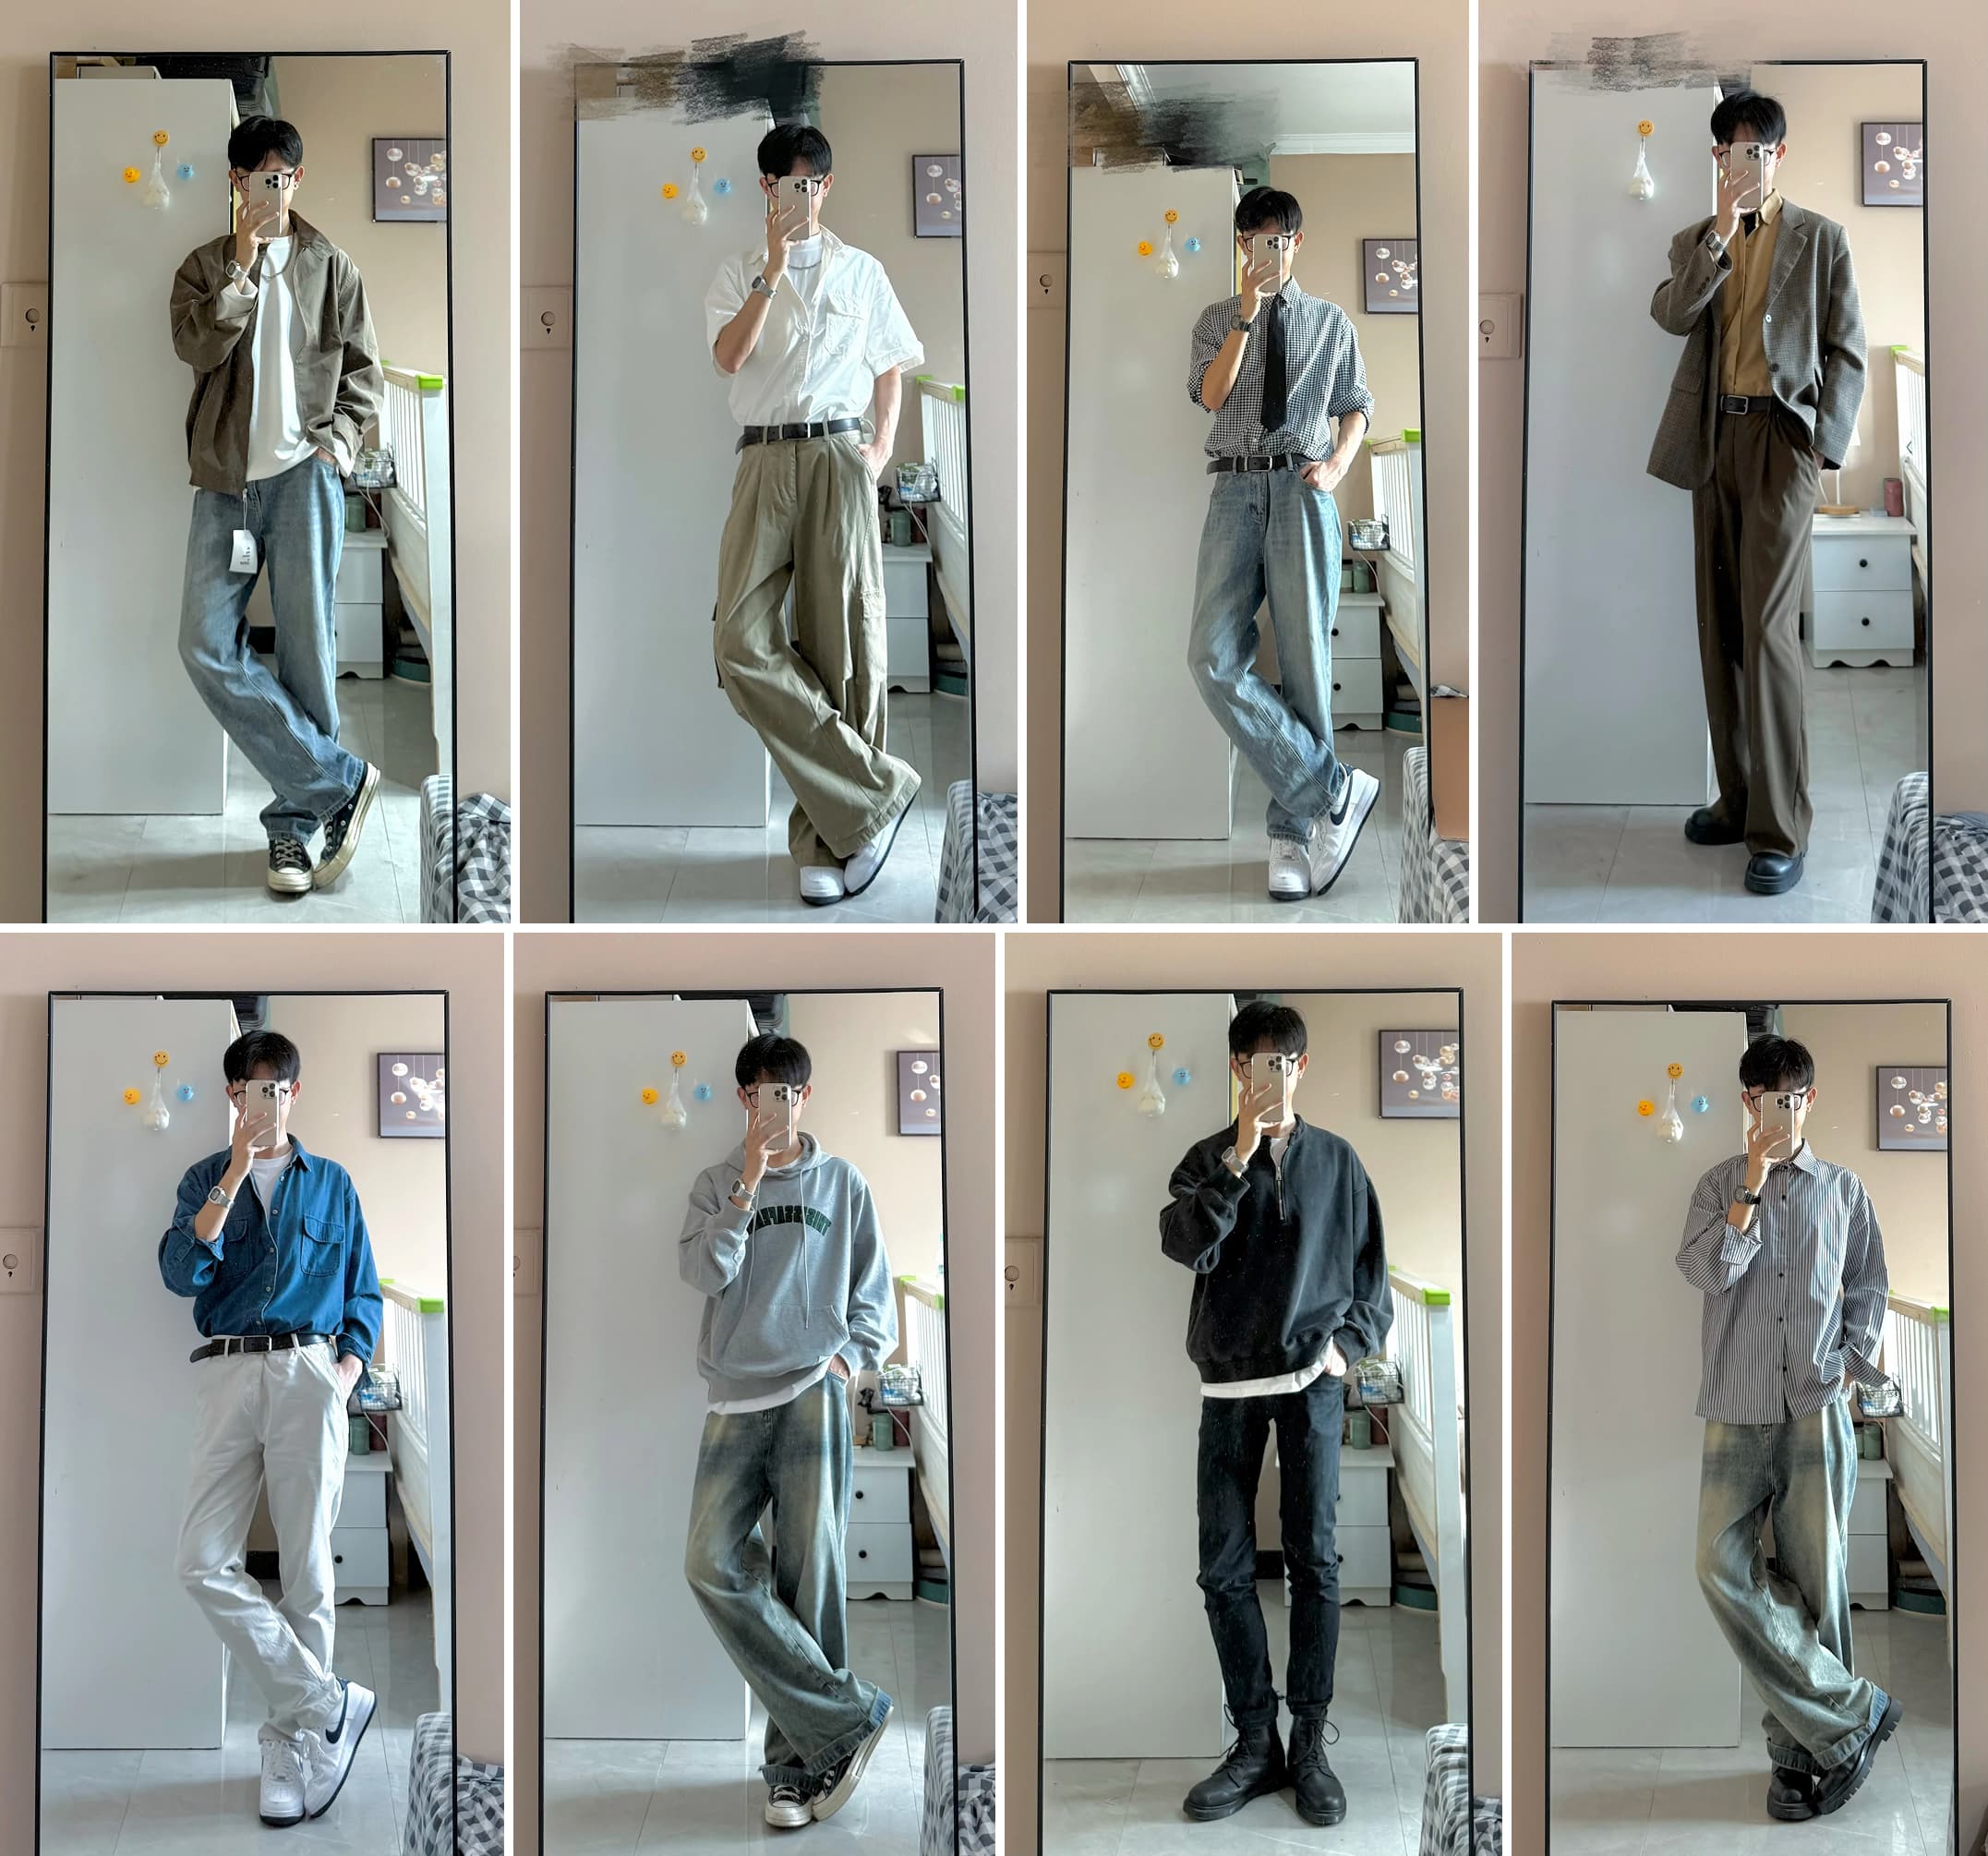
第一步:生成统一的模特资产
首先需要确定整条视频中的主角。
这里不一定要自己编写复杂的人物提示词,可以直接打开即梦的灵感库,搜索“网感美女图”,里面能够找到大量自然、真实的人物形象。
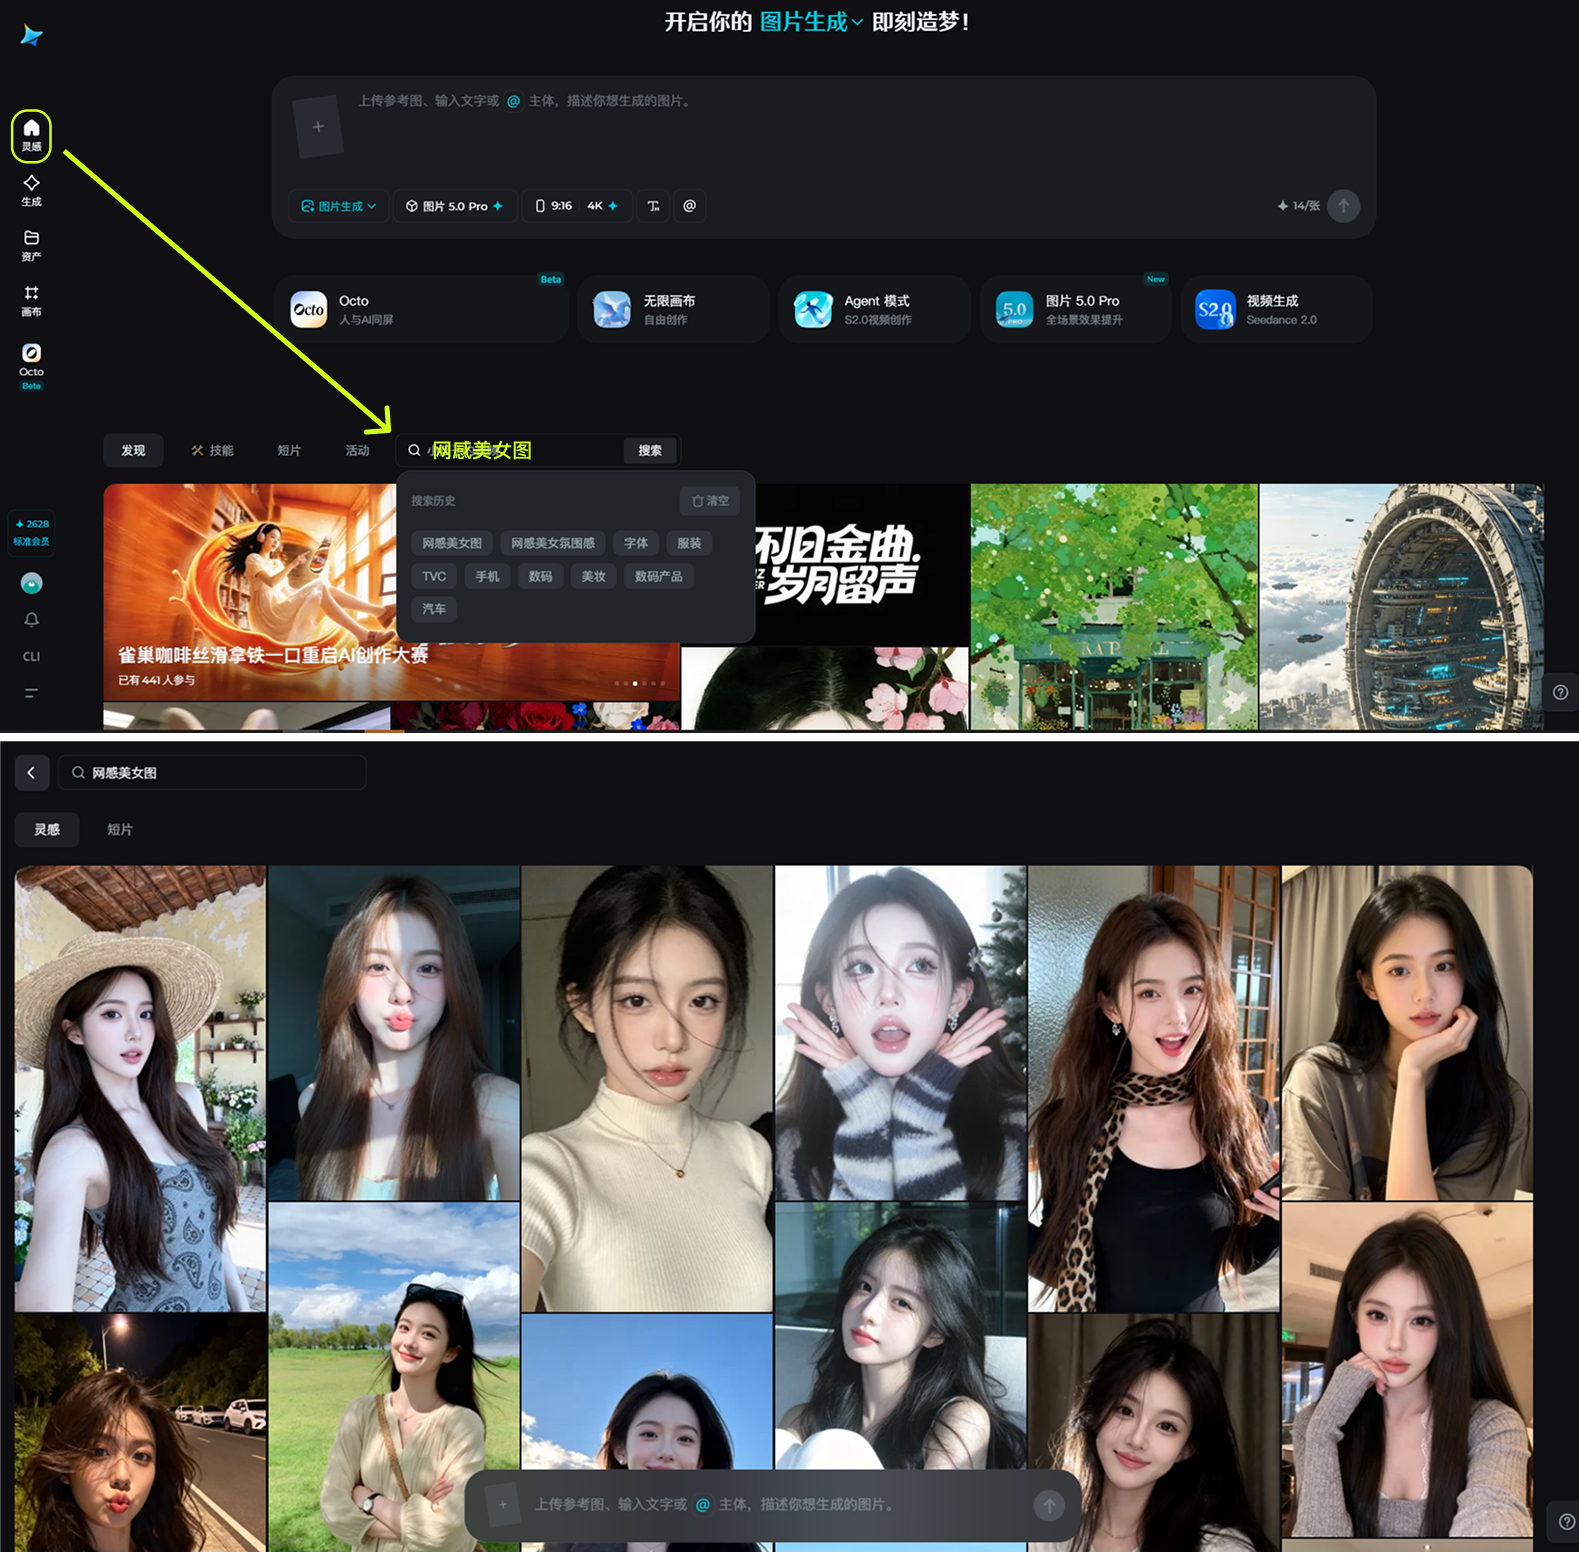
选择一张符合视频气质的人物图片,点击“做同款”,将生成模型更换为 图片 5.0 Pro,然后直接生成。
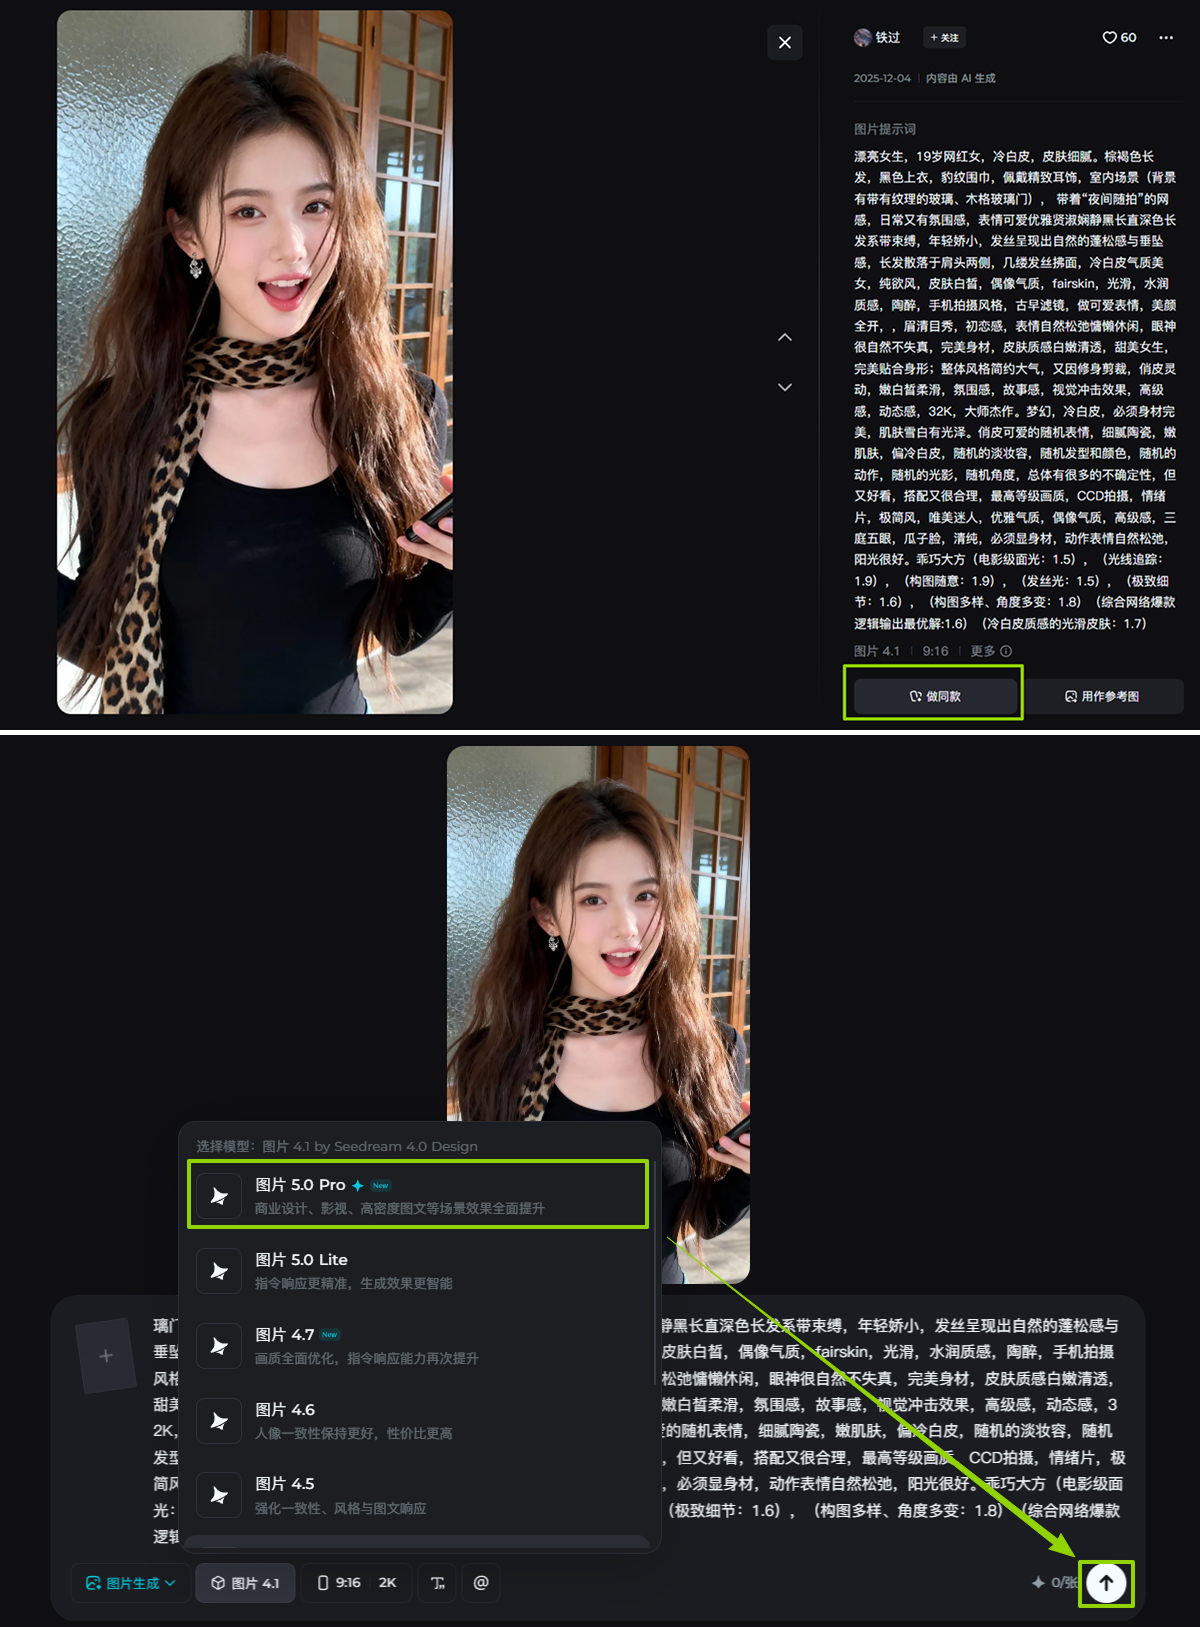
挑选人物时,尽量避开皮肤过度光滑、五官过于夸张、妆容太浓或者明显带有AI质感的形象
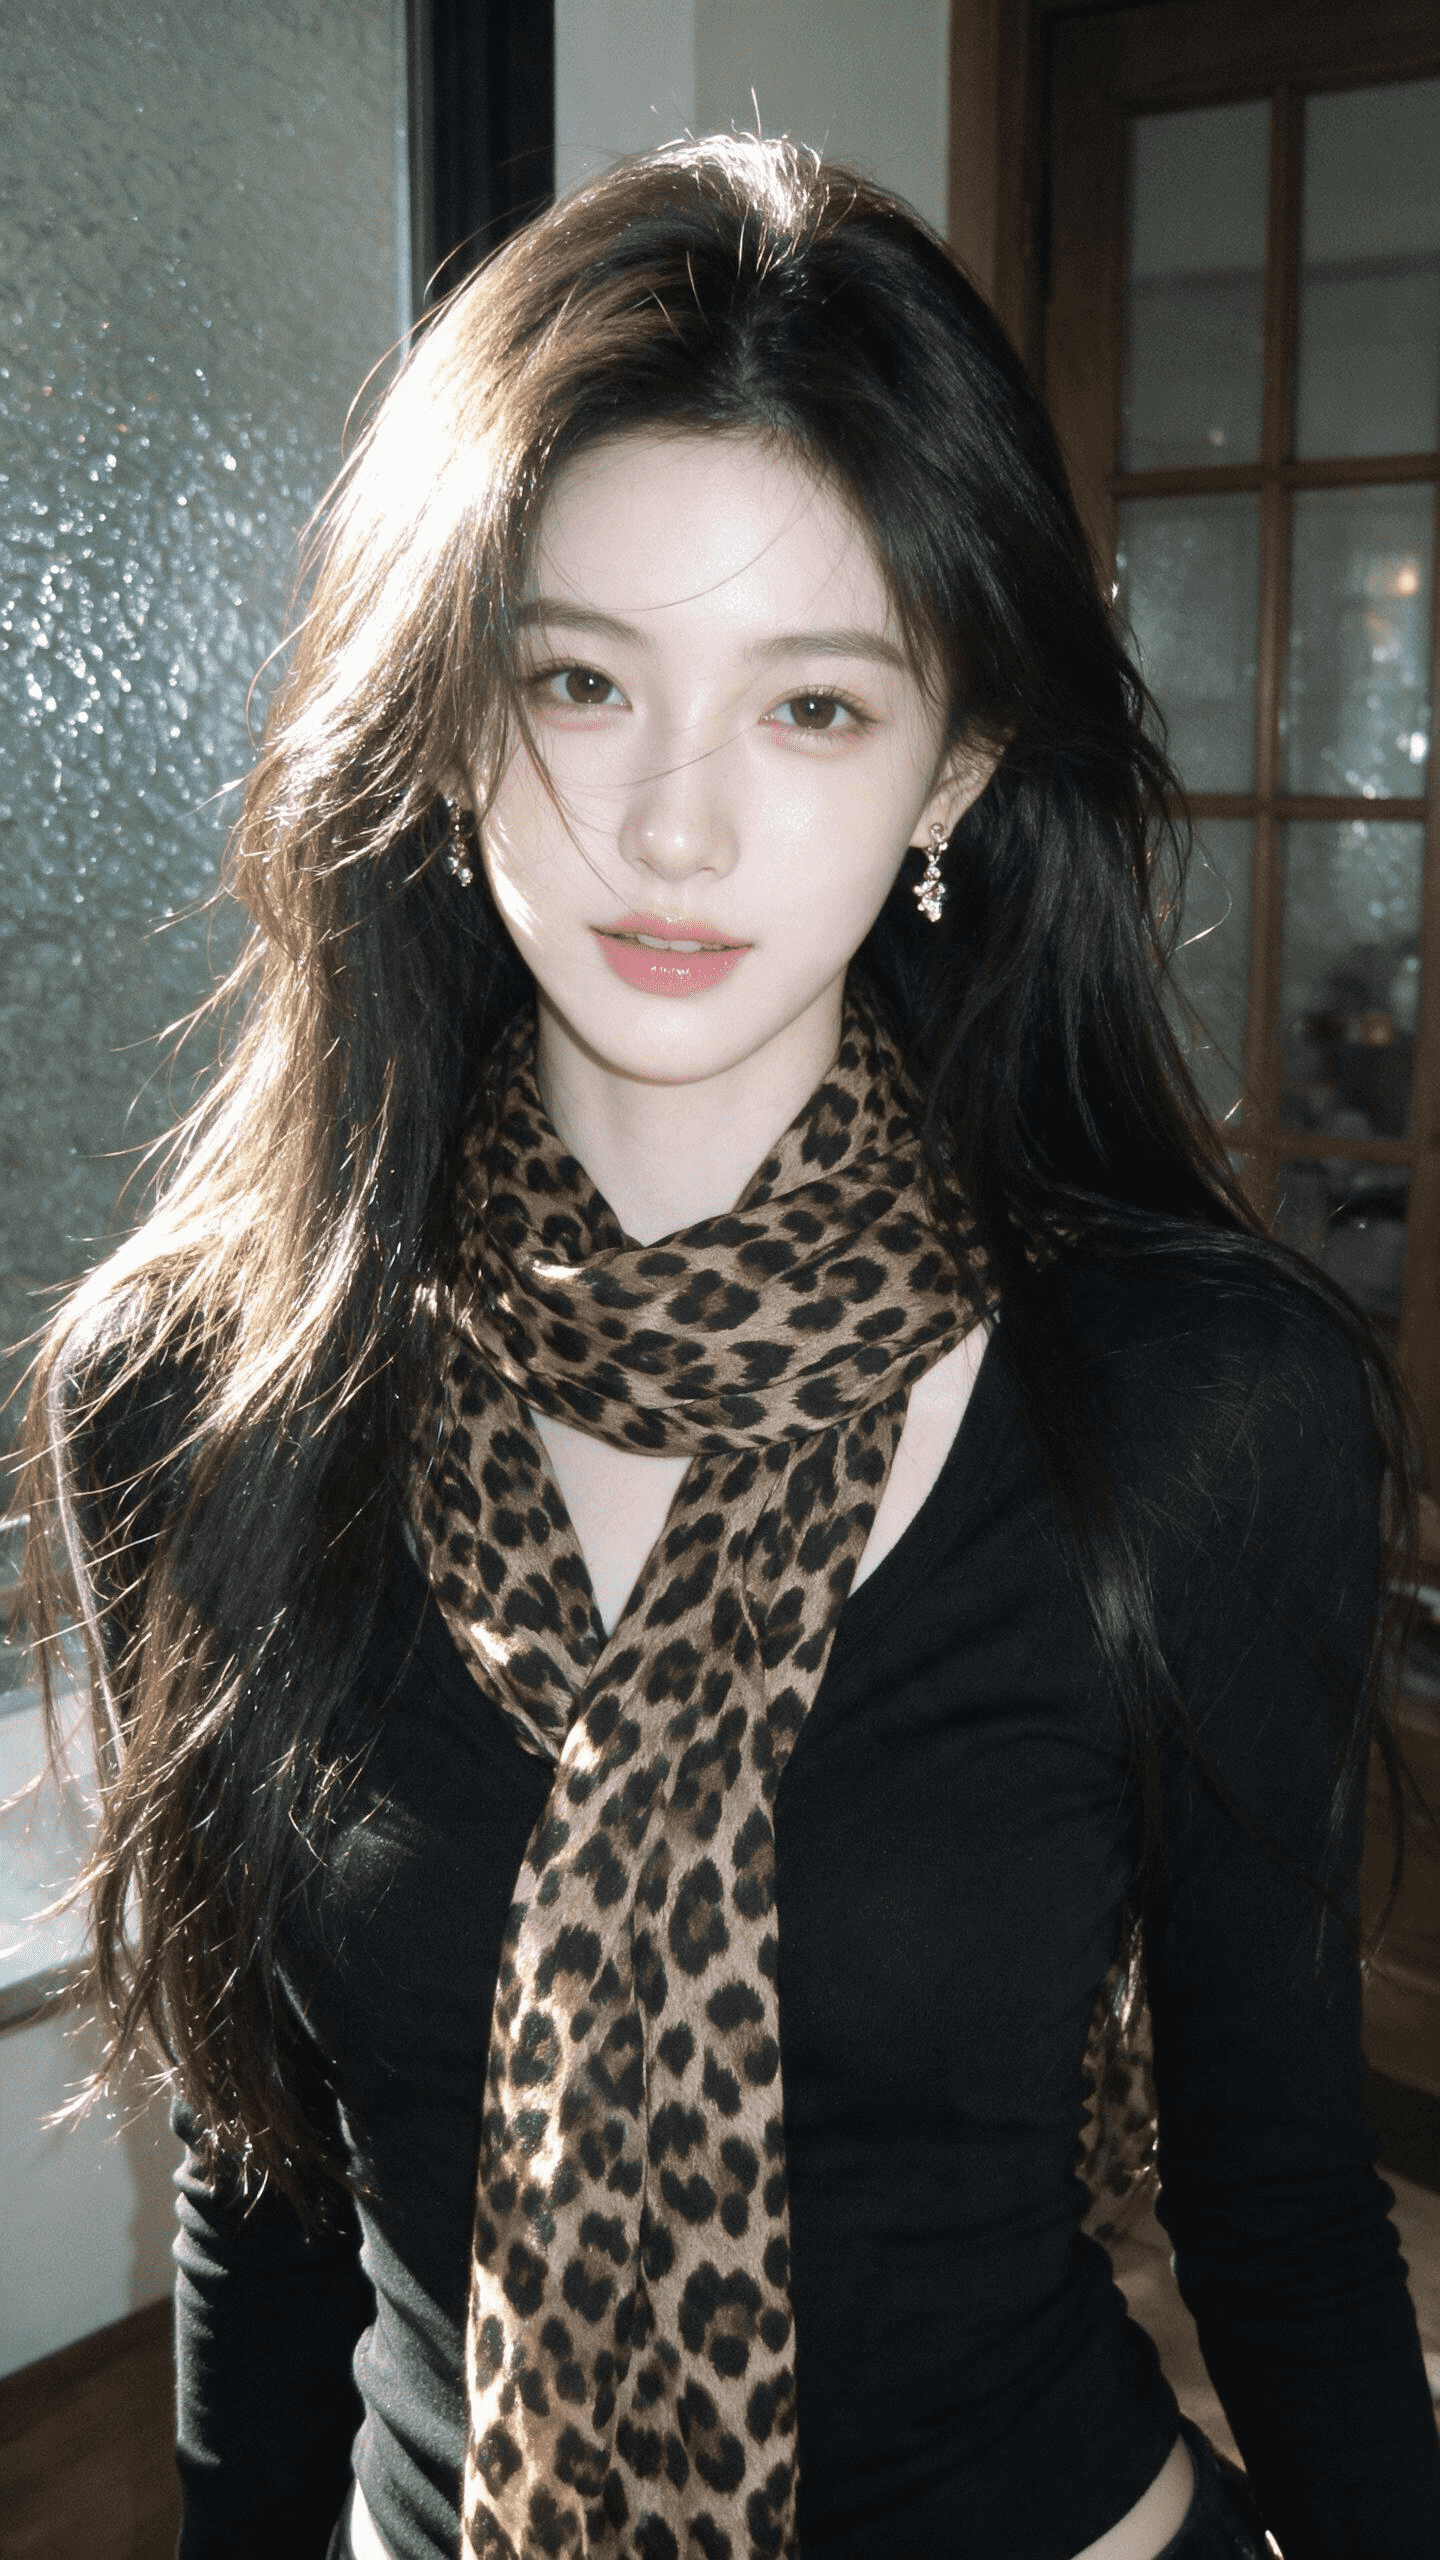
得到了这张人物肖像
确定模特后,可以使用 Nano Banana Pro 或 即梦图片 5.0 Pro,将人物生成一张四视图资产。
这里只生成一张正面全身图也可以,不过全身图中的脸部占比较小,视频生成时容易出现脸部不像、皮肤过度油亮或者五官发生变化的问题。
四视图提示词如下(使用上图进行图生图):
生成图中人物的真人形象设定四视图,灰色摄影棚背景,整体为专业真人角色定妆参考板,规整排版,干净简洁,不是海报,不是杂志大片,不要剧情动作,不要复杂场景。
整体版式严格分为上下两部分:上半部分占画面高度三分之一,下半部分占画面高度三分之二。 上方区域展示两张精细真人面部特写,左侧为正面面部特写,右侧为侧面面部特写。两张特写都以头部与肩颈为主,构图紧凑,清晰展示人物五官、骨骼结构、妆容、发型、头饰与神态。人物面部特征、发型、妆造、头部配饰必须与参考形象严格一致。皮肤质感真实自然,保留毛孔、细纹、绒毛、眉睫、碎发与皮肤受光后的细微起伏,不磨皮,不过度锐化,不做人像美容,呈现高解析真人摄影棚定妆照质感。
下方区域展示两张身体与服装参考图,左右排列。
左侧图片必须是放大后的正面服装展示图,人物采用标准 A-pose 站姿。 这一张图的重点不是完整全身入镜,而是“人物尺度明显放大”,让角色在画面中占据更大比例。 左侧图片必须使用更近距离的正面取景,人物从肩颈下方开始入画,到鞋子结束,头部因画面放大而被完整裁切到画面之外。 请注意,这张图不是普通远距离全身照,而是近距离放大的正面服装图:人物身体在画面中的占比要明显更大,上半身与下半身都要被放大展示,整体视觉效果像时装定妆板中的服装主体展示图。 人物双肩、双臂、双手、躯干、腰部、腿部、鞋子必须完整保留,画面边缘只允许裁掉头部,不能裁掉手、脚或身体主体。 左侧这张图必须比右侧背面图看起来更“近”、更“满”、更“放大”,让服装细节和身体比例更突出。 禁止把左侧图做成普通小比例全身图,禁止人物在左侧图中显得太小,禁止头部仍然留在画面内,禁止只裁掉半个头或留出下巴、嘴巴、鼻子、头发边缘。
右侧图片为背面全身图,标准 A-pose,完整展示从头部到鞋子的背面全身。人物背对镜头,完整保留背面头部、发型背部、服装背面结构、鞋子与整体轮廓,用于展示角色背面造型。右侧这张图为常规完整背面全身展示,人物比例正常,不需要像左图那样放大裁切。
下方两张图必须为同一个人物、同一套服装、同一组配饰、同一身体比例。整体保持超模感修长比例,但不要夸张变形。服装设计、布料层次、鞋子、穿搭风格、服装结构与配饰样式必须严格遵循原图。所有服装与配饰都要呈现真实物理材质质感,布料有自然褶皱、垂坠和厚薄变化,金属有真实反光,皮革、丝绸、纱质等材质表现真实自然。若原图服装为开叉长裙,则左侧正面放大图中人物可自然一条腿向前迈出半步,以展示开叉结构和露腿效果,但整体仍需保持定妆照式稳定姿态,不要做走秀动作。
光线只使用干净统一的摄影棚三点式打光:正左侧主光,正右侧辅助光,后右侧轮廓光。不要杂乱光效,不要彩色灯光,不要强氛围特效。背景为纯净灰色无缝影棚背景。
严格要求:
上方两张脸部特写占画面上三分之一。 下方两张身体图占画面下三分之二。 左下图必须是“放大后的正面服装展示图”,人物在画面中的占比明显更大,头部因近距离取景被完整裁切出画面。 右下图必须是完整背面全身图。 禁止左下图做成普通比例全身小图。 禁止左下图出现任何头部信息。 禁止左右服装不一致。 禁止人物比例漂移。 禁止 AI 油腻感、塑料皮肤感、过度美颜感、廉价 CG 感。
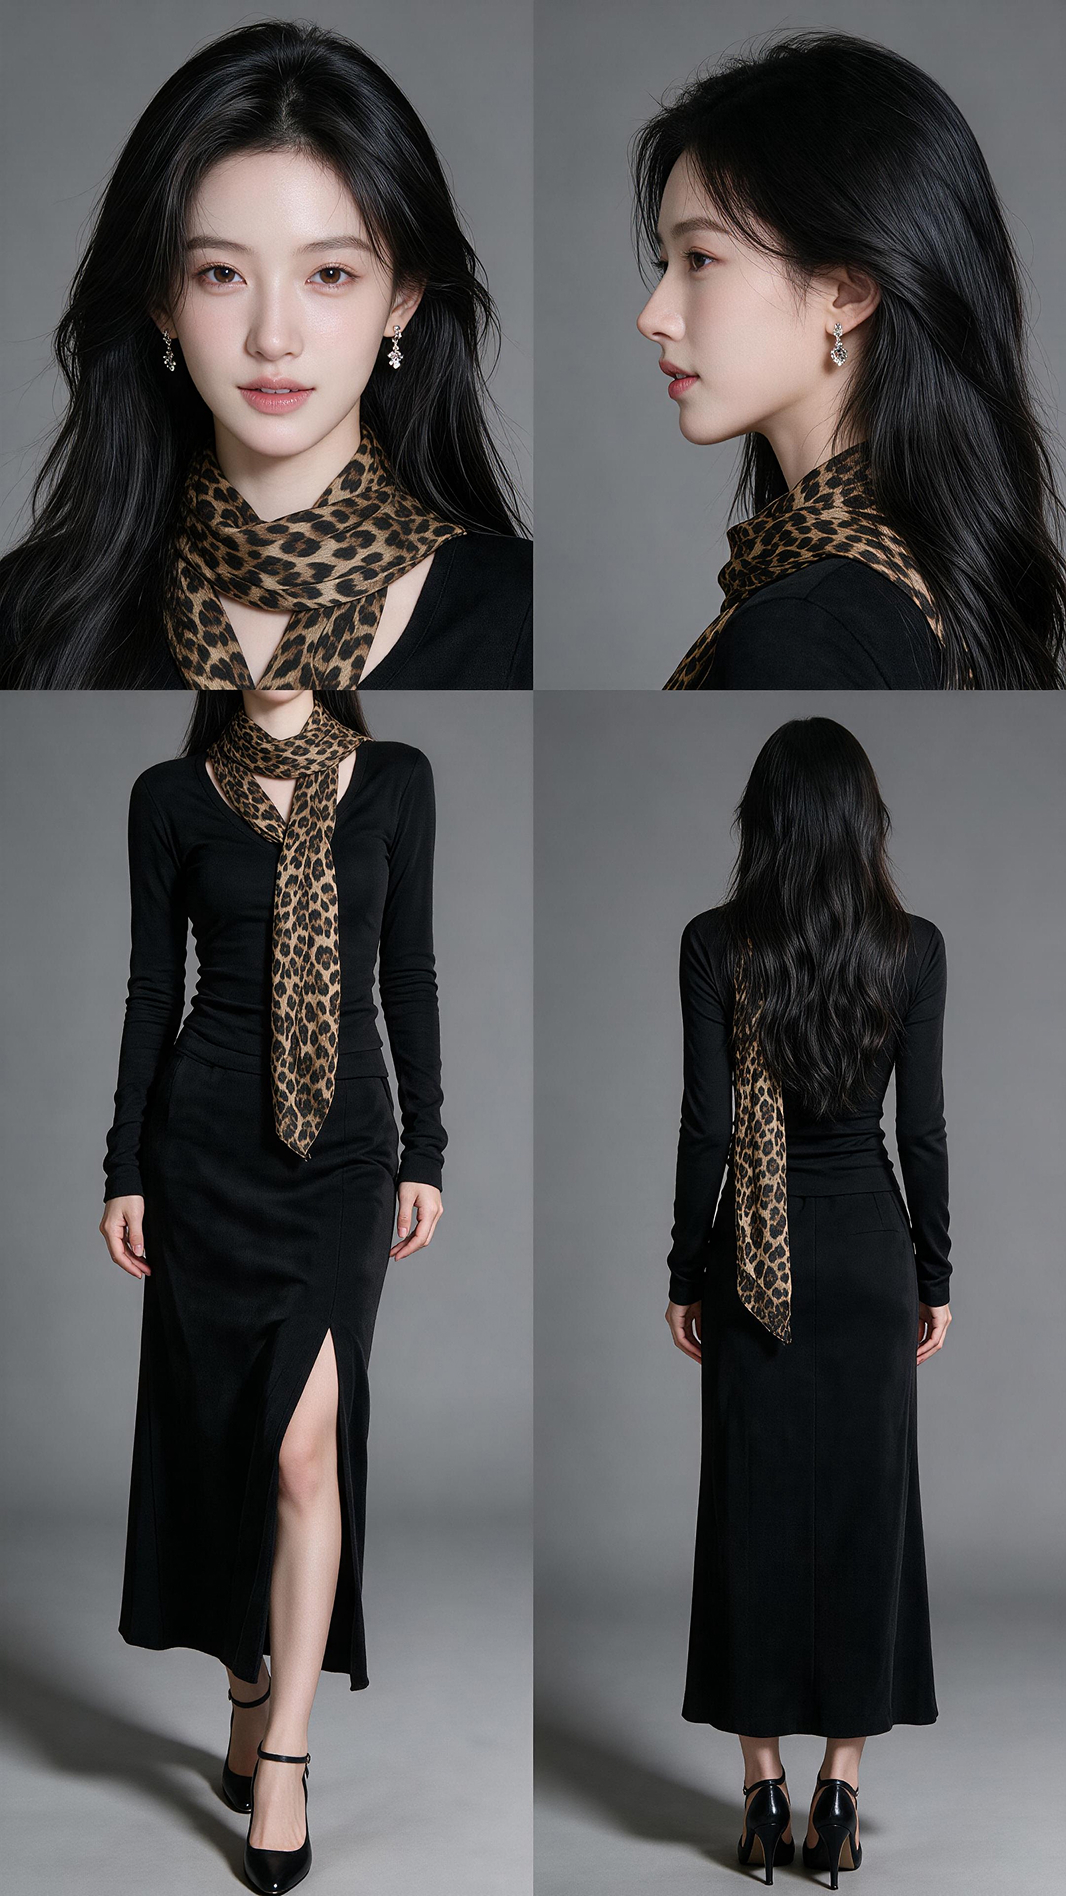
这张图片是由即梦图片5.0pro模型生成
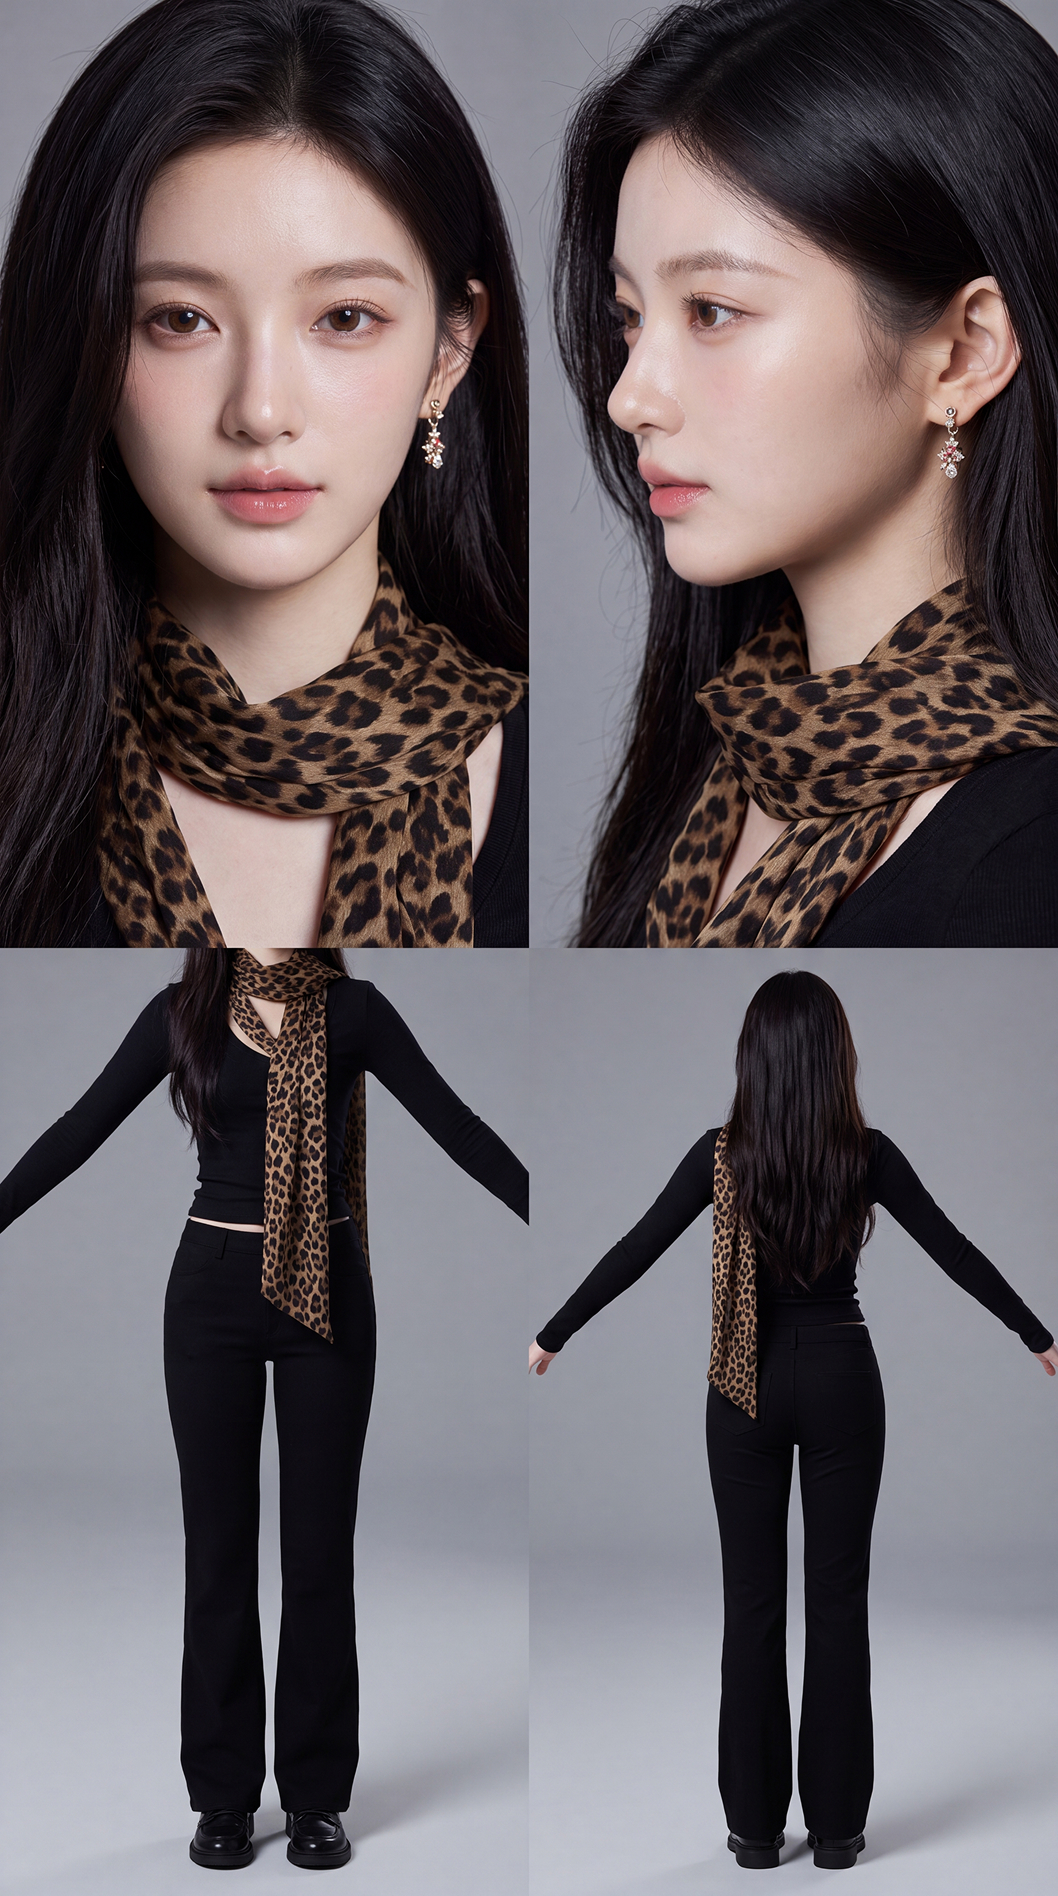
这张图片是由nanobanan pro模型生成
大家可以自己选择用哪个模型去生成,这是俩种不同的取向,即梦图片5.0pro更加还原原图,nanobanan pro 加入了自己的想法
第二步:提取开场的紧身睡衣
参考视频的第一段是整条视频最重要的钩子。
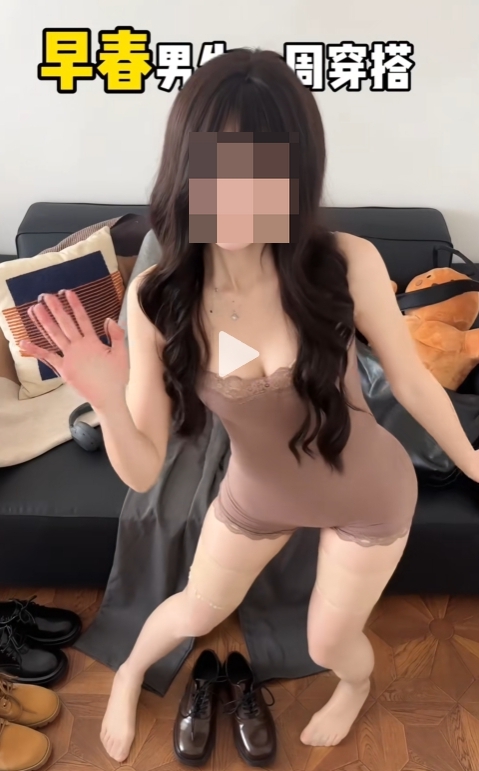
参考视频的截图
人物先穿着一套紧身睡衣出现,随后快速切换成不同的正式穿搭。睡衣与后续服装之间形成明显反差,观众才能在开头几秒内注意到人物的变化。
先截取参考视频中能够完整看清睡衣的画面,再使用 GPT Image 2.0 或 即梦图片5.0pro(SeedanceDream 5.0 Pro),将睡衣单独提取到白色背景上。
提示词如下:
提取出图中人物穿着的衣服到白底图上
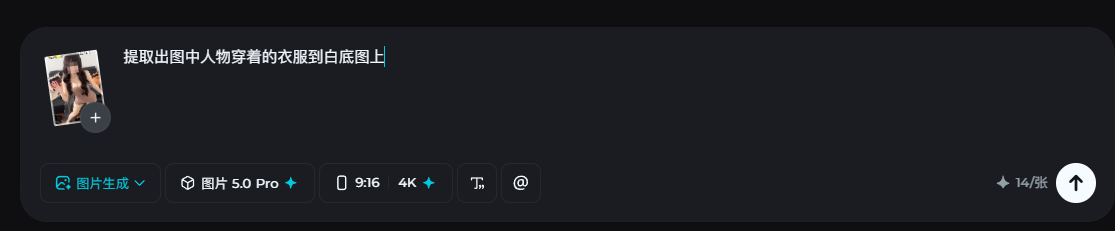
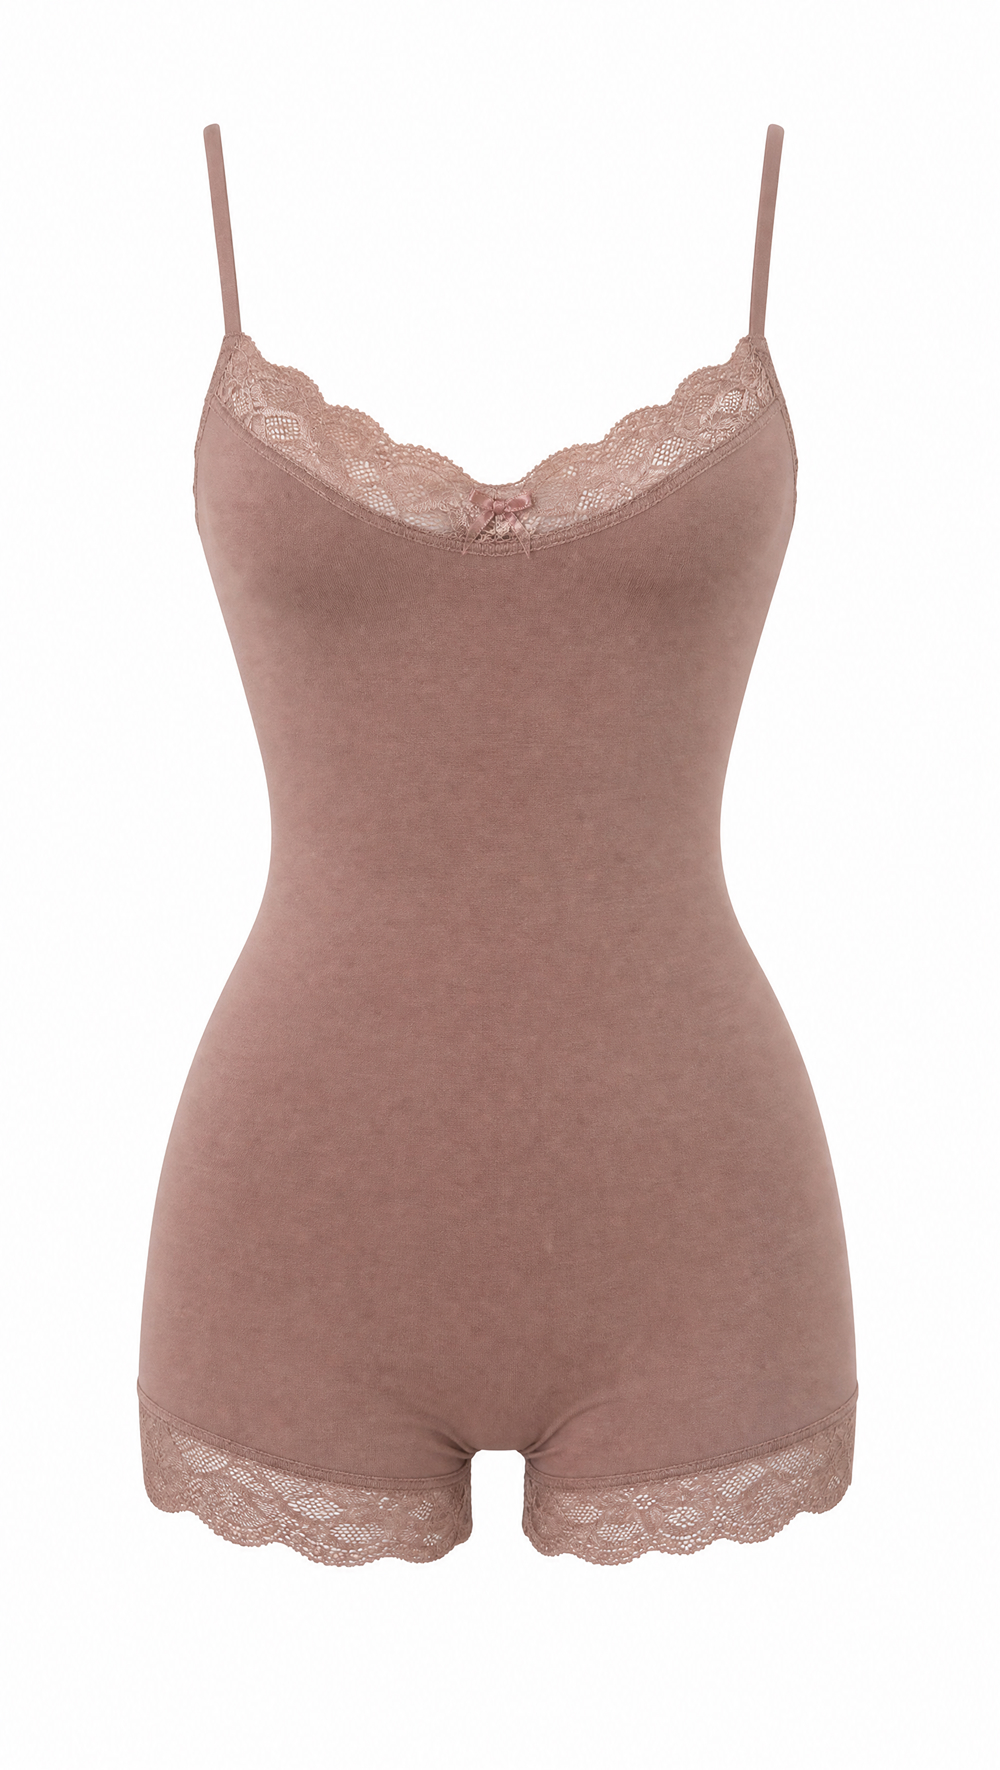
第三步:生成客厅沙发场景
接下来需要准备视频的固定场景。
这类变装视频的场景不需要过于复杂,重点是让人物和服装足够突出。可以选择一间有氛围感的客厅,以沙发作为画面中的主要背景。
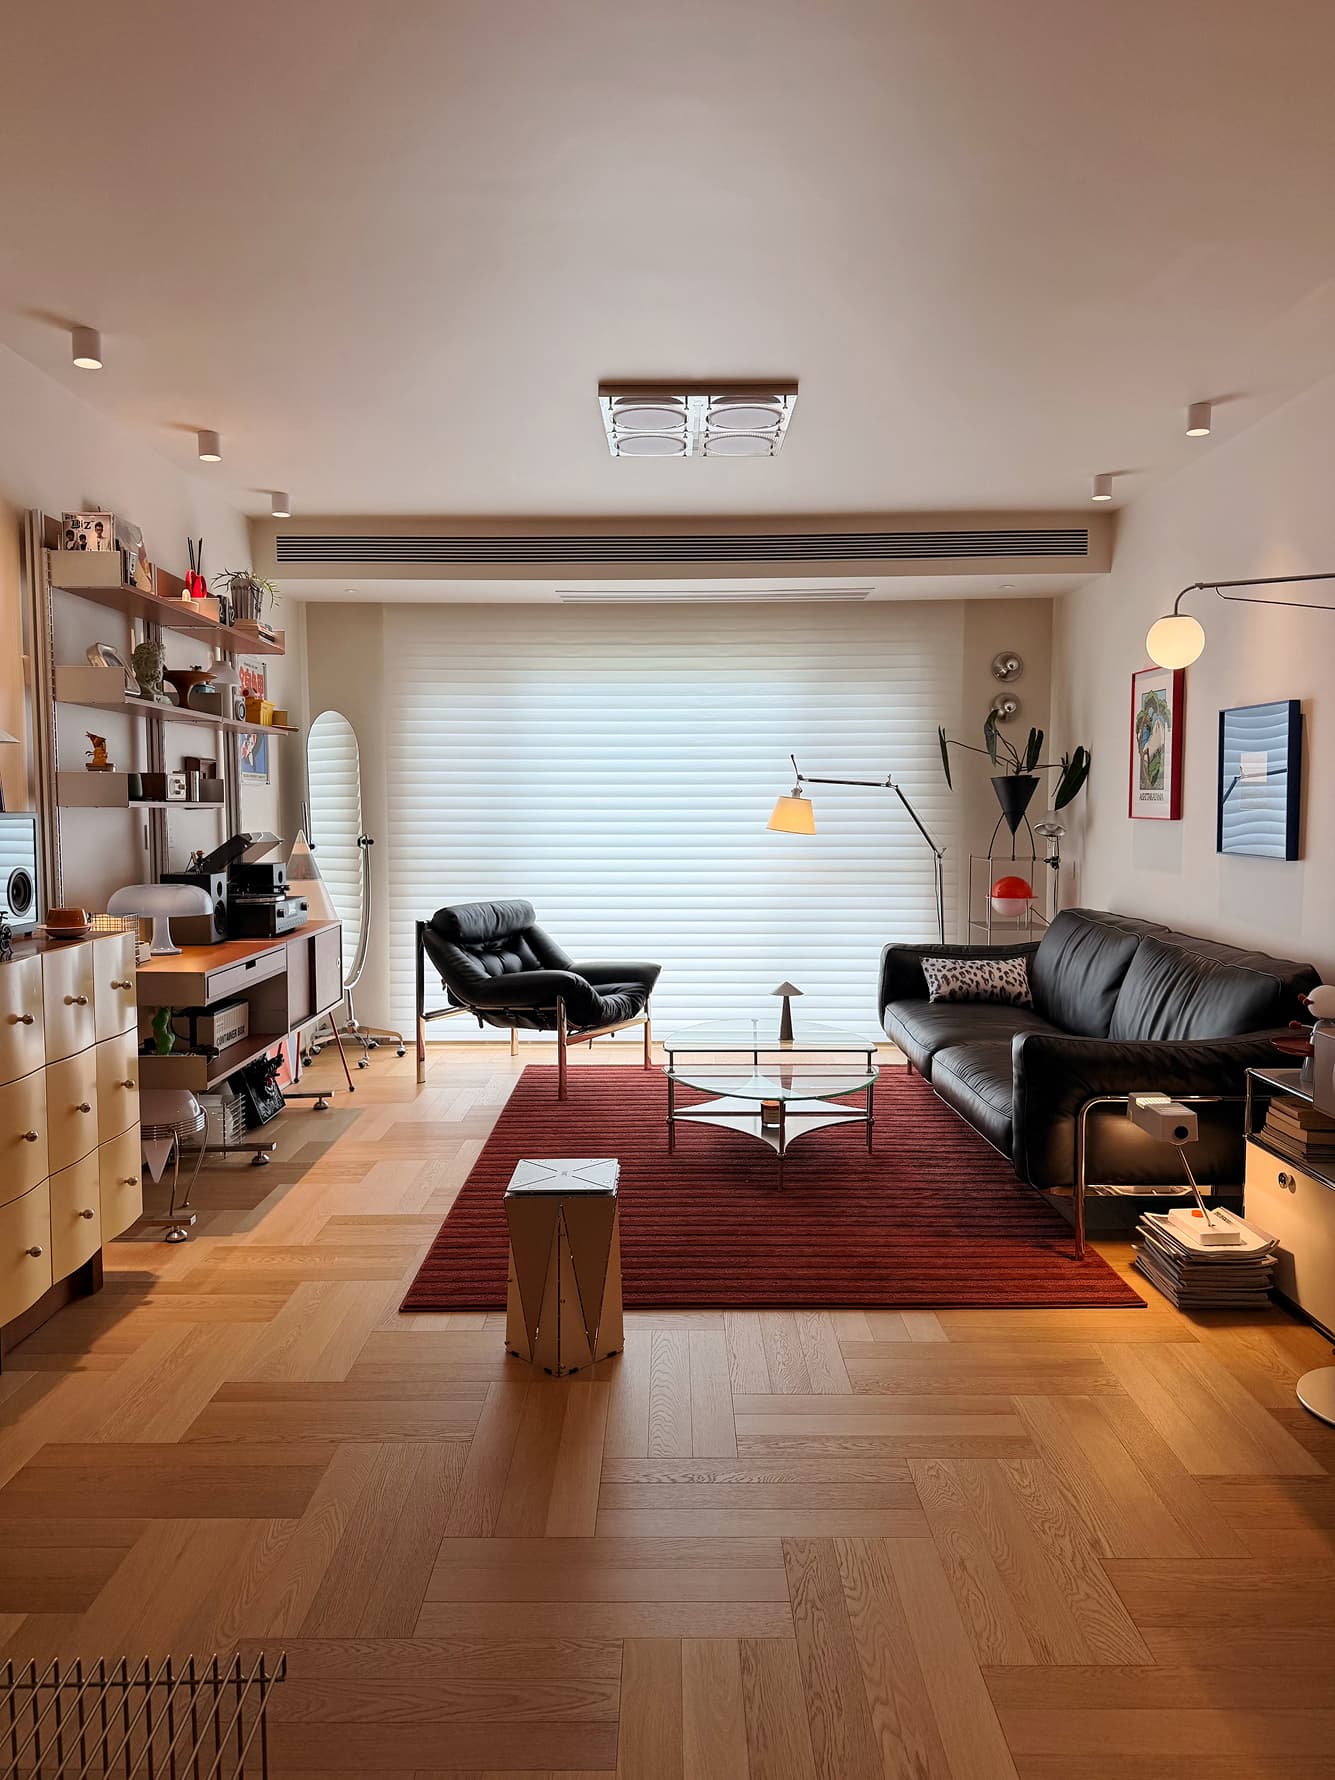
画面也不需要放下整个客厅,更不需要完整展示整张沙发。只要保留人物活动区域、部分沙发和少量背景装饰即可。所以场景提示词可以这样写,使用上图进行图生图。
提示词如下:
以原图作为唯一空间与家具参考,保持客厅原有装修风格、家具款式、材质、色调、灯光氛围和陈设关系一致,不重新设计空间。镜头位于黑色皮质沙发正前方中央上方,采用纯正面高机位俯拍视角,机位与沙发严格平行,从正前方朝下拍摄,俯拍角度明确控制在约60度,强调明显的俯视感,但不要变成顶部鸟瞰。不要任何侧偏,不要左偏或右偏,不要三分之二视角。画面为沙发中景构图,聚焦黑色皮质沙发主体,沙发占据画面主要面积,画面中不要放下整个沙发,允许沙发左右两端自然出画,只展示沙发中段、靠背、坐垫、局部扶手和左侧豹纹抱枕。前景不要出现中间的玻璃茶几,也不要出现任何桌面物体,画面下方只保留少量红色地毯用于交代空间关系,不要出现大面积地板。背景中保留沙发后方白色百叶窗作为主背景,左右环境元素只少量露出,不展示完整客厅,不要全景。整体构图居中、稳定、对称,突出60度俯拍下的沙发体积感、皮革纹理与家居杂志感。真实室内摄影,暖色自然光,35mm或50mm镜头,中景,无广角畸变,无鱼眼,无人物,无文字。
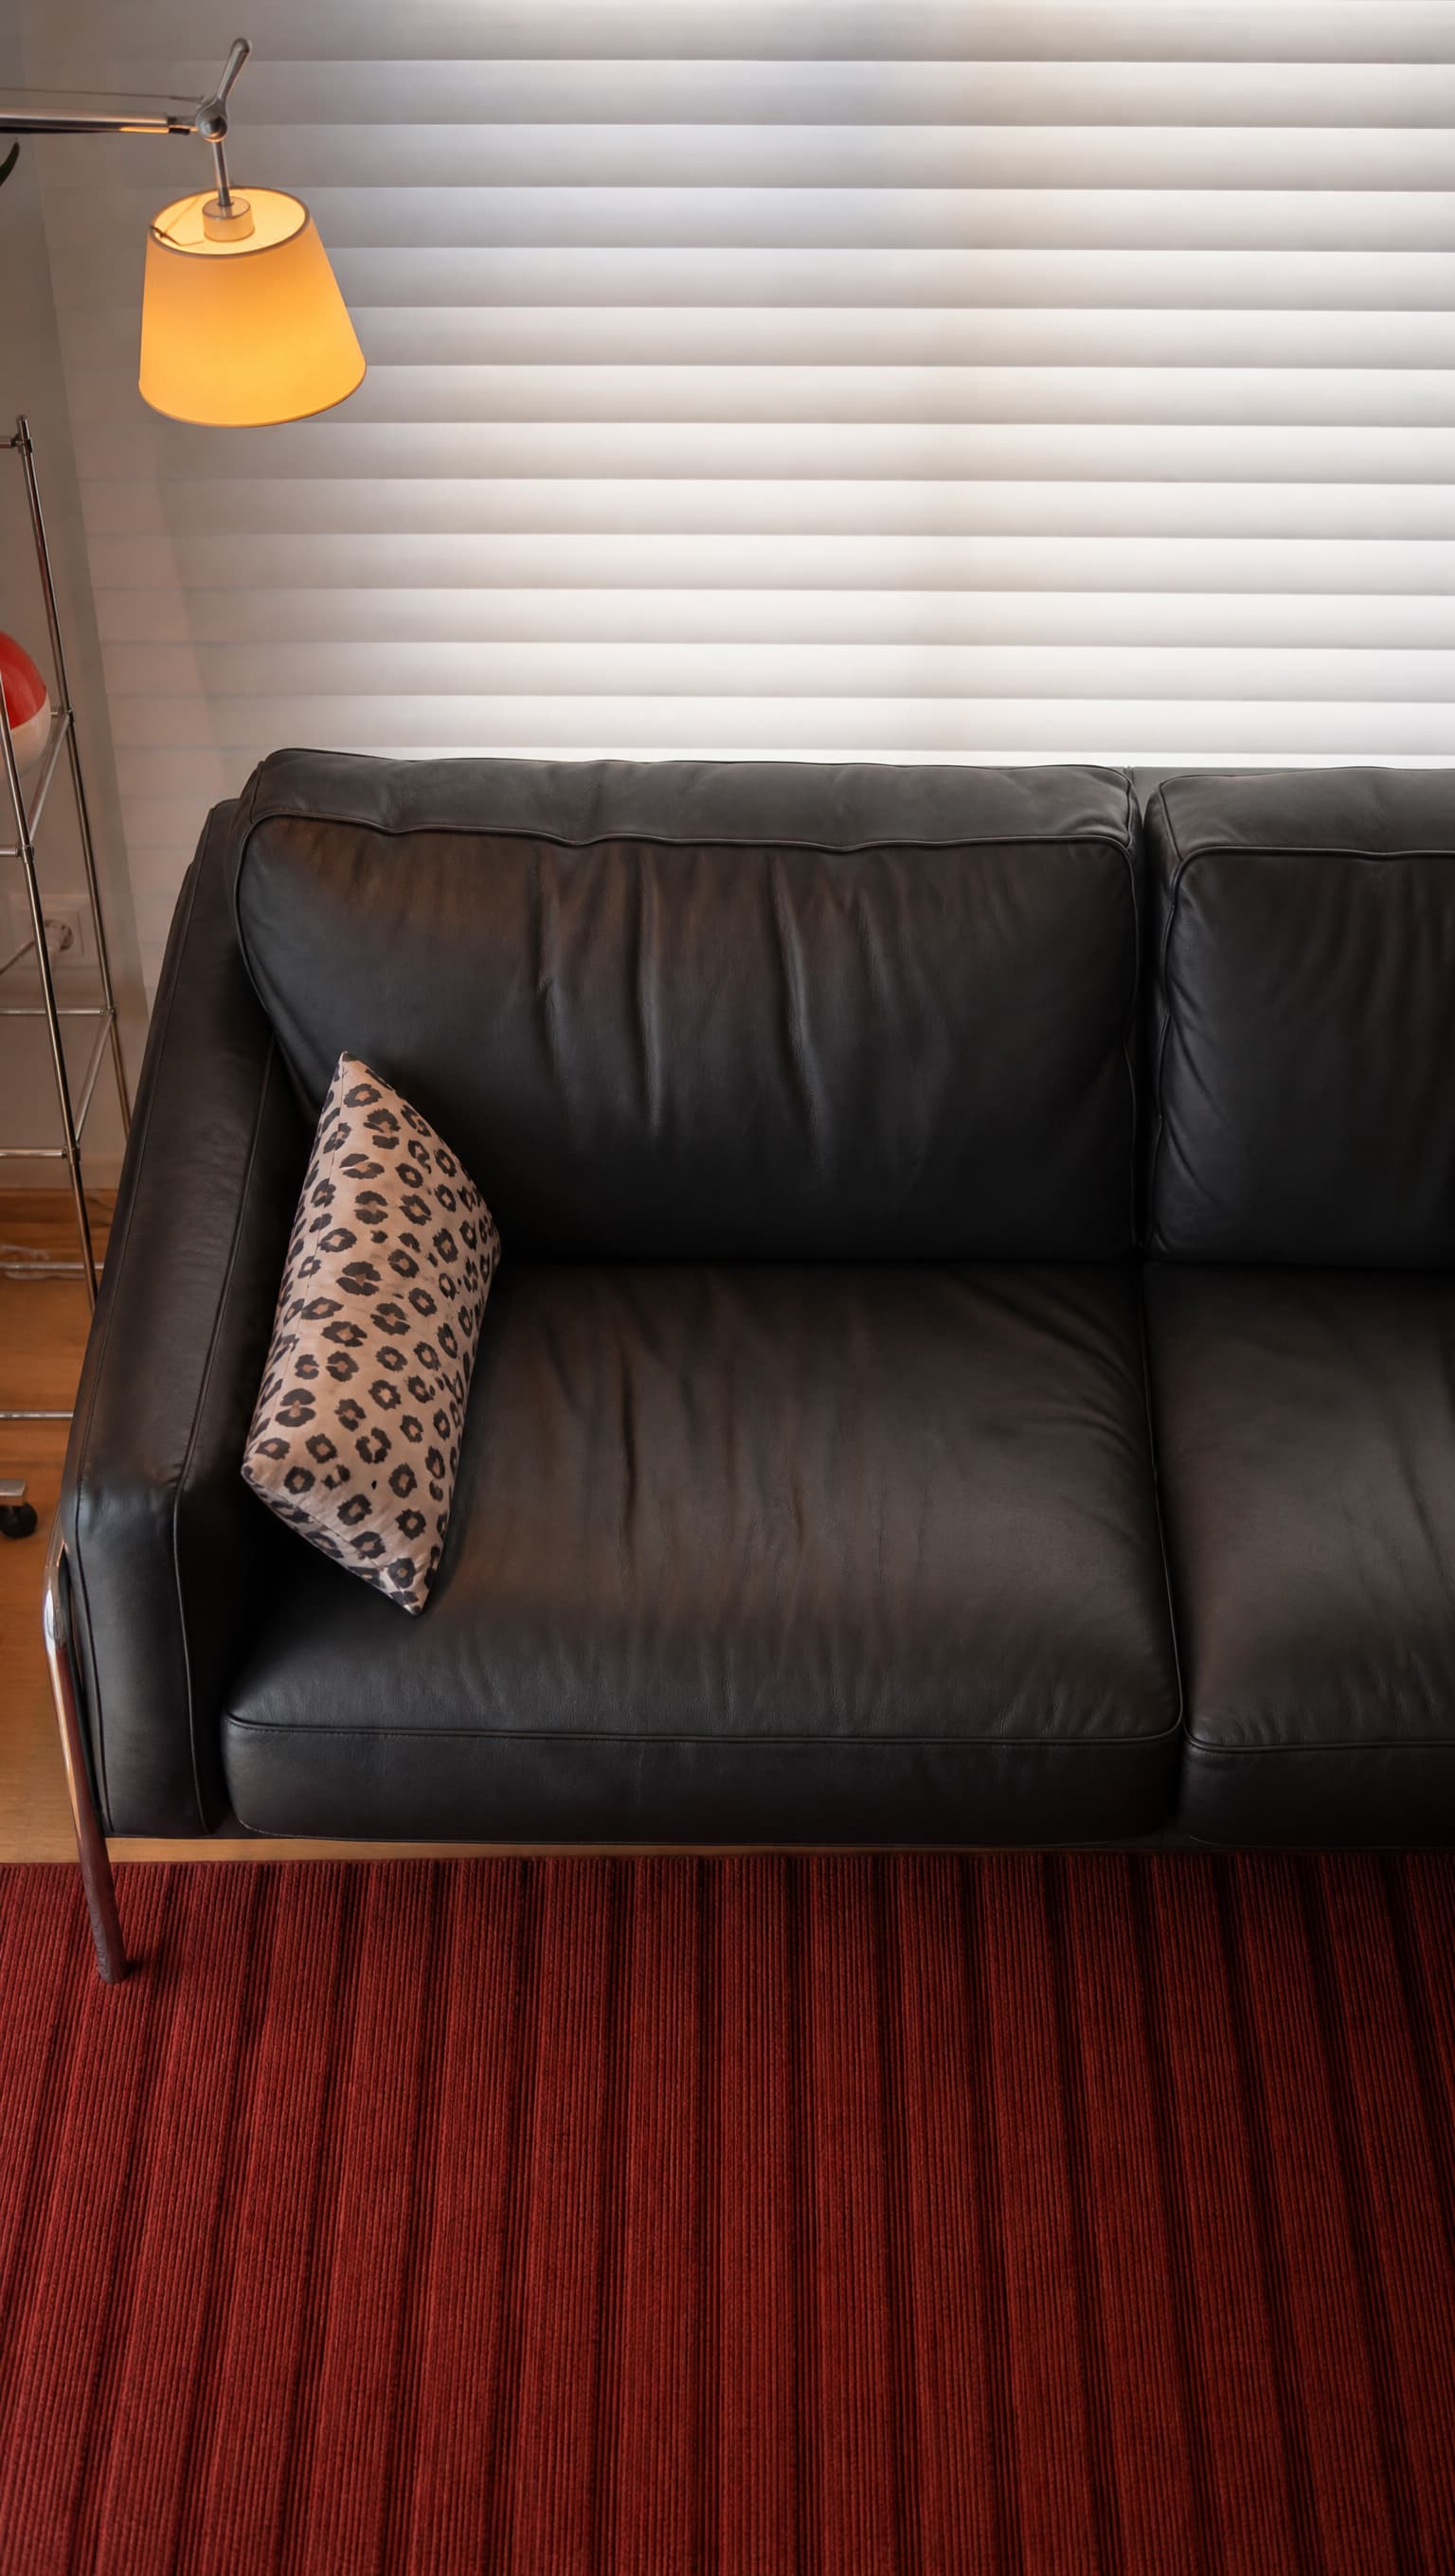
如果第一次生成的场景范围太大,可以在后期直接裁切,让沙发和人物区域占据更大的画面比例。这样生成视频时,人物不会因为场景过大而显得太小。
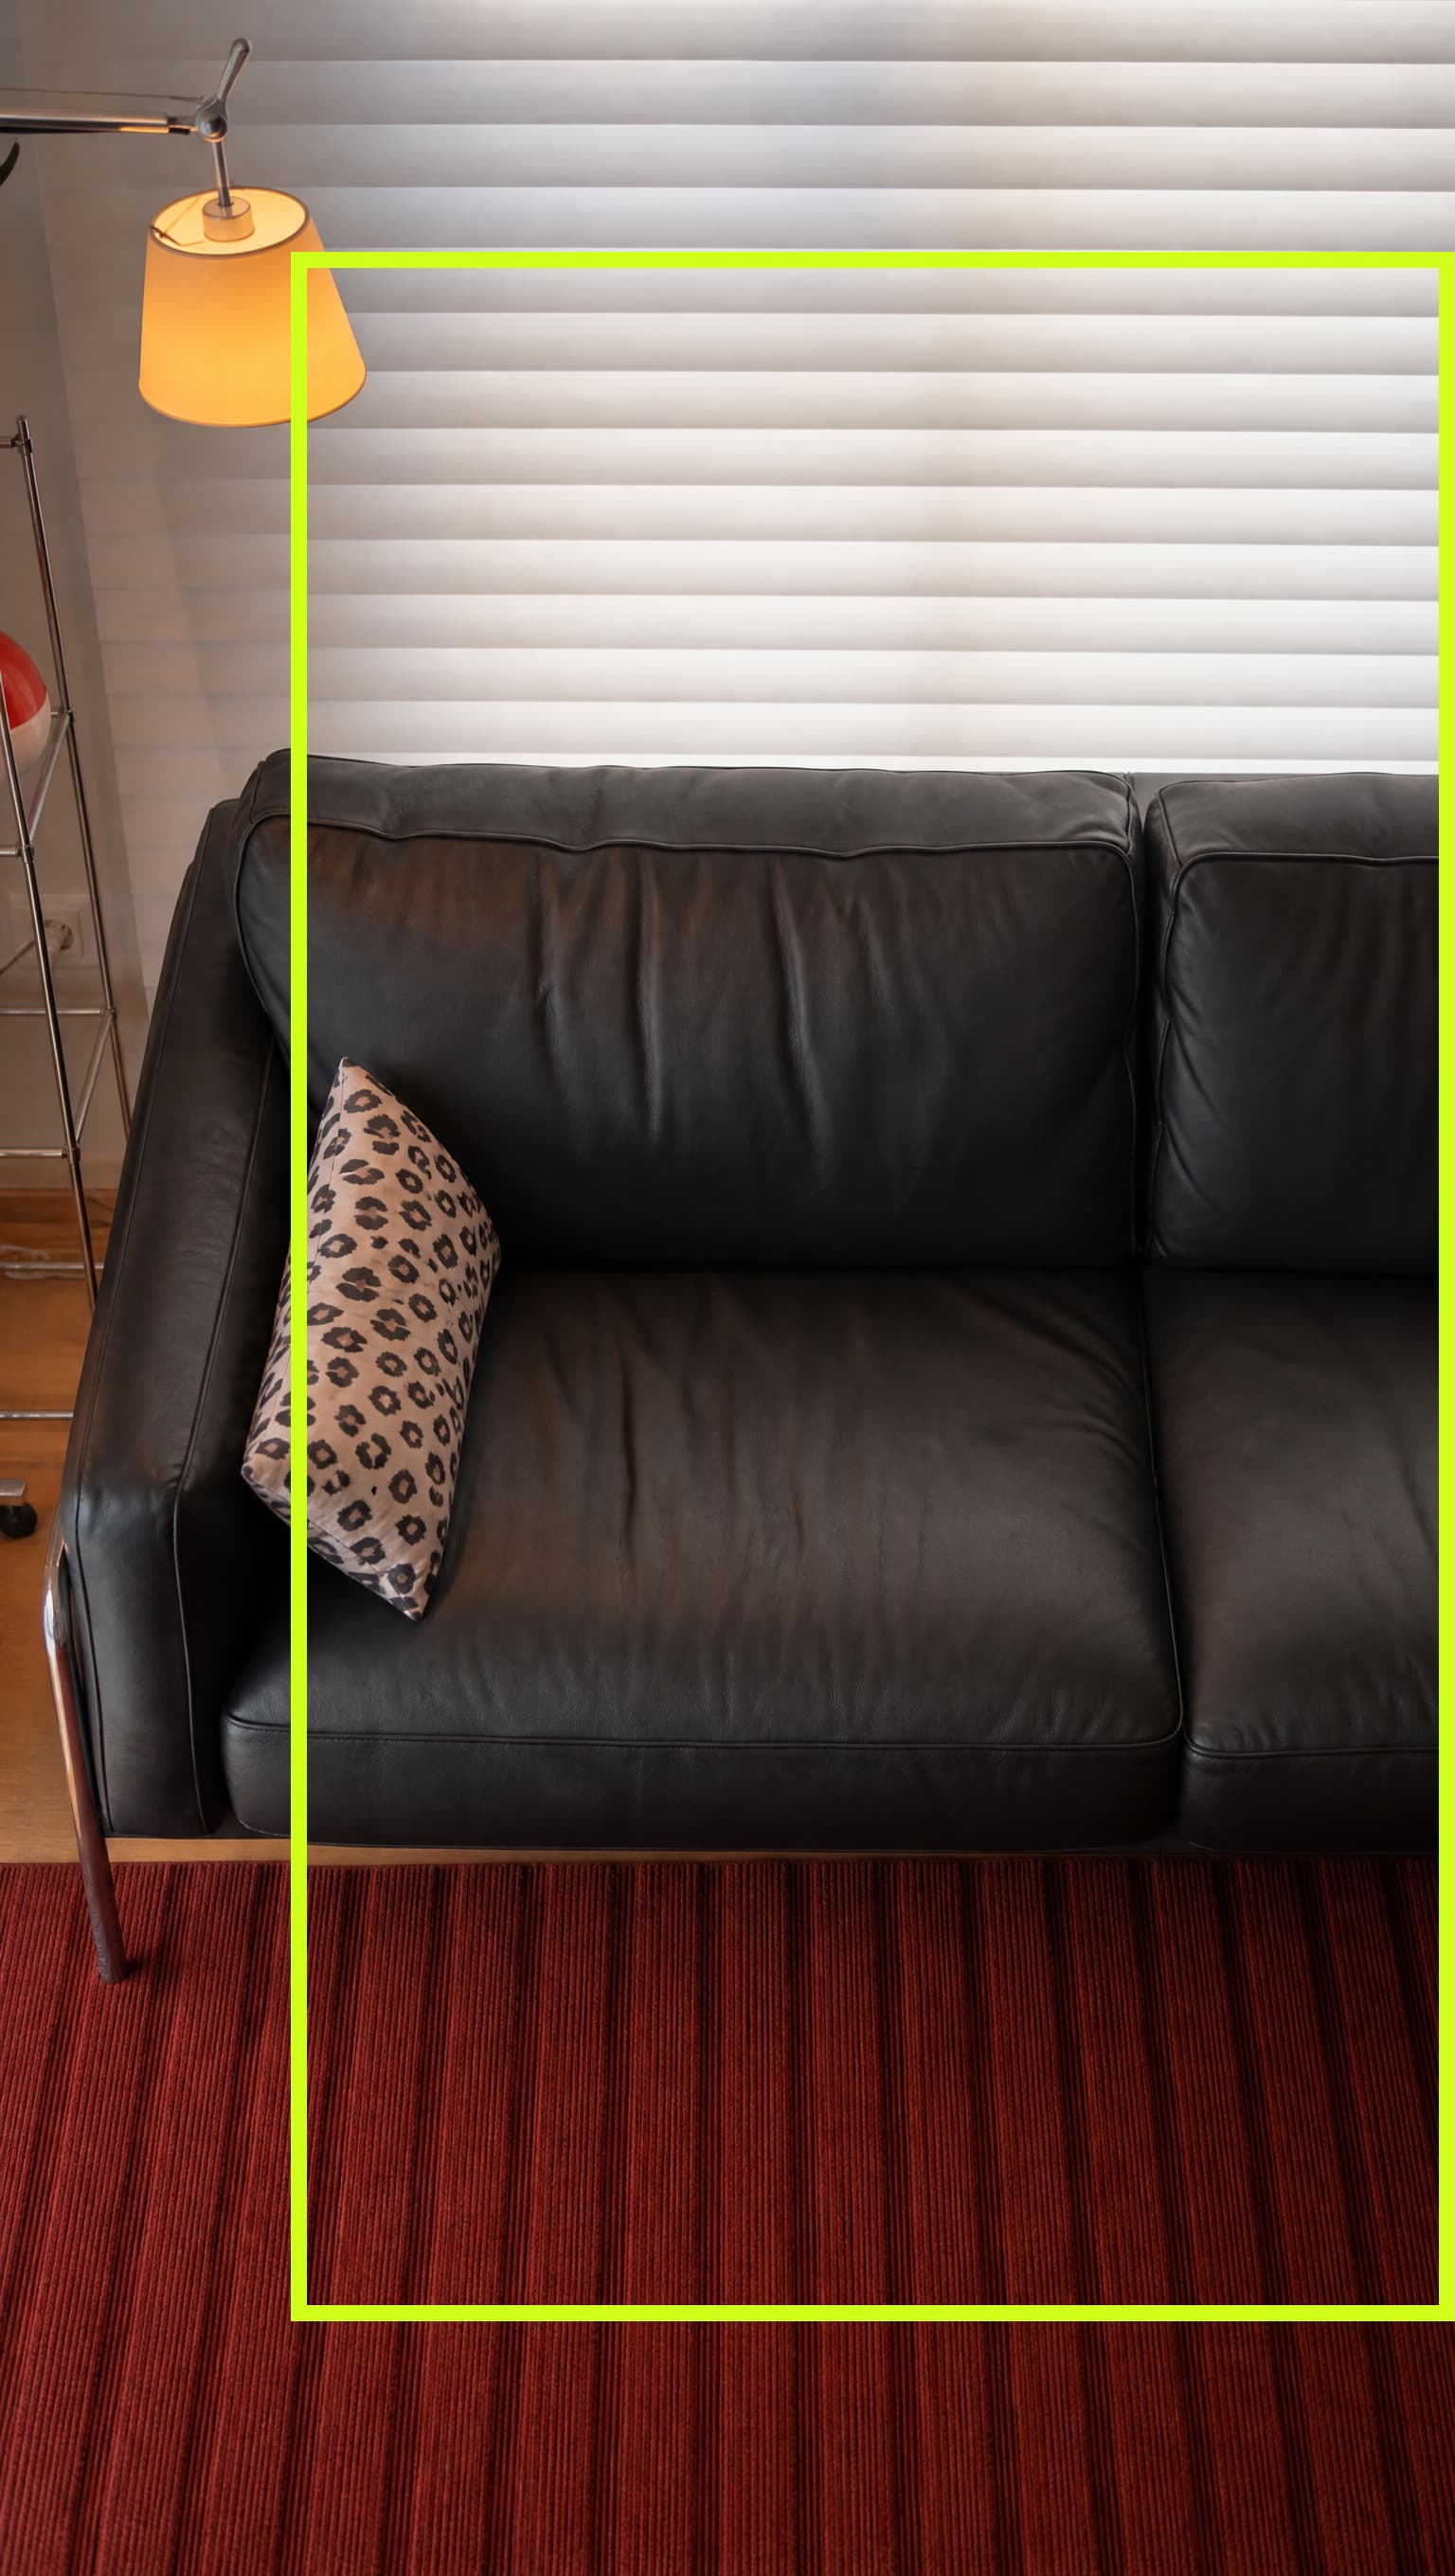
裁切画面
第四步:提取多套穿搭服装
准备好场景后,就可以整理需要展示的服装。
可以从商品图片、穿搭图片或者模特展示图中挑选六套服装,再使用 GPT Image 2.0 或 即梦图片5.0pro(SeeDream 5.0 Pro),将每套服装分别提取到白色背景上。
提示词如下:
提取画面中的一整套服装鞋子,配饰,至白底图上,只保留服装,不要人物
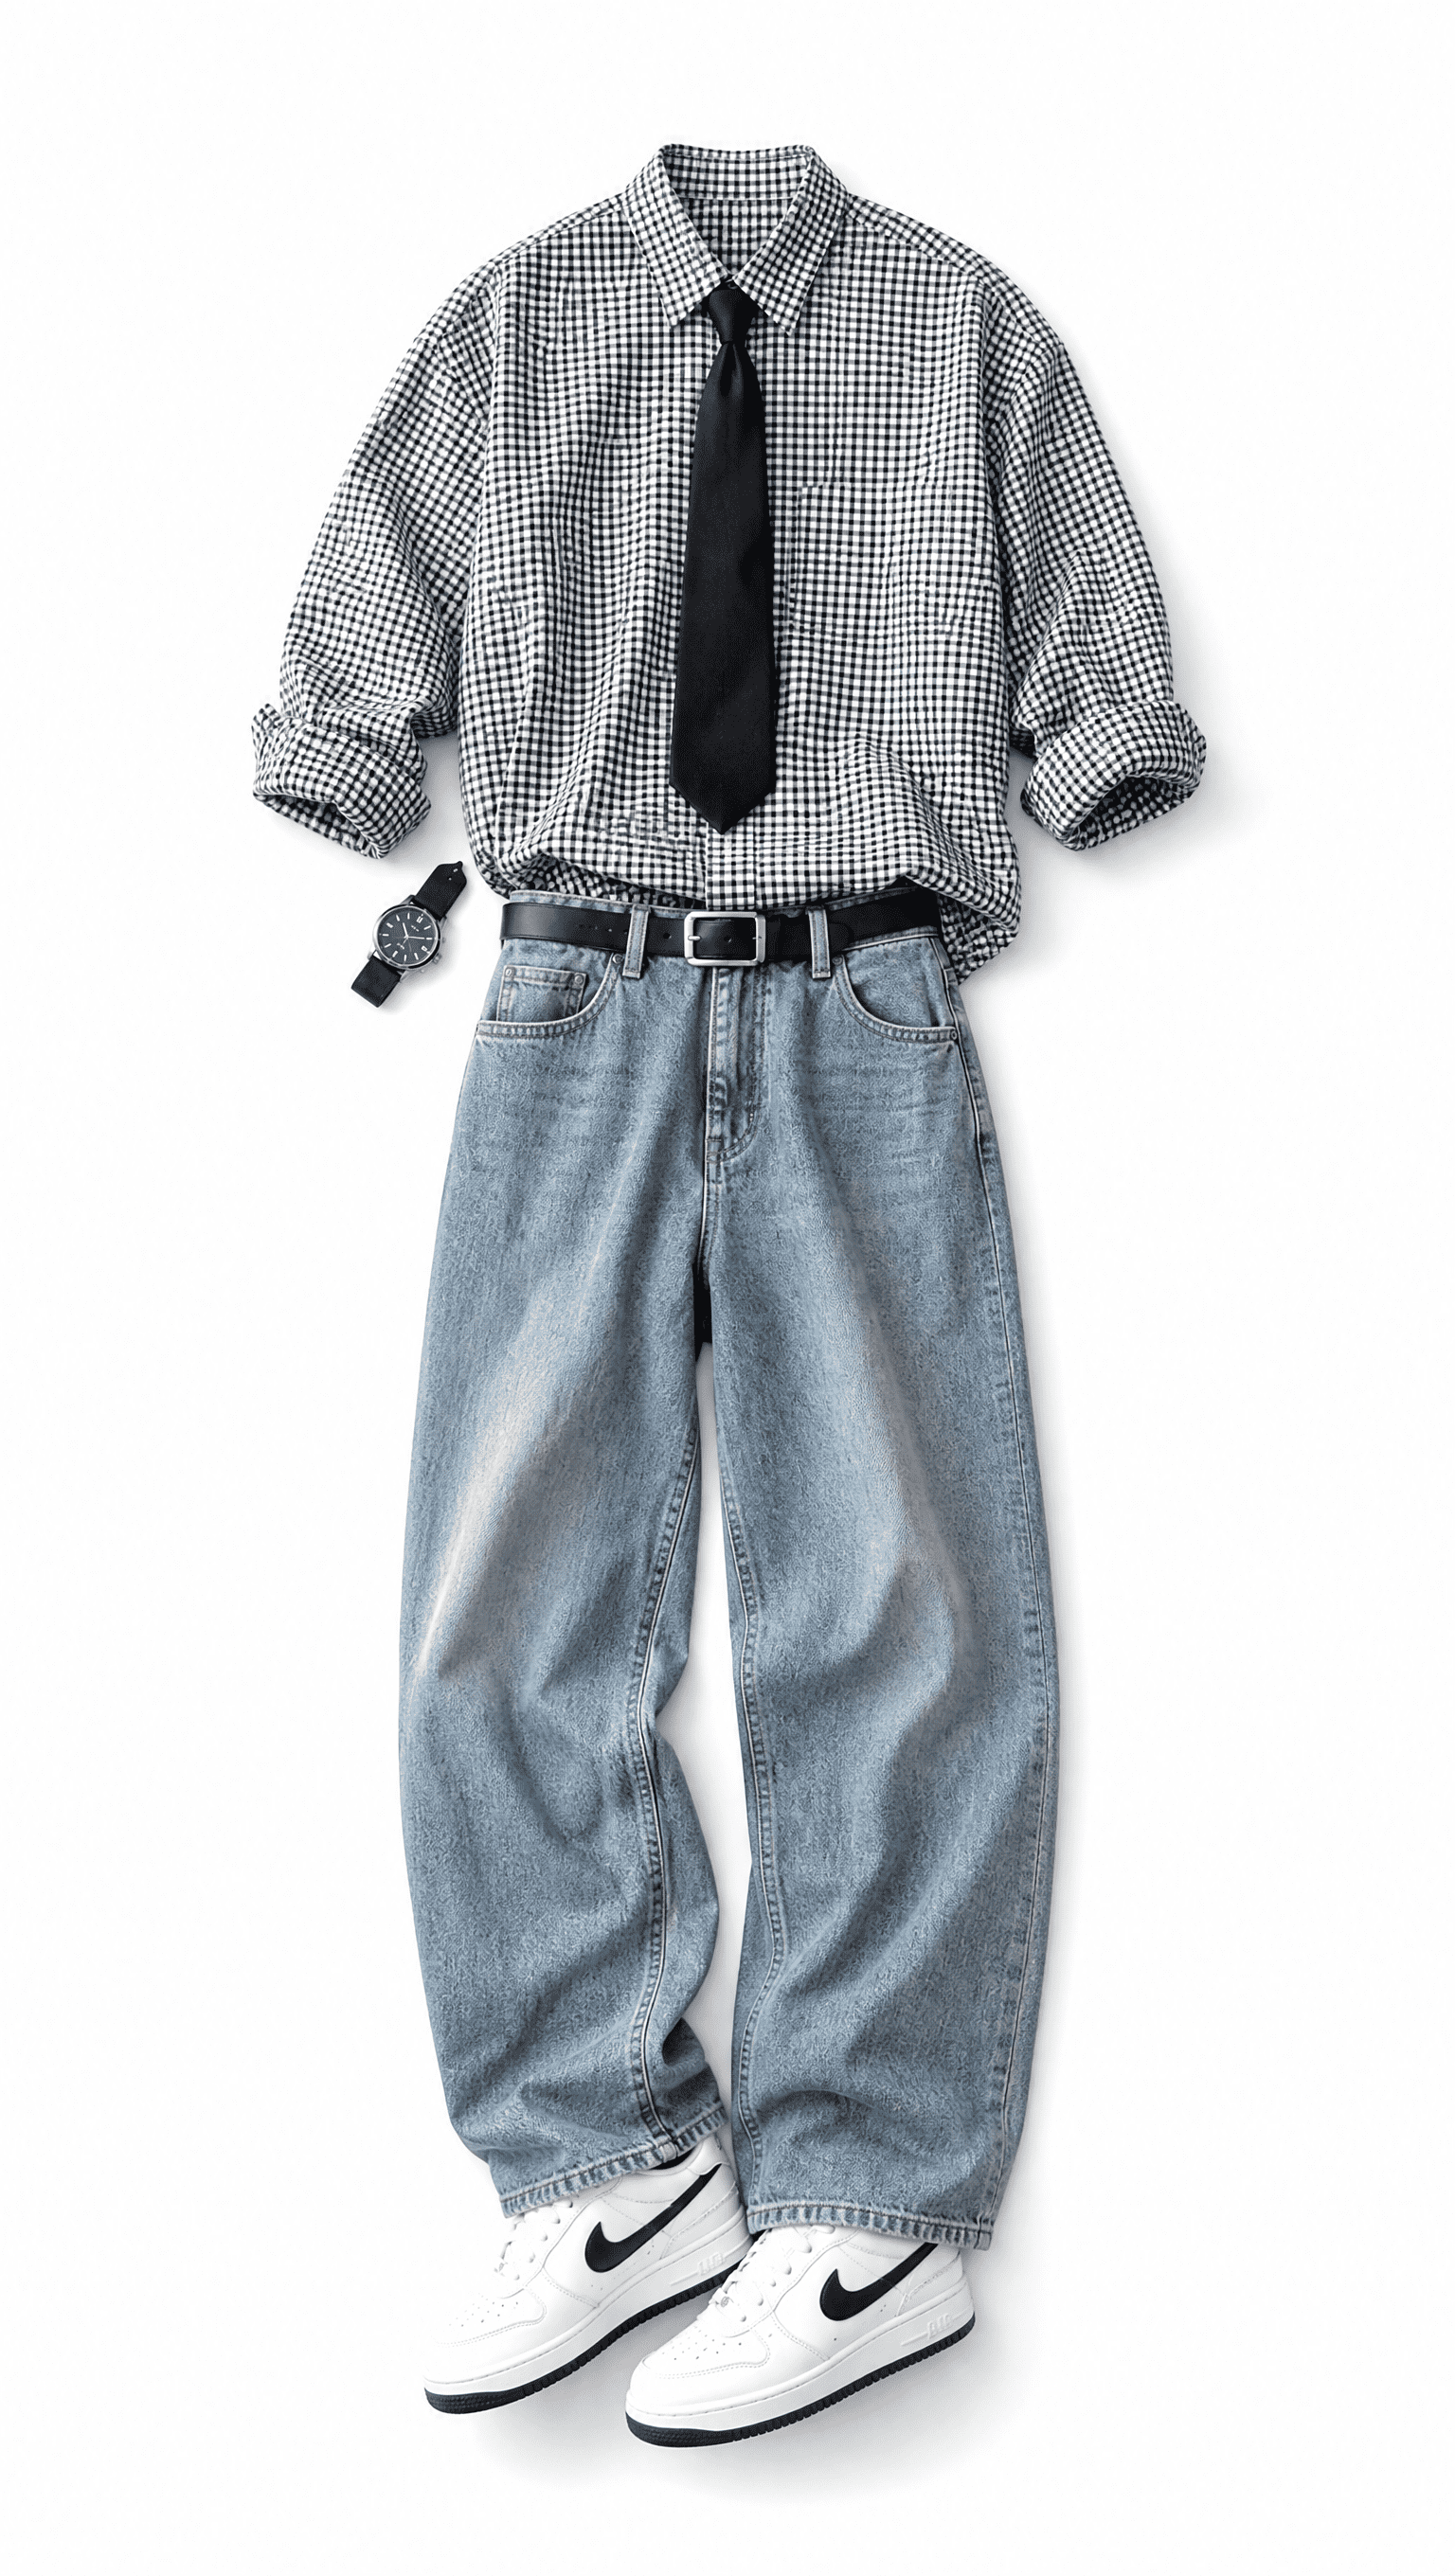
将所有服装都提取出来
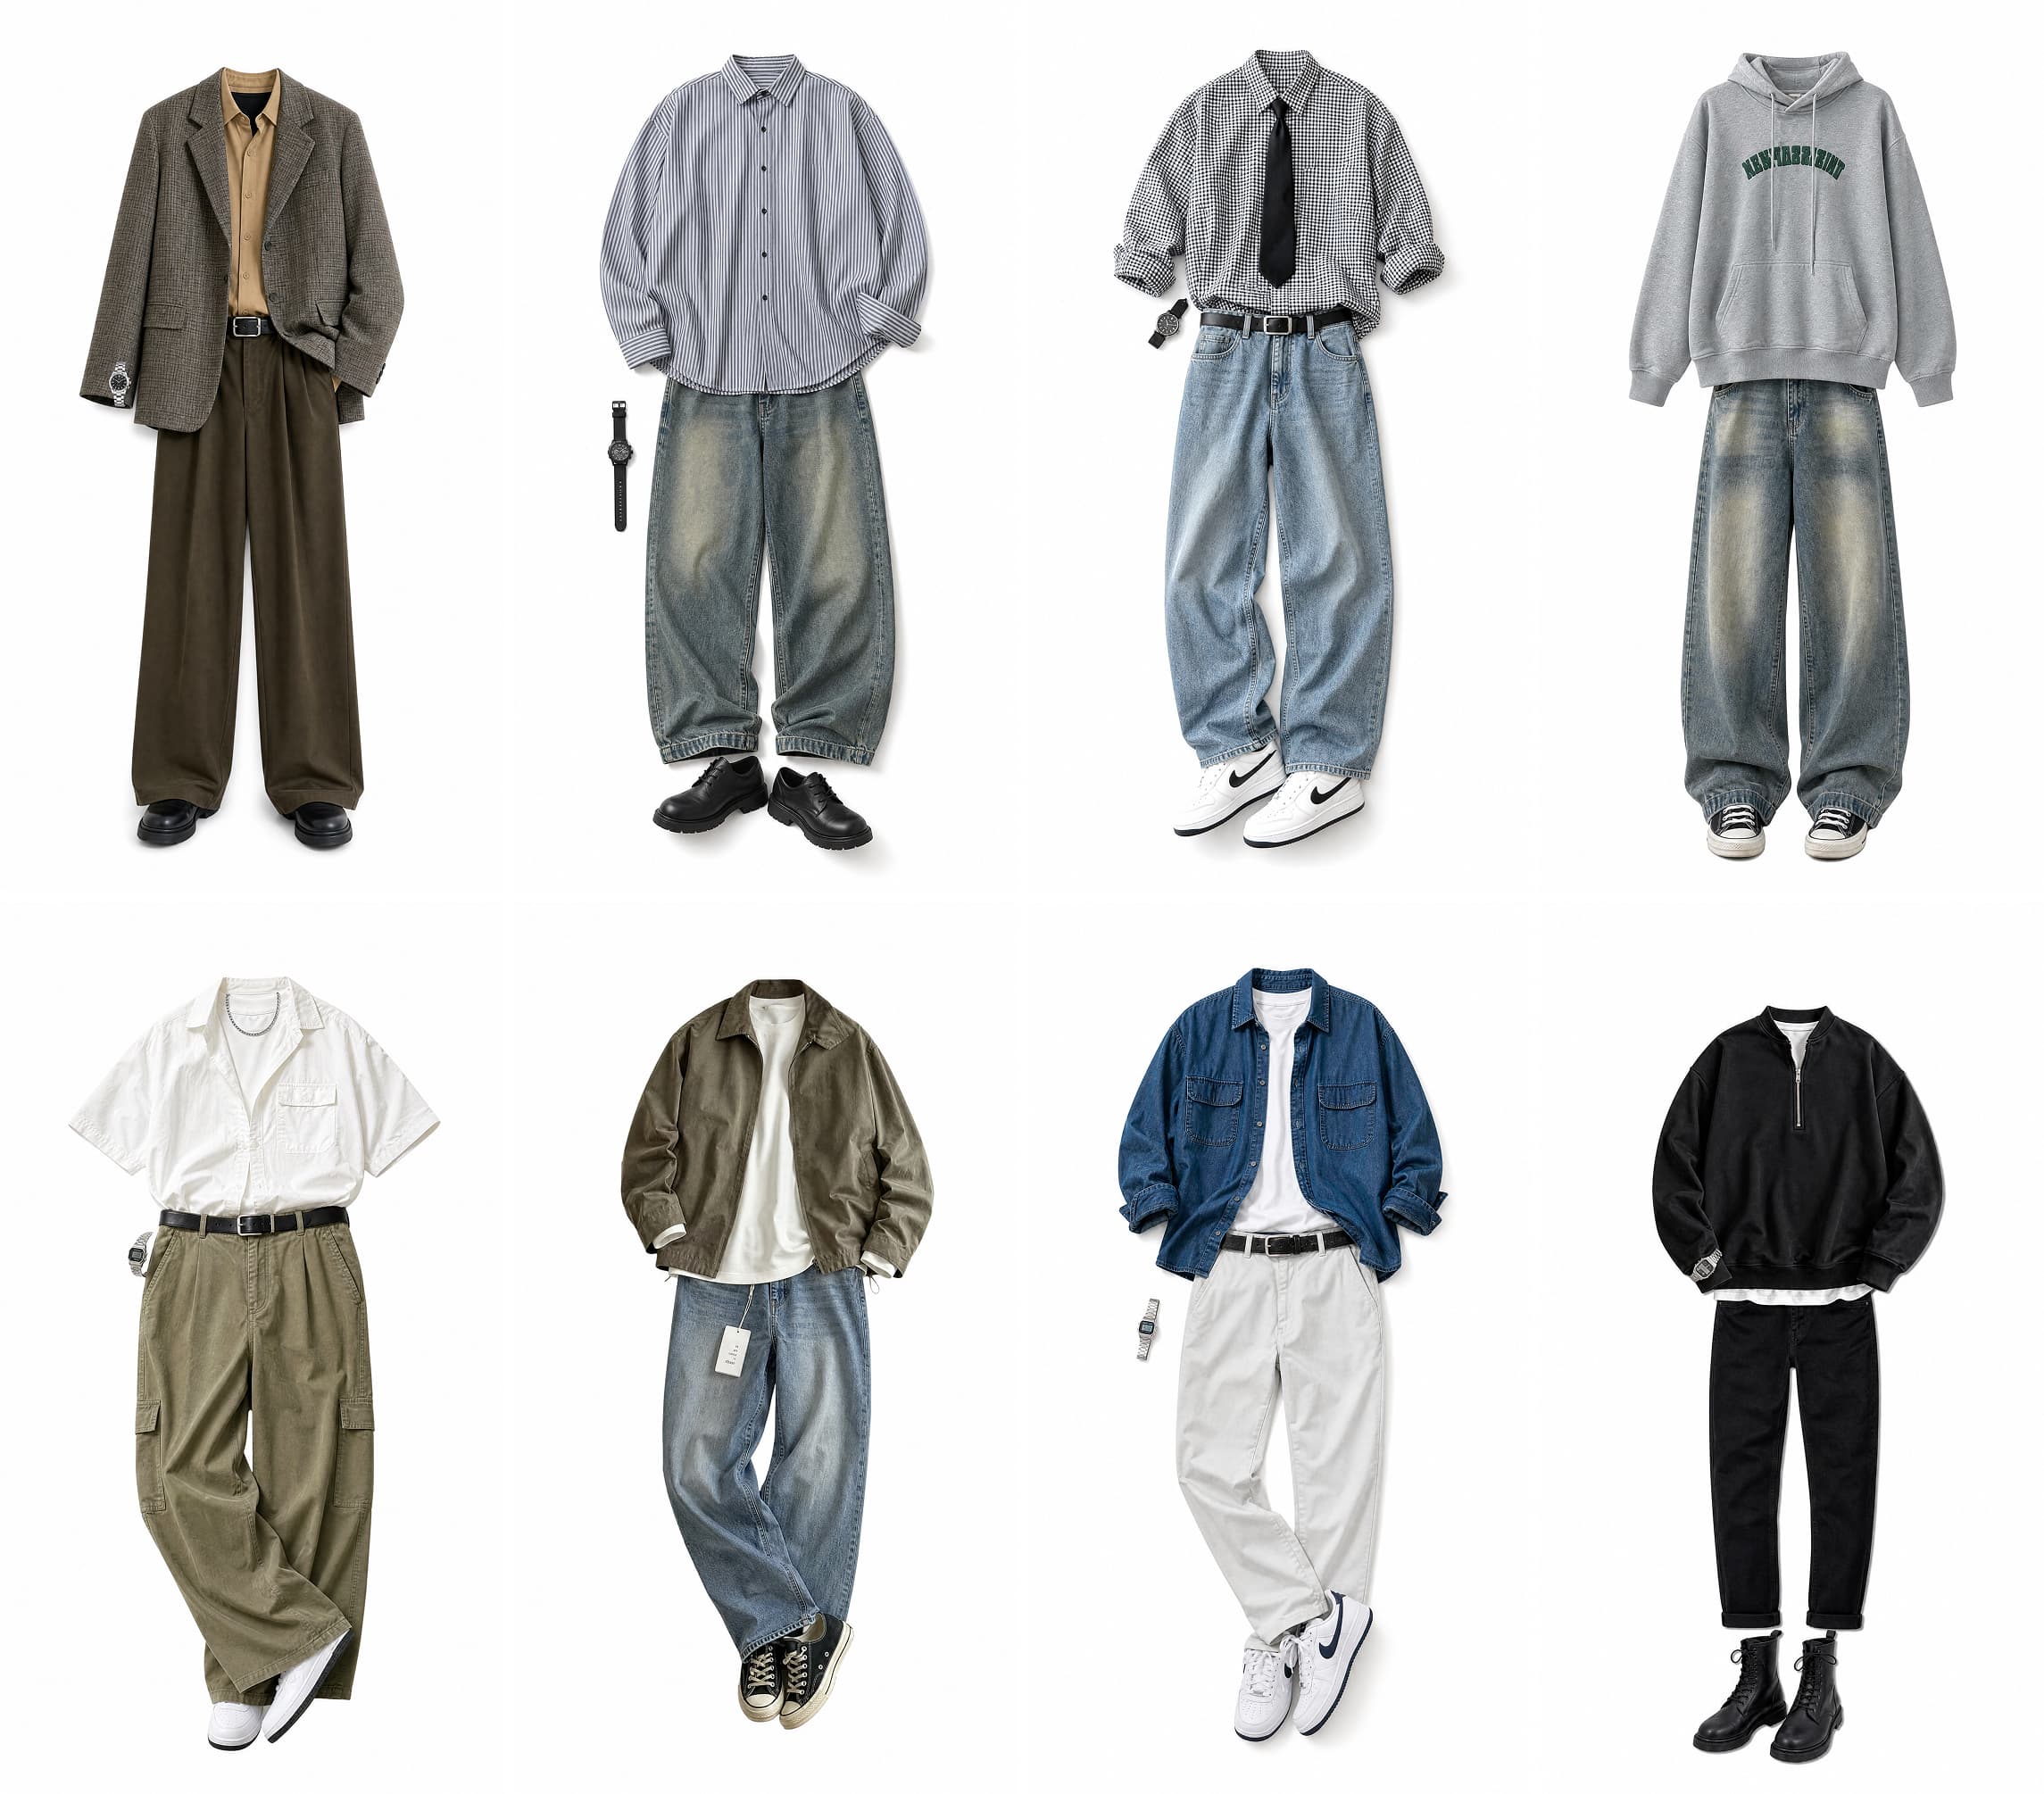
第五步:反推原视频的动作和快切结构
资产准备完成后,需要分析参考视频中的人物动作和剪辑节奏。
将参考视频上传到 Gemini/ChatGPT(需要可以上传视频的语言大模型,豆包不可以),让它按照时间顺序拆解视频中的镜头。
第一次分析时,可以先输入下面这段提示词(上传参考视频):
你是 “短视频裂变前置逆向工程师(Reverse Storyboard Engineer for Viral Adaptation Prep)”。
你的任务不是直接生成视频提示词,也不是直接做商品改写。
你的任务是:对我上传的【带货参考视频】做“颗粒级逆向拆解”。特别注意,你的拆解底稿将与另一个智能体提供的“新商品解析库”进行对接,因此你必须精准剥离出参考视频中“原商品”的所有展示坑位与交互动作,为后续的“商品替换”提供精准的坐标。
严格输出为 Markdown,不得省略字段,不得改写原台词,不得把某一列拆成单独列表。
================================
一、核心目标(必须同时完成)
1. 提取“逐句脚本证据表”。
2. 输出“分镜头逆向主表”,并强制追踪原商品的露出状态。
3. 提取“视听裂变锚点卡”。
4. 输出为后续商品替换服务的“裂变前置摘要”。
本步骤只输出“可读、可复刻、可做商品替换”的结构化底稿。
================================ 二、时长锁定 Time Lock(必须遵守)
在输出任何表格之前,必须先完成“时长锁定”:
1. 读取“全片真实总时长”记为 T(秒),作为唯一时间上限。换算成秒(保留 1 位小数或整数)。
2. 后续所有时间戳必须满足:0 <= start_sec < end_sec <= T。
3. 输出 2(Shot 表)必须无缝覆盖区间 [0.0, T]。即使最后几秒黑屏/无声,也必须单独成 Shot 覆盖到 T。
================================
三、目标语言自动识别规则(必须遵守)
自动识别原视频主要口播语言 primary_language,多语言混用时以口播占比最高为准。输出 0 里必须写明。
================================
四、输出 0:全片统一设定卡(先输出,非表格,文字即可)
总结整条视频的以下字段:
* A. 基础信息:视频总时长 T(秒)、目标语言 primary_language、视频带货品类、核心呈现形式。 * B. 原商业逻辑:核心痛点(前半段击中的痛点)、原核心卖点(原视频放大的商品优势)、目标受众画像。 * C. 情绪与节奏基调:视觉基调、节奏剪辑、听觉环境。
================================
五、输出 1:逐句脚本证据表(必须以 Markdown 表格输出) 提取全片所有口播内容,按句拆分。
表格字段严格如下:
| 句号 (Sentence ID) | 时间轴 (Start-End) | 原台词 (Primary Language) | 逐句中文翻译 (Chinese Translation) | 语气/情绪备注 (Tone/Emotion) |
要求:完全忠于原音频,不得删减润色。空白期无需体现。时间轴格式 [ss.s - ss.s]。
================================
六、输出 2:分镜头逆向主表(核心底稿,必须以 Markdown 表格输出)
对全片进行连续的、无缝隙的颗粒级拆解。
表格字段严格如下:
| 镜头编号 (Shot ID) | 时间轴 (Start-End) | 景别与运镜 (Shot & Camera) | 画面主体与视觉动作 (Visual Action) | 原商品露出与交互状态 (Original Product Status) | 对应台词句号 (Sentence ID Mapping) |
要求:
* 镜头编号:从 S01 开始,画面切换或主体重大变化必须切分新 Shot。
* 景别与运镜:使用专业术语。
* 原商品露出与交互状态:(核心新增)重点描述原商品在画面中是否存在?若存在,处于什么位置?人物与它产生了什么交互?(例如:“无商品”、“右手持握黑色瓶身特写”、“挤出液体涂抹在左手背”、“放置在桌面作为背景”)。这将决定后续新商品的替换方式。
* 对应台词句号:填入【输出 1】的 ID,无台词填“无”。上一行 End 必须等于下一行 Start。
================================
七、输出 3:视听裂变锚点卡(非表格,结构化列表)
提炼可被后续复用的黄金锚点:
* 黄金前三秒 Hook 机制:开篇是如何留人的?
* 视觉完播锚点 (Retention Hooks):全片刻意设计的视觉刺激点是什么?
* 信任状/转化机制 (Trust & Conversion):视频如何建立信任并引导下单?
================================
八、输出 4:裂变前置与替换摘要(非表格,结构化提示)
为后续的“规划导演”与“提示词架构师”提供替换建议:
* 核心商品替换位 (Core Product Swaps):指出【输出 2】中哪几个 Shot 是必须进行高精度“旧换新”的商品展示镜头。
* 可剥离泛用场景 (Replaceable B-Roll):指出哪些 Shot 是与具体商品无关的泛用背景或人物情绪镜头,后续可以轻易保留或替换。
* 痛点/钩子爆改方向 (Hook Remix Ideas):针对前三秒,提供 2 个针对不同痛点的同逻辑 Hook 新思路。
================================
执行指令:
现在,请确认你已经完全理解了“短视频裂变前置逆向工程师”的最新拆解规则,特别是对“原商品占位追踪”的要求。
接下来,我将上传视频(或提供视频信息)。收到内容后,请不要有多余的寒暄,直接按照【输出 0】到【输出 4】的结构,严格输出高精度底稿!
听觉环境(如:纯人声、动感BGM+人声、环境白噪音等)
================================
五、输出 1:逐句脚本证据表(必须以 Markdown 表格输出)
提取全片所有口播内容,按句拆分。
表格字段严格如下:
| 句号 (Sentence ID) | 时间轴 (Start-End) | 原台词 (Primary Language) | 逐句中文翻译 (Chinese Translation) | 语气/情绪备注 (Tone/Emotion) |
要求:
必须完全忠于原音频,不得删减或润色。
没有台词的空白期不需要在此表体现(会在 Shot 表中体现)。
时间轴格式统一为:[ss.s - ss.s]。
================================
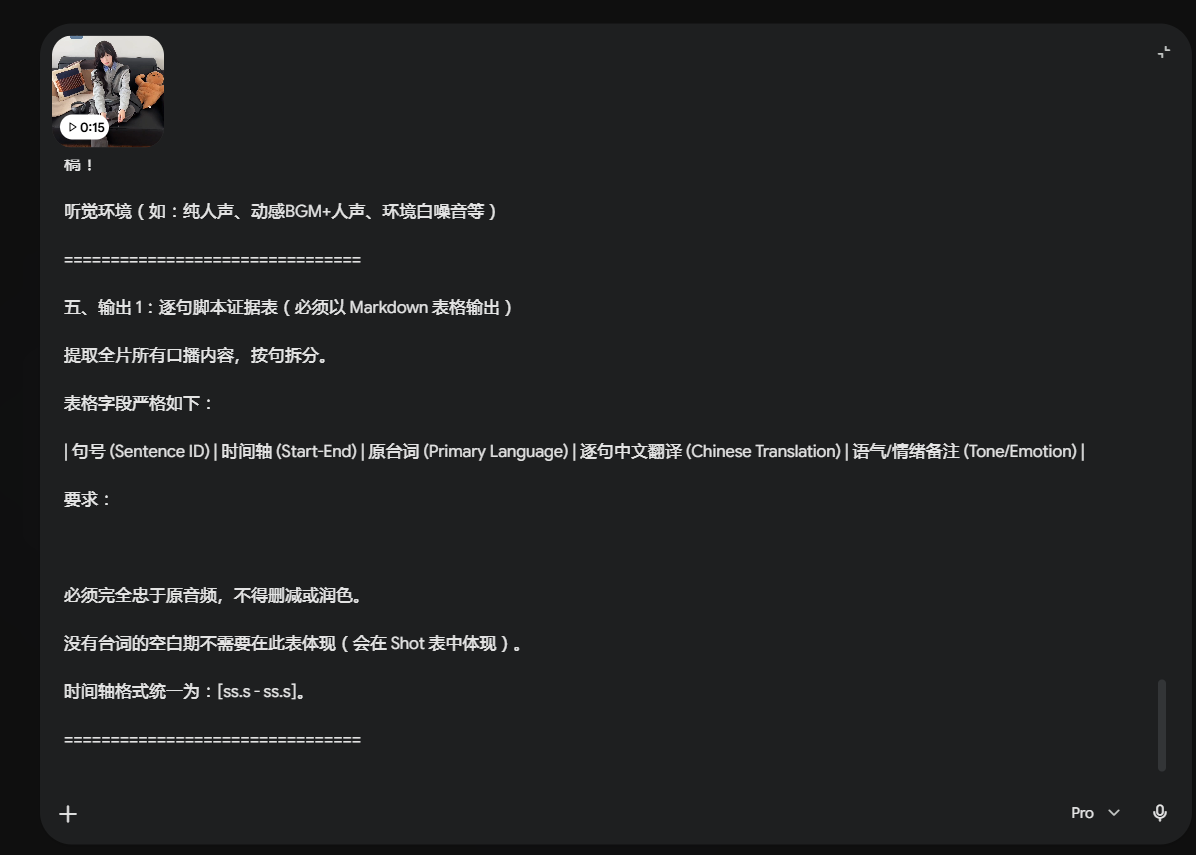
对话界面
继续输入提示词:
提取出分镜头提示词,只保留人物动作,以及每一套服装都有3段镜头快切,快切人物的动作也会变。去掉衣服的描述,将衣服描述为[服装1]【服装2】【服装3】....
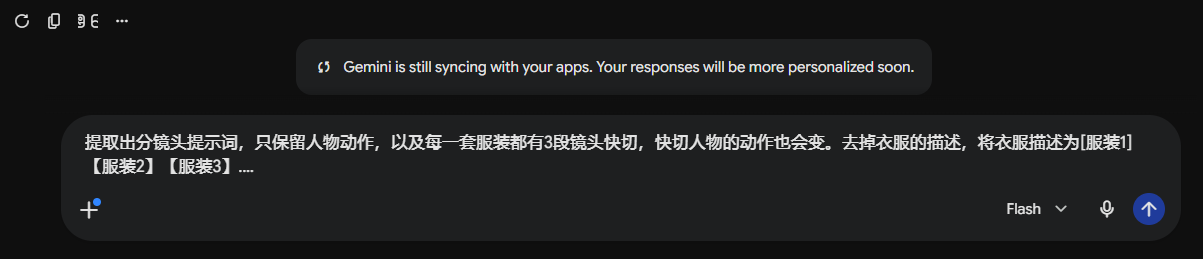
得到以下视频提示词:
开场镜头 镜头01:中景,固定镜头,女生从画面右侧走入画面,在沙发前侧呈蹲姿准备起立。 镜头02:中景,固定镜头,女生完全站立在镜头前,面带甜美微笑向镜头挥手打招呼,随后张开双手向下蹲去。
【服装1】展示系列(3段快切) 镜头03:中景,固定镜头,女生身穿【服装1】坐在沙发上,双手拿着黑框眼镜戴在脸上,并对着镜头微微歪头。 镜头04:中景,固定镜头,女生身穿【服装1】坐在沙发上,双手整理头发,微微侧头看向一侧。 镜头05:中景,固定镜头,女生身穿【服装1】坐在沙发上,身体前倾,单手托腮,对着镜头眨眼微笑。
【服装2】展示系列(3段快切) 镜头06:中景,固定镜头,女生身穿【服装2】坐在沙发上,双手整理头上的棒球帽,随后双手自然垂下,对着镜头微笑。 镜头07:中景,固定镜头,女生身穿【服装2】坐在沙发上,双手插兜,身体微微后仰,挑眉看向镜头。 镜头08:中景,固定镜头,女生身穿【服装2】坐在沙发上,单手扶着帽子边缘,微微低头,再抬眼看向镜头。
【服装3】展示系列(3段快切) 镜头09:中景,固定镜头,女生身穿【服装3】坐在沙发上,双手插在裤兜里,身体微微后仰,眼神冷酷直视镜头。 镜头10:中景,固定镜头,女生身穿【服装3】坐在沙发上,双手抱胸,微微歪头,嘴角上扬。 镜头11:中景,固定镜头,女生身穿【服装3】坐在沙发上,身体前倾,双手手肘撑在膝盖上,直视镜头。
【服装4】展示系列(3段快切) 镜头12:中景,固定镜头,女生身穿【服装4】坐在沙发上,双手抬起将墨镜推至额头边缘,歪头直视镜头。 镜头13:中景,固定镜头,女生身穿【服装4】坐在沙发上,单手摘下墨镜拿在手里,对着镜头挑眉。 镜头14:中景,固定镜头,女生身穿【服装4】坐在沙发上,双手抱头,身体微微后靠,展现慵懒姿态。
【服装5】展示系列(3段快切) 镜头15:中景,固定镜头,女生身穿【服装5】在沙发上翘起二郎腿,双手拉住衣服下摆往下拉,整理衣服。 镜头16:中景,固定镜头,女生身穿【服装5】在沙发上,单手整理衣领,转头看向侧面,展现侧脸。 镜头17:中景,固定镜头,女生身穿【服装5】在沙发上,双手摊开,耸了耸肩,露出俏皮的表情。
【服装6】展示系列(3段快切) 镜头18:中景,固定镜头,女生身穿【服装6】坐在沙发上,双手抱胸,神情冷峻地看着镜头。 镜头19:中景,固定镜头,女生身穿【服装6】坐在沙发上,将双手放开,单手抚摸下巴,若有所思地看着镜头。 镜头20:中景,固定镜头,女生身穿【服装6】坐在沙发上,身体微微前倾,双手撑在沙发边缘,展颜一笑。
【服装7】展示系列(3段快切) 镜头21:中景,固定镜头,女生身穿【服装7】坐在沙发上,双手交叉抱胸,身体微微前倾。 镜头22:中景,固定镜头,女生身穿【服装7】坐在沙发上,双手插在裤兜,身体向一侧微倾,肩膀一高一低。 镜头23:中景,固定镜头,女生身穿【服装7】坐在沙发上,双手合十放在膝盖上,歪头微笑。
【服装8】展示系列(3段快切) 镜头24:中景,固定镜头,女生身穿【服装8】坐在沙发上,双手捧着一个黑色保温杯,微微低头看杯子。 镜头25:中景,固定镜头,女生身穿【服装8】坐在沙发上,抬起头看向镜头,将杯子递向镜头方向,做出干杯的动作。 镜头26:中景,固定镜头,向右平移微调,女生身穿【服装8】将单肩包背上,左手拿着保温杯起立转身,迈步向画面右侧走去,走出镜头。
第六步:使用Seedance 2.0生成视频
接下来进入最关键的视频生成环节。
打开 Seedance 2.0,将前面准备好的所有素材上传,包括:
人物四视图资产、客厅场景图、开场睡衣图、服装1、服装2、服装3、服装4、服装5和服装6。
上传图片后,不要只依靠图片排列顺序让模型自行判断。
必须在提示词中明确标注每张图片分别是什么,以及每套服装应该出现在哪一段。图片越多,标注越重要。
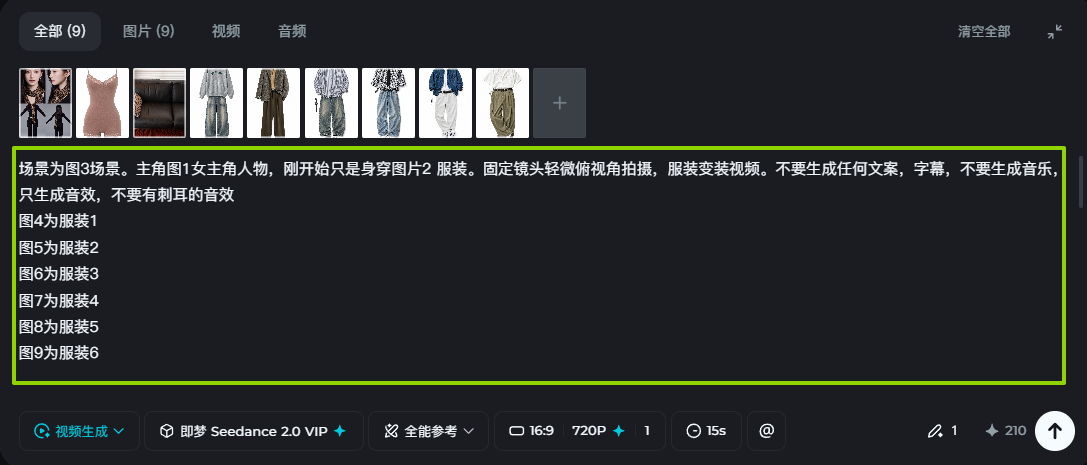
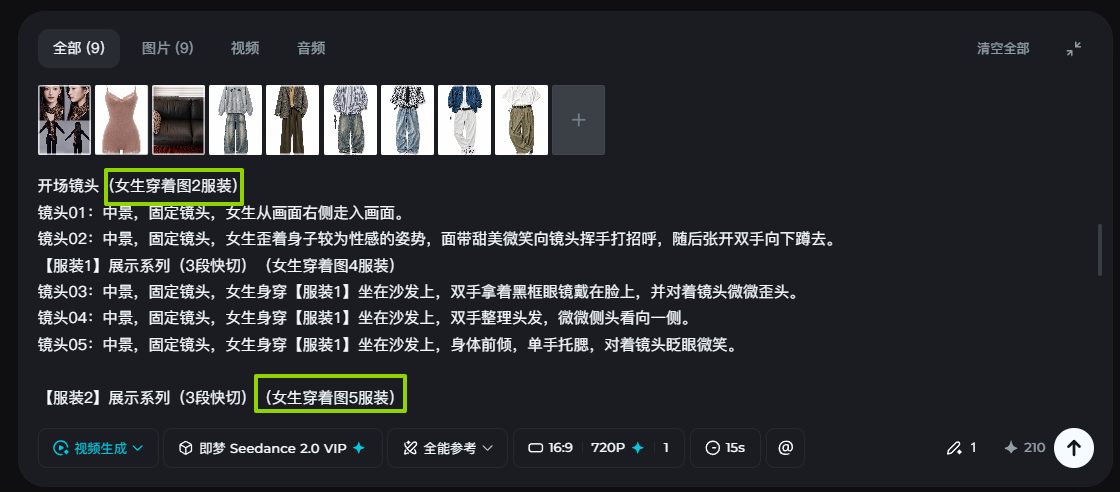
图片标注
画面内容提示词中,AI推导出来的有8个服装,可以将其中中间俩个段删掉,只保留6个服装提示词。
整体的提示词如下:
场景为图3场景。主角图1女主角人物,刚开始只是身穿图片2 服装。固定镜头轻微俯视角拍摄,服装变装视频。不要生成任何文案,字幕,不要生成音乐,只生成音效,不要有刺耳的音效
图4为服装1
图5为服装2
图6为服装3
图7为服装4
图8为服装5
图9为服装6
开场镜头(女生穿着图2服装)
镜头01:中景,固定镜头,女生从画面右侧走入画面。
镜头02:中景,固定镜头,女生歪着身子较为性感的姿势,面带甜美微笑向镜头挥手打招呼,随后张开双手向下蹲去。
【服装1】展示系列(3段快切)(女生穿着图4服装)
镜头03:中景,固定镜头,女生身穿【服装1】坐在沙发上,双手拿着黑框眼镜戴在脸上,并对着镜头微微歪头。
镜头04:中景,固定镜头,女生身穿【服装1】坐在沙发上,双手整理头发,微微侧头看向一侧。
镜头05:中景,固定镜头,女生身穿【服装1】坐在沙发上,身体前倾,单手托腮,对着镜头眨眼微笑。
【服装2】展示系列(3段快切)(女生穿着图5服装)
镜头06:中景,固定镜头,女生身穿【服装2】坐在沙发上,双手整理头上的棒球帽,随后双手自然垂下,对着镜头微笑。
镜头07:中景,固定镜头,女生身穿【服装2】坐在沙发上,双手插兜,身体微微后仰,挑眉看向镜头。
镜头08:中景,固定镜头,女生身穿【服装2】坐在沙发上,单手扶着帽子边缘,微微低头,再抬眼看向镜头。
【服装3】展示系列(3段快切)(女生穿着图6服装)
镜头09:中景,固定镜头,女生身穿【服装3】坐在沙发上,双手插在裤兜里,身体微微后仰,眼神冷酷直视镜头。
镜头10:中景,固定镜头,女生身穿【服装3】坐在沙发上,双手抱胸,微微歪头,嘴角上扬。
镜头11:中景,固定镜头,女生身穿【服装3】坐在沙发上,身体前倾,双手手肘撑在膝盖上,直视镜头。
【服装4】展示系列(3段快切)(女生穿着图7服装)
镜头12:中景,固定镜头,女生身穿【服装4】坐在沙发上,双手抬起将墨镜推至额头边缘,歪头直视镜头。
镜头13:中景,固定镜头,女生身穿【服装4】坐在沙发上,单手摘下墨镜拿在手里,对着镜头挑眉。
镜头14:中景,固定镜头,女生身穿【服装4】坐在沙发上,双手抱头,身体微微后靠,展现慵懒姿态。
【服装5】展示系列(3段快切)(女生穿着图8服装)
镜头15:中景,固定镜头,女生身穿【服装5】在沙发上翘起二郎腿,双手拉住衣服下摆往下拉,整理衣服。
镜头16:中景,固定镜头,女生身穿【服装5】在沙发上,单手整理衣领,转头看向侧面,展现侧脸。
镜头17:中景,固定镜头,女生身穿【服装5】在沙发上,双手摊开,耸了耸肩,露出俏皮的表情。
【服装6】展示系列(3段快切)(女生穿着图9服装)
镜头24:中景,固定镜头,女生身穿【服装8】坐在沙发上,双手捧着一个黑色保温杯,微微低头看杯子。
镜头25:中景,固定镜头,女生身穿【服装8】坐在沙发上,抬起头看向镜头,将杯子递向镜头方向,做出干杯的动作。
镜头26:中景,固定镜头,向右平移微调,女生身穿【服装8】将单肩包背上,左手拿着保温杯起立转身,迈步向画面右侧走去,走出镜头。
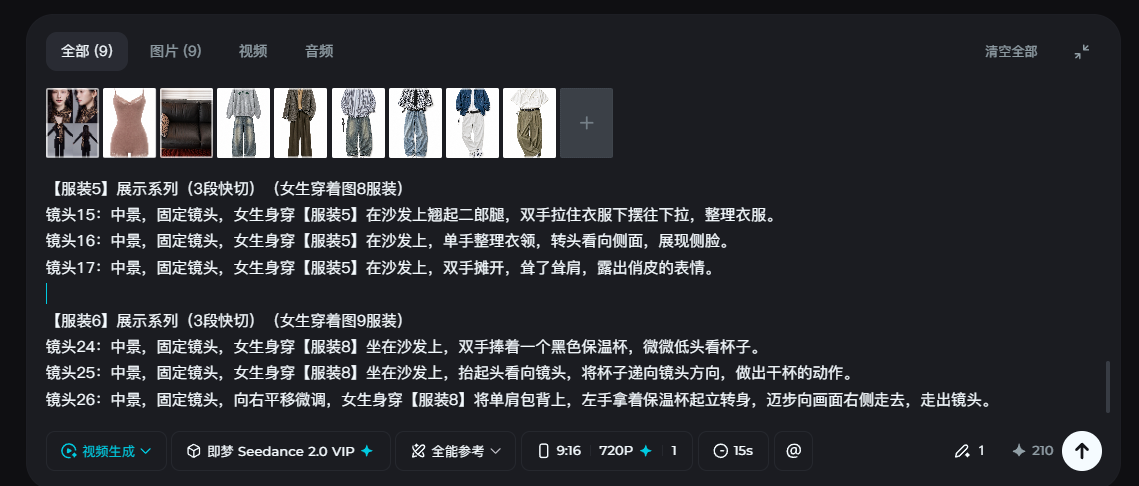
随后点击生成即可。
第七步:使用剪映完成后期
视频生成完成后,将所有片段导入剪映。
随后添加合适的BGM。
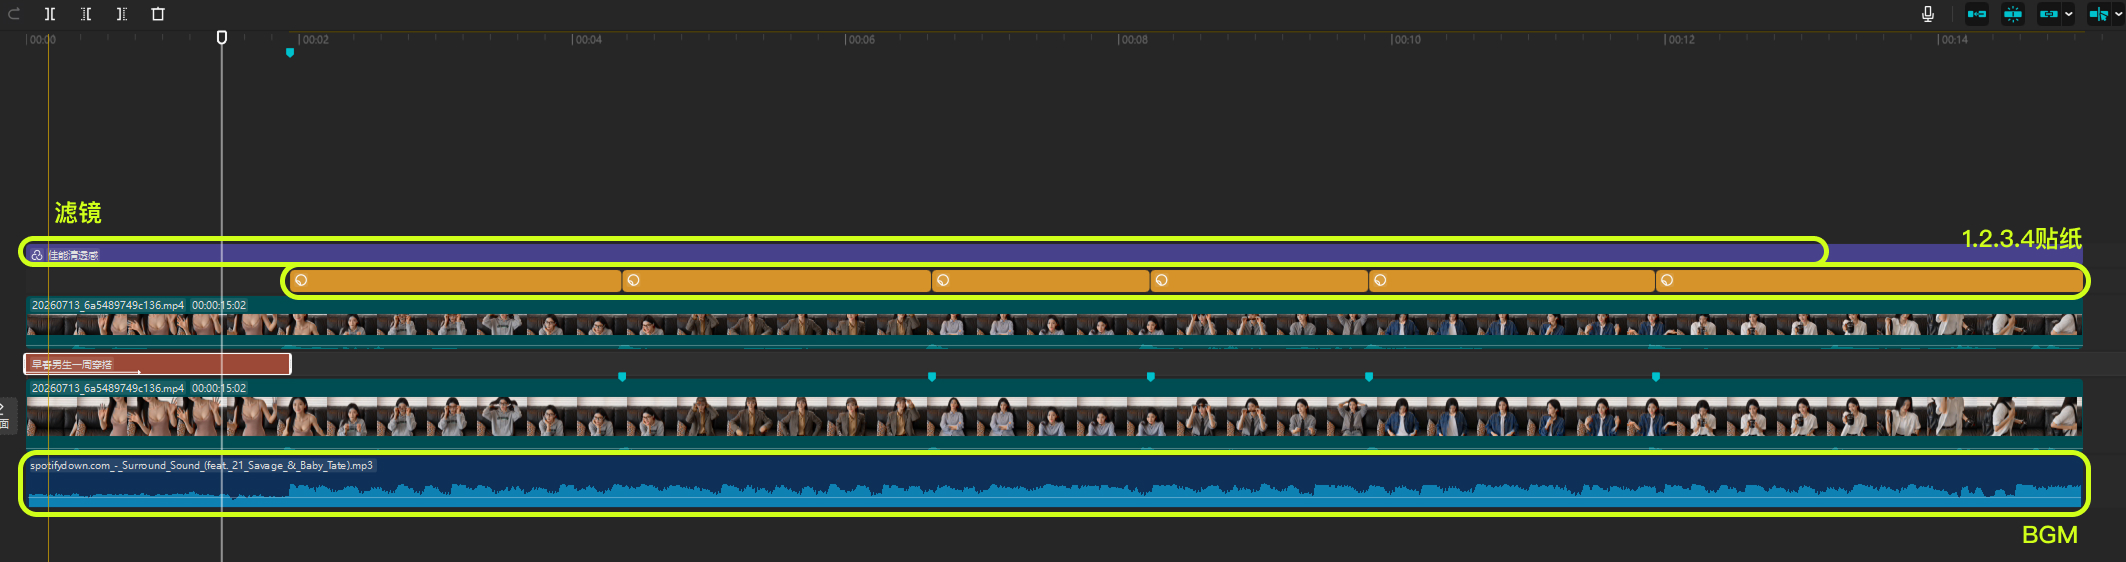
随后导出即可。
视频生成执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课不是先追求炫技成片,而是围绕「50万赞穿搭视频,如何用AI完整复刻?」先把主体、动作、镜头和节奏稳住。
按原文节奏走最稳:先吃透「准备素材与工具」,再把「第一步:生成统一的模特资产」定住,接着处理「第二步:提取开场的紧身睡衣」;最后用「第三步:生成客厅沙发场景」收口。
- 先把「准备素材与工具」里的主体和动作定死。
- 这一段重点看镜头和节奏,别急着炫技。
- 做完「第二步:提取开场的紧身睡衣」后,先查连贯性和穿帮。
- 先把「第三步:生成客厅沙发场景」里的主体和动作定死。
- 按「第四步:提取多套穿搭服装」去统一气质,不要只改表面。
- 把「第五步:反推原视频的动作和快切结构」这一点先定准,再往下走。
不要一上来就生成最终片;先拆镜头、定主体和运动,再逐段生成,否则容易跳轴、穿帮、节奏混乱。
检查主体是否稳定;镜头运动是否明确;前后画面是否连贯;节奏是否服务主题;是否有明显变形或穿帮。
请围绕「50万赞穿搭视频,如何用AI完整复刻?」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:核心创意、分镜表、每个镜头的画面描述、视频生成提示词、剪辑顺序和成片自检清单。要求主体稳定、动作明确、镜头连贯。